Обзор Lakehouse
Lakehouse представляет собой современное решение для больших данных, объединяющее преимущества озёр данных и хранилищ данных. Оно сочетает низкую стоимость и высокую масштабируемость озёр данных с высокой производительностью и развитыми возможностями управления данными, присущими хранилищам данных. Это обеспечивает эффективное и безопасное хранение, обработку и анализ разнообразных данных с контролем их качества в эпоху больших данных. Благодаря стандартным открытым форматам данных и управлению метаданными lakehouse объединяет данные реального времени и исторические данные, пакетную обработку и потоковую обработку, постепенно становясь новым стандартом корпоративных решений для больших данных.
Решение Lakehouse на базе Doris
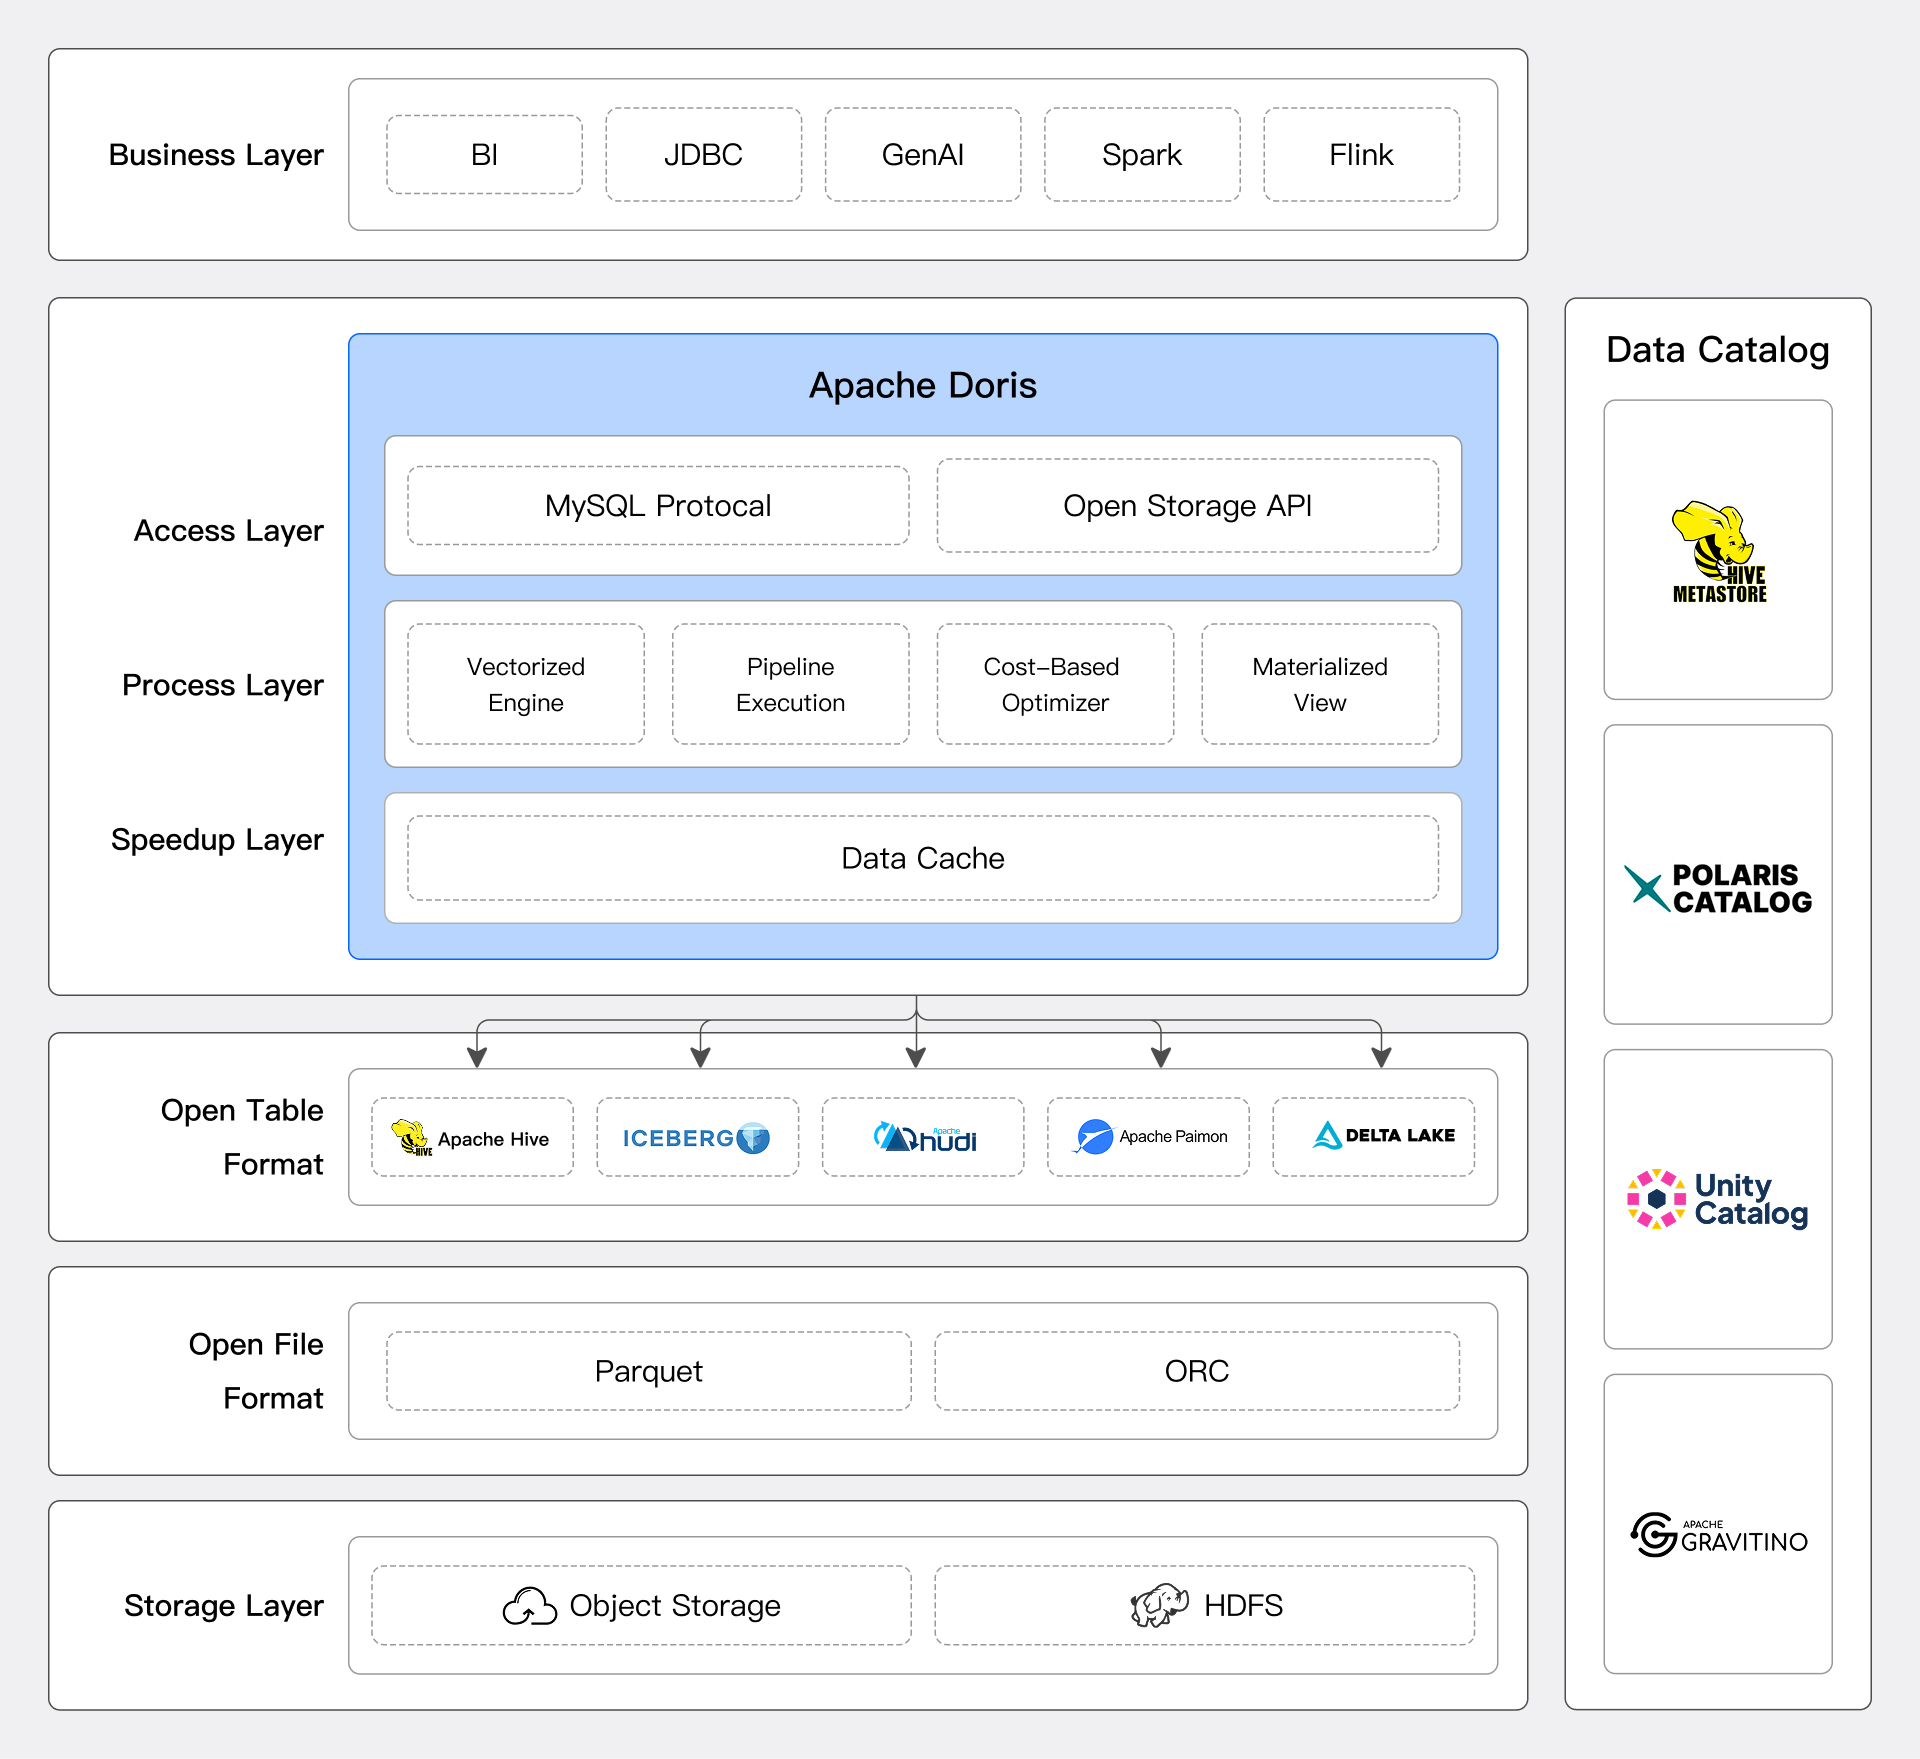
Doris предлагает пользователям эффективное решение lakehouse благодаря расширяемой инфраструктуре коннекторов, архитектуре с разделением вычислений и хранения, высокопроизводительному движку обработки данных и открытости для экосистемы данных.
Гибкий доступ к данным
Doris поддерживает доступ к распространённым системам и форматам данных через расширяемую инфраструктуру коннекторов и предоставляет единые возможности анализа на основе SQL. Пользователи могут легко выполнять запросы и анализировать данные на разных платформах без перемещения существующих данных. Подробнее см. в разделе Обзор Catalog.
Коннекторы источников данных
Doris легко подключается к Hive, Iceberg, Hudi, Paimon и системам баз данных с поддержкой протокола JDBC, обеспечивая эффективный доступ к данным.
При работе с системами lakehouse Doris может получать сведения о структуре и распределении данных в таблицах из служб метаданных, таких как Hive Metastore, AWS Glue и Unity Catalog, строить эффективные планы запросов и использовать архитектуру MPP для распределённых вычислений.
Подробнее см. в документации по соответствующему каталогу, например Iceberg Catalog.
Расширяемая инфраструктура коннекторов
Doris предоставляет удобную расширяемую инфраструктуру, которая помогает разработчикам быстро подключать специфичные для предприятия источники данных и налаживать обмен данными.
Doris определяет три стандартных уровня: Catalog, база данных и таблица. Разработчики могут легко сопоставить их с соответствующими уровнями нужного источника данных. Doris также предоставляет стандартные интерфейсы доступа к службам метаданных и хранения. Для подключения источника данных разработчикам достаточно реализовать соответствующий интерфейс.
Doris совместим с плагинами Trino Connector: пакет плагина Trino можно развернуть непосредственно в кластере Doris и после минимальной настройки получить доступ к соответствующему источнику данных. В Doris уже реализованы подключения к таким источникам данных, как Kudu, BigQuery и Delta Lake. Вы также можете самостоятельно адаптировать новые плагины.
Удобная обработка данных из разных источников
Doris поддерживает создание нескольких каталогов данных во время работы и выполнение федеративных запросов к этим источникам с помощью SQL. Например, пользователи могут объединить в запросе данные таблицы фактов в Hive с данными таблицы измерений в MySQL:
SELECT h.id, m.name
FROM hive.db.hive_table h JOIN mysql.db.mysql_table m
ON h.id = m.id;
Встроенные в Doris возможности планирования заданий позволяют также создавать задания по расписанию и тем самым дополнительно упрощать систему. Например, приведённый выше запрос можно выполнять каждый час, записывая результат каждого выполнения в таблицу Iceberg:
CREATE JOB schedule_load
ON SCHEDULE EVERY 1 HOUR DO
INSERT INTO iceberg.db.ice_table
SELECT h.id, m.name
FROM hive.db.hive_table h JOIN mysql.db.mysql_table m
ON h.id = m.id;
Высокопроизводительная обработка данных
Как аналитическое хранилище данных, Doris включает множество оптимизаций обработки данных и вычислений в lakehouse и предоставляет широкие возможности ускорения запросов:
-
Движок выполнения
Движок выполнения Doris основан на инфраструктуре выполнения MPP и модели обработки данных Pipeline. Он способен быстро обрабатывать огромные объёмы данных в распределённой среде с множеством машин и процессорных ядер. Благодаря полностью векторизованным операторам выполнения Doris занимает лидирующие позиции по вычислительной производительности на стандартных тестовых наборах данных, таких как TPC-DS.
-
Оптимизатор запросов
Оптимизатор запросов позволяет Doris автоматически оптимизировать и обрабатывать сложные SQL-запросы. Он глубоко оптимизирует различные сложные операторы SQL, включая соединения нескольких таблиц, агрегацию, сортировку и пагинацию. Используя стоимостные модели и преобразования реляционной алгебры, оптимизатор автоматически получает более эффективные или оптимальные логические и физические планы выполнения. Это существенно упрощает написание SQL, повышает удобство использования и производительность.
-
Кеширование данных и оптимизация IO
Доступ к внешним источникам данных обычно осуществляется по сети, что может приводить к большим задержкам и нестабильной работе. Apache Doris предоставляет разнообразные механизмы кеширования и множество оптимизаций типов кеша, актуальности его содержимого и стратегий кеширования. Эффективное использование памяти и локальных высокоскоростных дисков повышает производительность анализа часто используемых данных. Кроме того, в Doris реализованы целевые оптимизации с учётом таких характеристик сетевого IO, как высокая пропускная способность, низкие IOPS и большие задержки. Это обеспечивает производительность доступа к внешним источникам данных, сопоставимую с доступом к локальным данным.
-
Материализованные представления и прозрачное ускорение
Doris предоставляет разнообразные стратегии обновления материализованных представлений, поддерживая полное и инкрементальное обновление на уровне разделов. Это снижает затраты на создание представлений и повышает актуальность данных. Помимо ручного обновления, Doris поддерживает обновление по расписанию и при изменении данных, что дополнительно снижает затраты на обслуживание и повышает согласованность данных. Материализованные представления также обеспечивают прозрачное ускорение: оптимизатор запросов может автоматически направлять запросы к подходящим материализованным представлениям. Кроме того, материализованные представления Doris используют высокопроизводительные форматы хранения и обеспечивают эффективный доступ к данным благодаря столбцовому хранению, сжатию и интеллектуальному индексированию. Они могут служить альтернативой кешированию данных и повышать эффективность запросов.
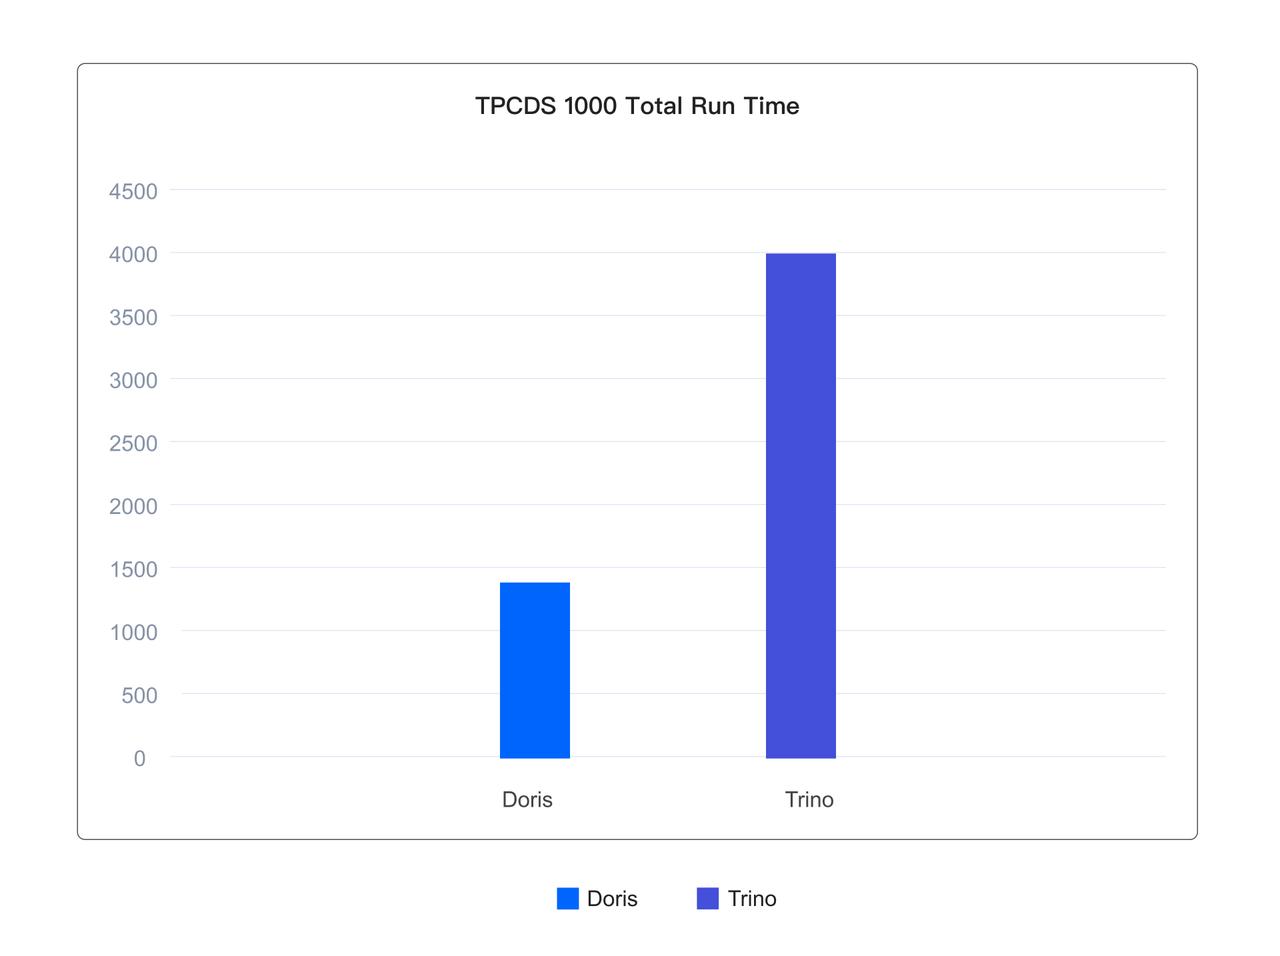
Как показано ниже, на стандартном тестовом наборе TPCDS объёмом 1TB с таблицами в формате Iceberg общее время выполнения 99 запросов в Doris составляет лишь 1/3 от времени Trino.
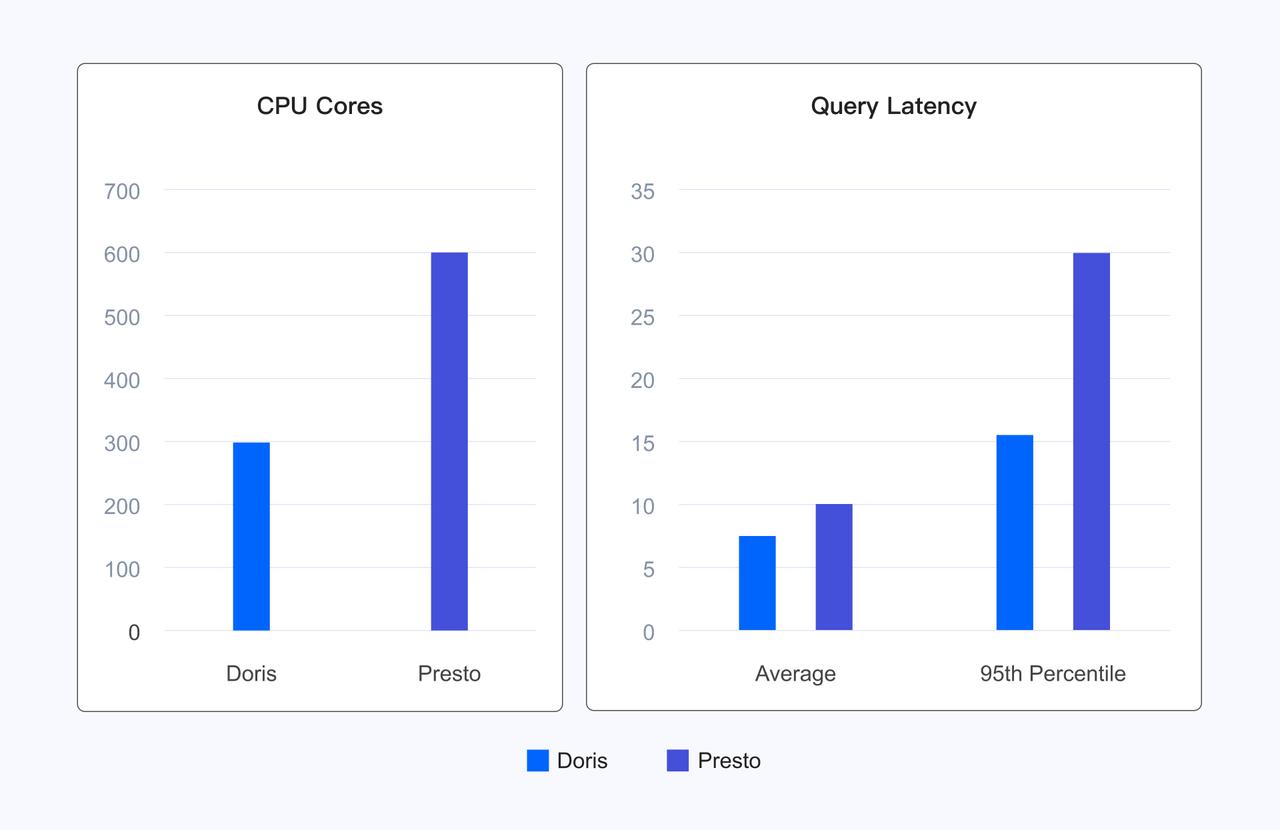
В реальных пользовательских сценариях Doris снижает среднюю задержку запросов на 20%, а задержку на уровне 95-го перцентиля на 50% по сравнению с Presto, используя при этом вдвое меньше ресурсов. Это существенно сокращает затраты на ресурсы и улучшает пользовательский опыт.
Удобная миграция сервисов
При интеграции нескольких источников данных и переходе к lakehouse перенос SQL-запросов в Doris представляет сложность из-за различий между диалектами SQL в синтаксисе и поддержке функций. Без подходящего плана миграции может потребоваться существенно изменить бизнес-приложения, чтобы адаптировать их к синтаксису SQL новой системы.
Современная архитектура развёртывания
Начиная с версии 3.0, Doris поддерживает облачную архитектуру с разделением вычислений и хранения. Благодаря низкой стоимости и высокой эластичности эта архитектура повышает эффективность использования ресурсов и позволяет независимо масштабировать вычисления и хранение.
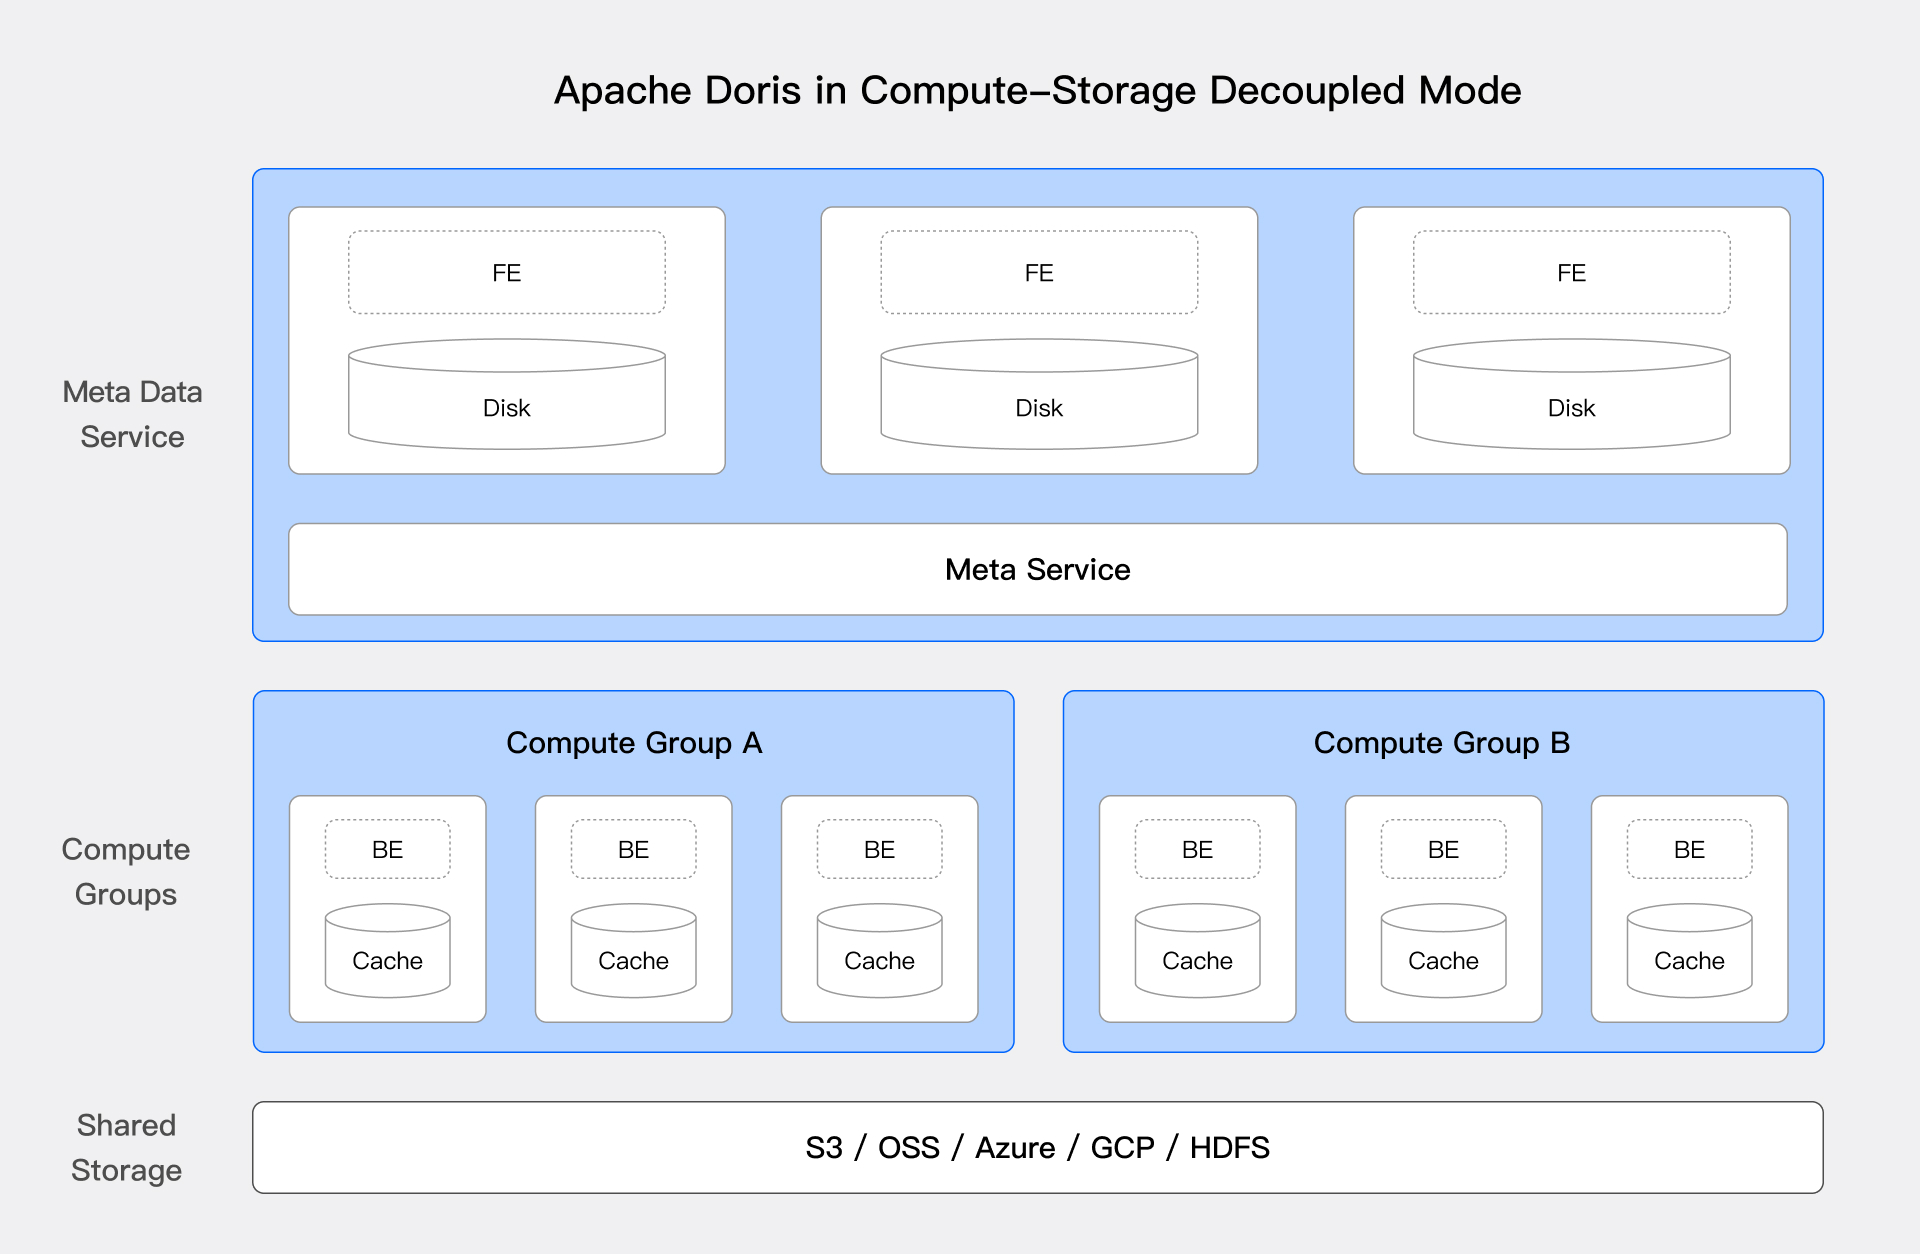
На схеме выше показана архитектура Doris с разделением вычислений и хранения. Вычислительные узлы больше не хранят основные данные, а нижележащий общий слой хранения (HDFS и объектное хранилище) служит единым пространством хранения основных данных. Это позволяет независимо масштабировать вычислительные ресурсы и ресурсы хранения. Архитектура с разделением вычислений и хранения даёт решению lakehouse существенные преимущества:
-
Низкая стоимость хранения: ресурсы хранения и вычислений можно масштабировать независимо, что позволяет предприятиям увеличивать ёмкость хранения без наращивания вычислительных ресурсов. Кроме того, облачное объектное хранилище обеспечивает более низкую стоимость хранения и более высокую доступность. При этом локальные высокоскоростные диски по-прежнему можно использовать для кеширования сравнительно небольшой доли часто используемых данных.
-
Единый достоверный источник данных: все данные находятся в едином слое хранения, поэтому разные вычислительные кластеры могут обращаться к одним и тем же данным и обрабатывать их. Это обеспечивает согласованность и целостность данных, а также снижает сложность синхронизации и дублирования данных при хранении.
-
Разнообразие рабочих нагрузок: пользователи могут динамически выделять вычислительные ресурсы в соответствии с потребностями разных нагрузок, поддерживая такие сценарии, как пакетная обработка, анализ в реальном времени и машинное обучение. Разделение хранения и вычислений позволяет предприятиям более гибко оптимизировать использование ресурсов и обеспечивать эффективную работу при разных нагрузках.
Кроме того, в архитектуре с совместным размещением хранения и вычислений можно по-прежнему использовать эластичные вычислительные узлы, чтобы обеспечить эластичность вычислений при выполнении запросов к данным lakehouse.
Открытость
Doris поддерживает доступ к открытым табличным форматам озёр данных и обеспечивает открытый доступ к данным, хранящимся в самом Doris. Для этого Doris предоставляет открытый API доступа к хранилищу и реализует высокоскоростной канал передачи данных на основе протокола Arrow Flight SQL, сочетая скорость Arrow Flight с удобством JDBC/ODBC. Через этот интерфейс пользователи могут обращаться к данным в Doris с помощью клиентов ABDC для Python/Java/Spark/Flink.
В отличие от открытых файловых форматов, открытый API доступа к хранилищу скрывает конкретную реализацию нижележащего файлового формата. Это позволяет Doris ускорять доступ к данным с помощью расширенных возможностей собственного формата хранения, таких как разнообразные механизмы индексирования. Кроме того, вычислительным движкам верхнего уровня не требуется адаптироваться к изменениям или новым возможностям нижележащего формата хранения. Все поддерживаемые вычислительные движки могут одновременно получать преимущества новых возможностей.
Рекомендации по использованию Lakehouse
В решении lakehouse Doris в основном используется для ускорения запросов к данным lakehouse, федеративного анализа данных из нескольких источников и обработки данных lakehouse.
Ускорение запросов к данным Lakehouse
В этом сценарии Doris выступает в роли вычислительного движка, ускоряя аналитические запросы к данным lakehouse.
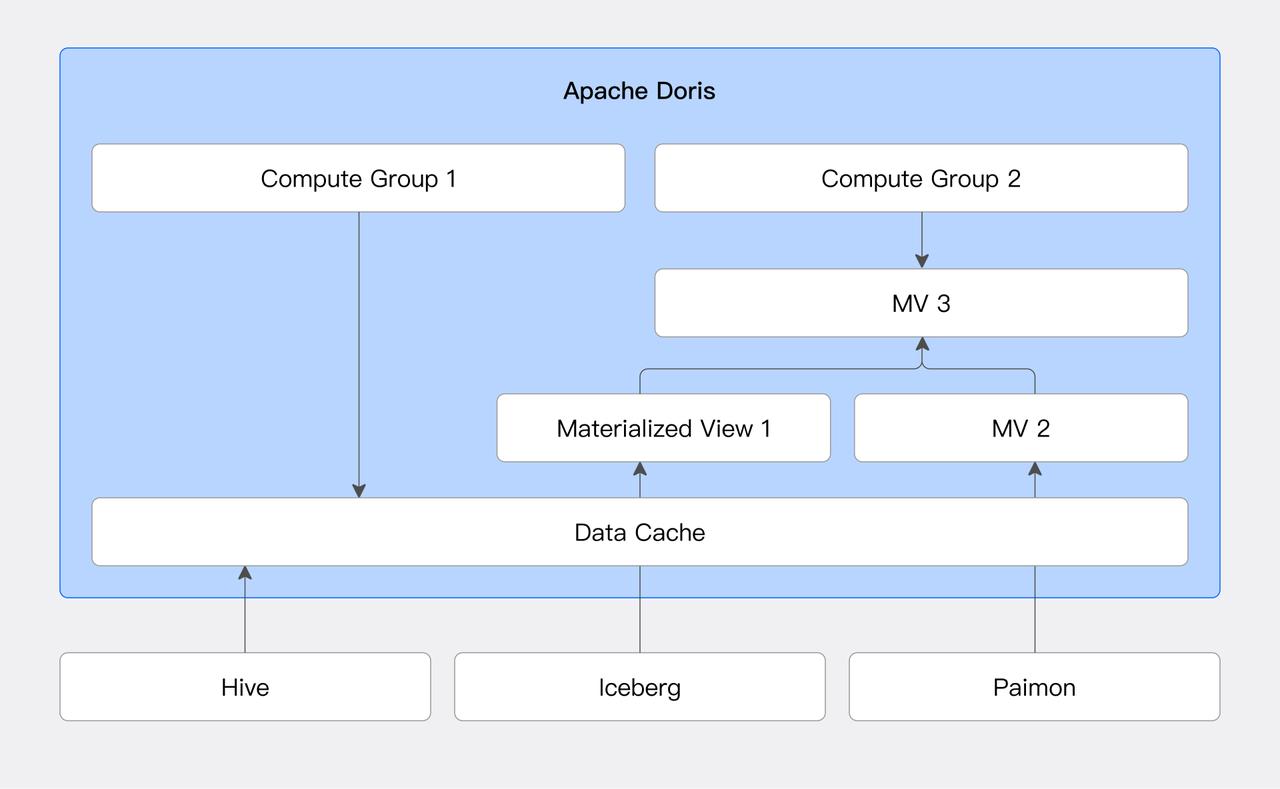
Ускорение с помощью кеширования
Для систем lakehouse, таких как Hive и Iceberg, пользователи могут настроить кеширование на локальных дисках. Оно автоматически сохраняет файлы данных, используемые запросами, в локальных каталогах кеша и управляет вытеснением по стратегии LRU. Подробнее см. в документе Кеширование данных.
Материализованные представления и прозрачное переписывание запросов
Doris поддерживает создание материализованных представлений для внешних источников данных. Материализованные представления хранят предварительно вычисленные результаты в формате внутренних таблиц Doris на основе определяющих их SQL-выражений. Кроме того, оптимизатор запросов Doris поддерживает алгоритм прозрачного переписывания запросов на основе шаблона SPJG (SELECT-PROJECT-JOIN-GROUP-BY). Этот алгоритм анализирует структуру SQL, автоматически находит подходящие материализованные представления для прозрачного переписывания и выбирает оптимальное представление для выполнения SQL-запроса.
Эта возможность существенно повышает производительность запросов за счёт сокращения вычислений во время выполнения. Прозрачное переписывание также позволяет обращаться к данным в материализованных представлениях без изменений в бизнес-приложениях. Подробнее см. в документе Материализованные представления.
Федеративный анализ данных из нескольких источников
Doris может выступать в роли единого движка SQL-запросов, подключая различные источники для федеративного анализа и устраняя изолированность данных.
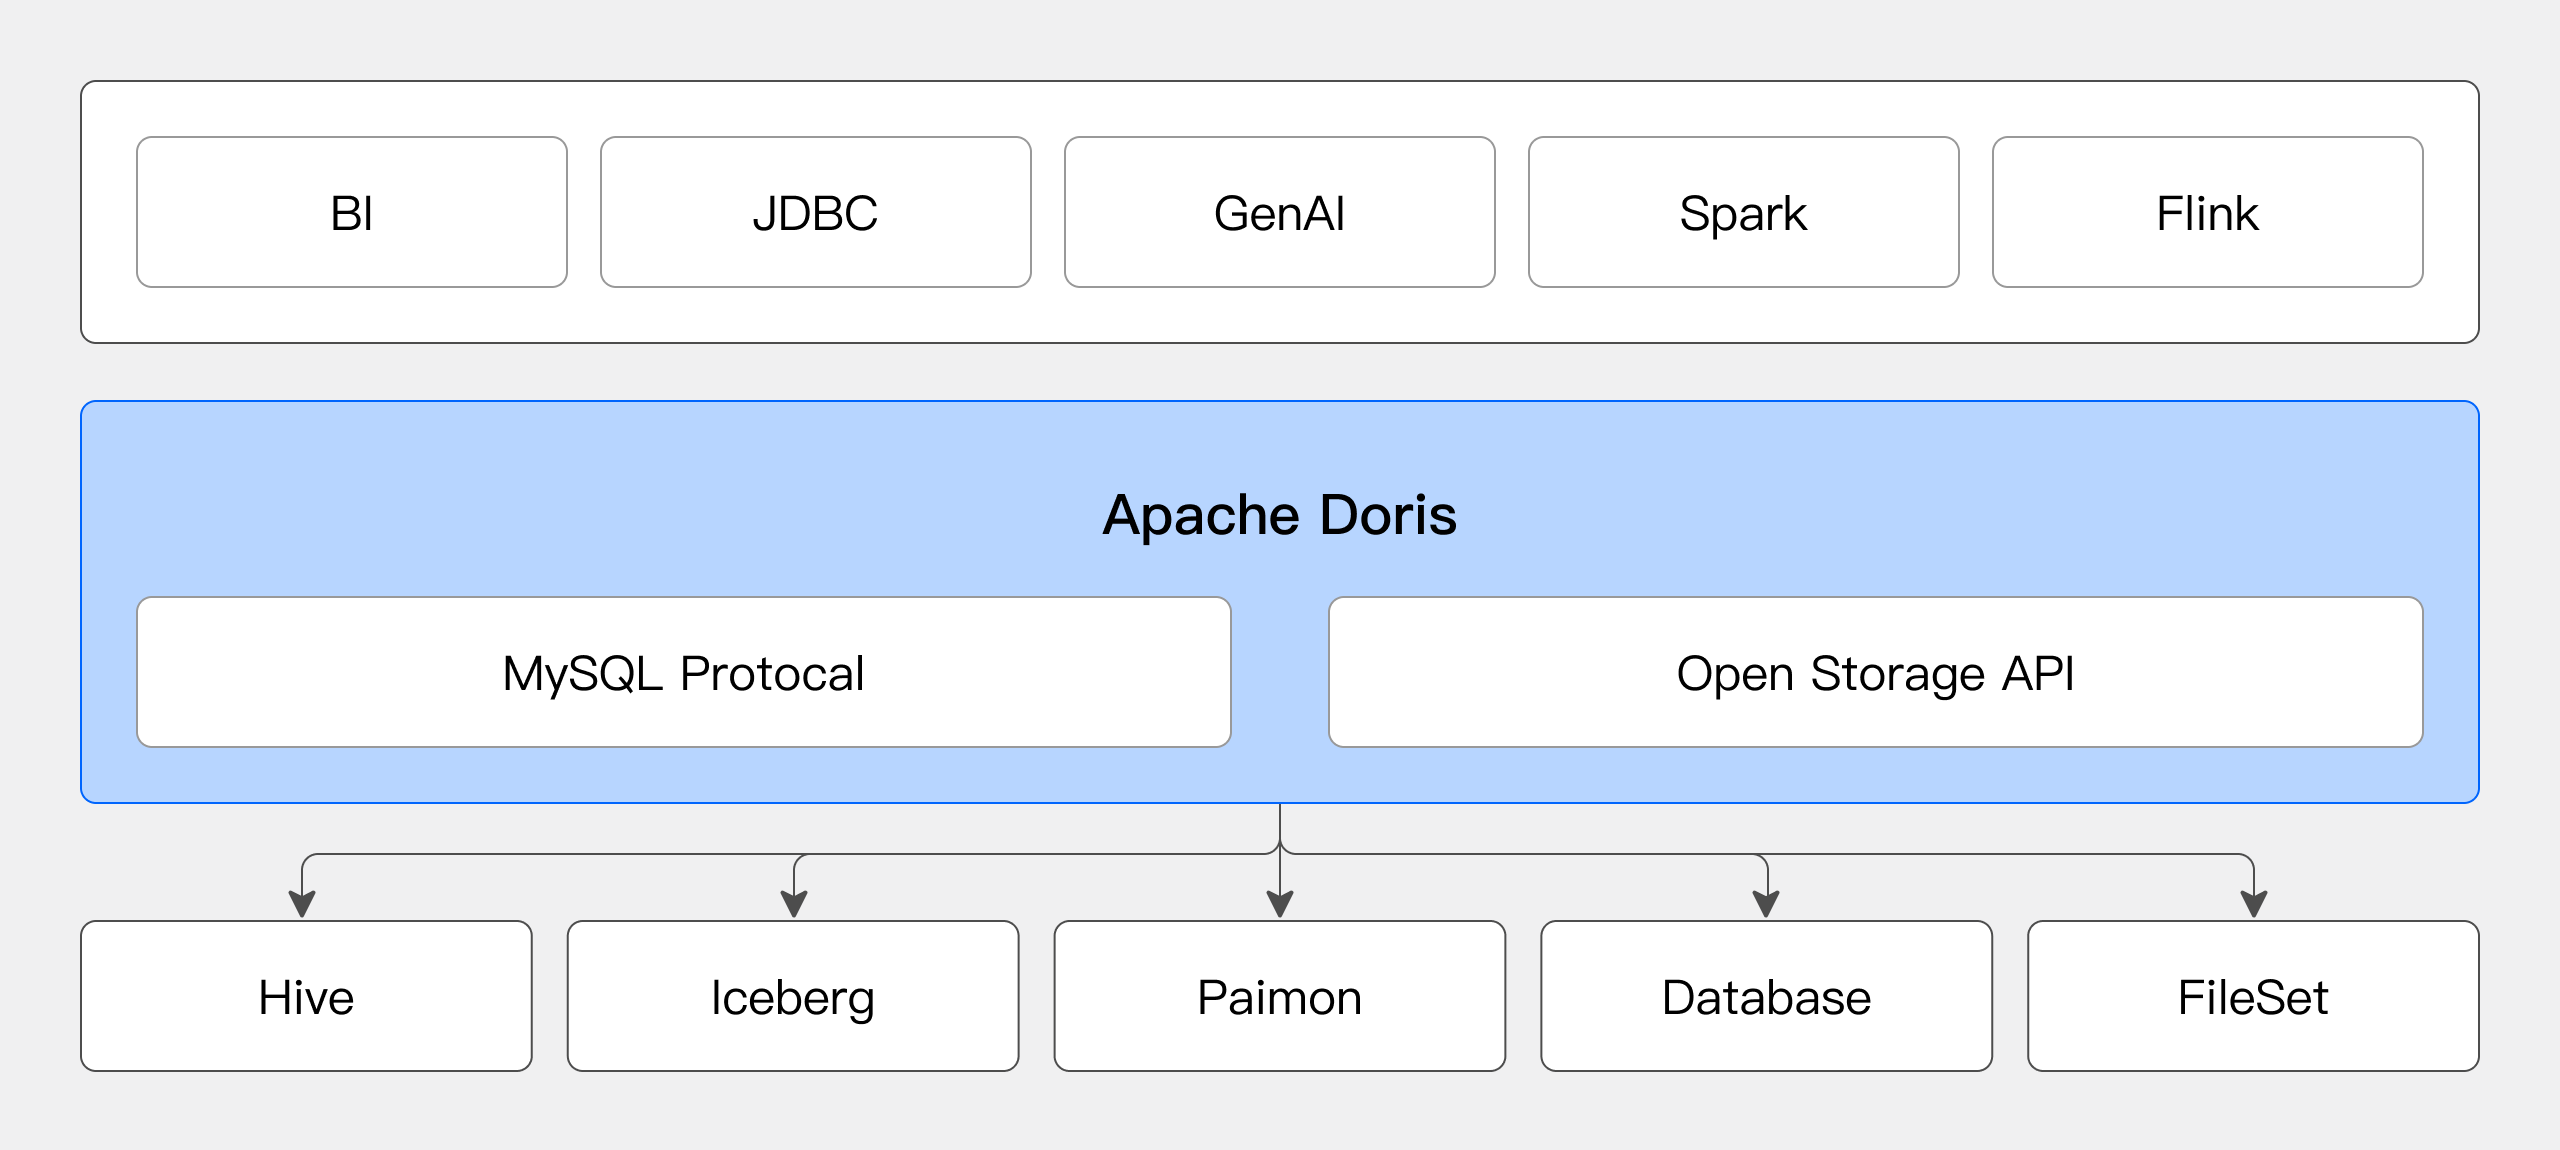
Пользователи могут динамически создавать в Doris несколько каталогов для подключения разных источников данных и с помощью SQL выполнять произвольные запросы с соединением данных из этих источников. Подробнее см. в разделе Обзор Catalog.
Обработка данных Lakehouse
В этом сценарии Doris выступает в роли движка обработки данных, обрабатывая данные lakehouse.
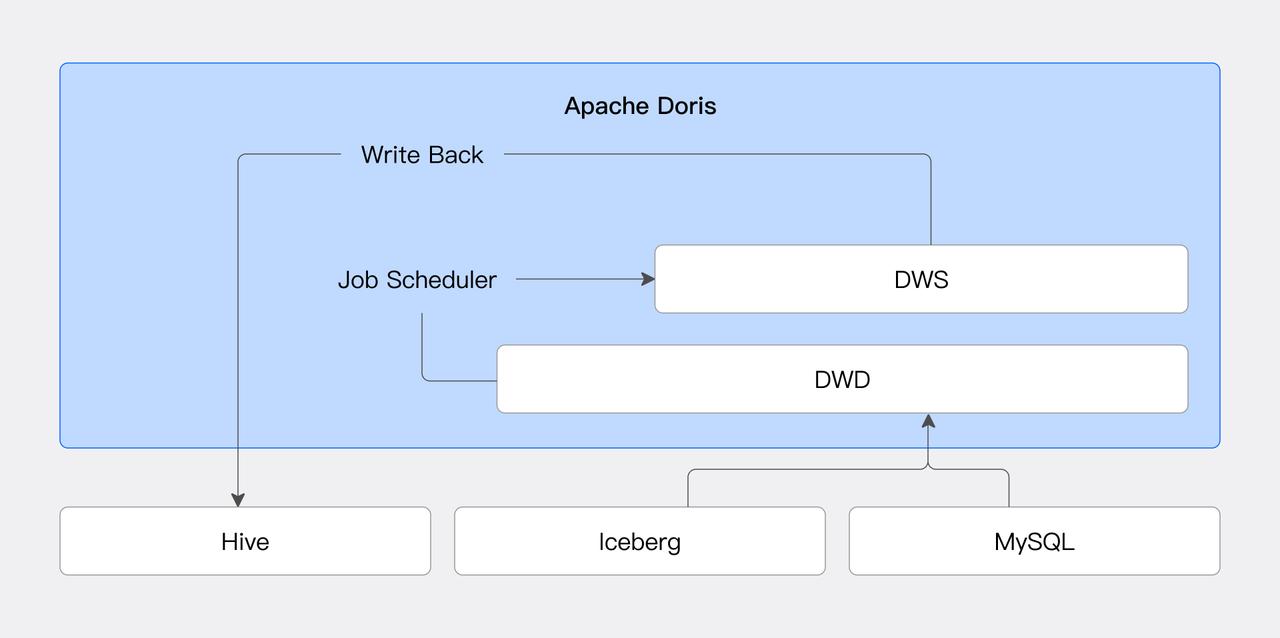
Планирование заданий
Doris предоставляет функцию Job Scheduler для эффективного и гибкого планирования заданий, снижая зависимость от внешних систем. В сочетании с коннекторами источников данных она позволяет организовать периодическую обработку и сохранение внешних данных. Подробнее см. в разделе Планировщик заданий.
Моделирование данных
Пользователи обычно хранят исходные данные в озёрах данных и на их основе организуют многоуровневую обработку, предоставляя данные разных уровней для различных бизнес-потребностей. Doris поддерживает создание материализованных представлений для внешних источников данных и дальнейшую обработку на основе этих представлений. Это упрощает систему и повышает эффективность обработки данных.
Обратная запись данных
Обратная запись данных замыкает цикл обработки данных lakehouse в Doris. Пользователи могут непосредственно через Doris создавать базы данных и таблицы во внешних источниках и записывать в них данные. В настоящее время поддерживаются источники данных JDBC, Hive и Iceberg; в будущем планируется добавить другие источники. Подробнее см. в документации соответствующего источника данных.