Хранение и анализ трассировок
В этой статье описано, как хранить и анализировать данные трассировки в Apache Doris, включая весь процесс создания таблицы, сбора данных и выполнения запросов.
- Общие сведения о решении для обеспечения наблюдаемости см. в разделе Обзор.
- Оценка необходимых ресурсов, развёртывание кластера и настройка производительности рассмотрены в разделе Логи.
Быстрая навигация
Полный процесс настройки состоит из трёх шагов, которые можно выполнить последовательно:
| Шаг | Содержание | Цель |
|---|---|---|
| 1. Создайте таблицу | Создание таблицы для хранения трассировок в Doris | Оптимизировать производительность с учётом особенностей записи и запросов к данным трассировки |
| 2. Настройте сбор | Запись данных трассировки в Doris через OpenTelemetry | Настроить конвейер «приложение → Collector → Doris» |
| 3. Выполните запросы | Визуальный анализ данных трассировки в Grafana | Выполнять поиск, просматривать распределение задержек и изучать подробности трассировок |
1. Создание таблицы
Данные трассировки имеют характерные особенности записи и обработки запросов. Настройка таблицы с учётом этих особенностей позволяет повысить производительность.
1.1 Основные параметры настройки
В следующей таблице приведены основные параметры и рекомендации по созданию таблицы:
| Параметр настройки | Рекомендуемый подход | Описание |
|---|---|---|
| Партиционирование | Используйте партиционирование RANGE по полю времени и включите динамическое партиционирование для автоматического управления ежедневными партициями | Автоматическая ротация партиций упрощает разделение горячих и холодных данных и удаление данных по истечении срока хранения |
| Ключ сортировки | Используйте в качестве ключа service_name и поле времени типа DATETIME | В несколько раз ускоряет запросы, которые сканируют данные определённого сервиса за заданный диапазон времени |
| Количество бакетов | Примерно в 3 раза больше общего количества дисков в кластере | Обеспечивает баланс между параллелизмом и количеством мелких файлов |
| Стратегия бакетирования | Используйте RANDOM вместе с загрузкой в один tablet при записи | Позволяет эффективнее объединять записи в пакеты |
| Компактация | Используйте политику компактации time_series | Снижает усиление записи, что особенно важно для оптимизации ресурсов при интенсивной записи данных трассировки |
| Полуструктурированные поля | Используйте тип VARIANT для span_attributes и resource_attributes | Автоматически разбивает JSON на подстолбцы для хранения, улучшая сжатие и повышая производительность фильтрации и анализа по подстолбцам |
| Индексы | Создавайте инвертированные индексы для полей, часто используемых в запросах | Ускоряет фильтрацию по равенству и диапазонные запросы |
| Полнотекстовый поиск | Укажите токенизатор с помощью параметра parser (обычно достаточно unicode) и при необходимости включите support_phrase | support_phrase включает поиск по фразам; отключите его, если он не нужен, чтобы сократить объём хранения |
| Реплики | Для облачных дисков можно использовать 1 реплику; для физических дисков следует использовать не менее 2 реплик | Обеспечивает баланс между надёжностью и стоимостью |
| Разделение горячих и холодных данных | Настройте объектное хранилище log_s3 и политику log_policy_3day | Данные старше 3 дней автоматически перемещаются в S3, что снижает стоимость хранения горячих данных |
1.2 Пример SQL для создания таблицы
Следующий пример охватывает весь процесс создания ресурса, политики хранения и таблицы:
CREATE DATABASE log_db;
USE log_db;

-- Not required in the storage-compute decoupled mode
CREATE RESOURCE "log_s3"
PROPERTIES
(
    "type" = "s3",
    "s3.endpoint" = "your_endpoint_url",
    "s3.region" = "your_region",
    "s3.bucket" = "your_bucket",
    "s3.root.path" = "your_path",
    "s3.access_key" = "your_ak",
    "s3.secret_key" = "your_sk"
);

-- Not required in the storage-compute decoupled mode
CREATE STORAGE POLICY log_policy_3day
PROPERTIES(
    "storage_resource" = "log_s3",
    "cooldown_ttl" = "259200"
);

CREATE TABLE trace_table
(
    service_name          VARCHAR(200),
    timestamp             DATETIME(6),
    service_instance_id   VARCHAR(200),
    trace_id              VARCHAR(200),
    span_id               STRING,
    trace_state           STRING,
    parent_span_id        STRING,
    span_name             STRING,
    span_kind             STRING,
    end_time              DATETIME(6),
    duration              BIGINT,
    span_attributes       VARIANT,
    events                ARRAY<STRUCT<timestamp:DATETIME(6), name:STRING, attributes:MAP<STRING, STRING>>>,
    links                 ARRAY<STRUCT<trace_id:STRING, span_id:STRING, trace_state:STRING, attributes:MAP<STRING, STRING>>>,
    status_message        STRING,
    status_code           STRING,
    resource_attributes   VARIANT,
    scope_name            STRING,
    scope_version         STRING,
    INDEX idx_timestamp(timestamp) USING INVERTED,
    INDEX idx_service_instance_id(service_instance_id) USING INVERTED,
    INDEX idx_trace_id(trace_id) USING INVERTED,
    INDEX idx_span_id(span_id) USING INVERTED,
    INDEX idx_trace_state(trace_state) USING INVERTED,
    INDEX idx_parent_span_id(parent_span_id) USING INVERTED,
    INDEX idx_span_name(span_name) USING INVERTED,
    INDEX idx_span_kind(span_kind) USING INVERTED,
    INDEX idx_end_time(end_time) USING INVERTED,
    INDEX idx_duration(duration) USING INVERTED,
    INDEX idx_span_attributes(span_attributes) USING INVERTED,
    INDEX idx_status_message(status_message) USING INVERTED,
    INDEX idx_status_code(status_code) USING INVERTED,
    INDEX idx_resource_attributes(resource_attributes) USING INVERTED,
    INDEX idx_scope_name(scope_name) USING INVERTED,
    INDEX idx_scope_version(scope_version) USING INVERTED
)
ENGINE = OLAP
DUPLICATE KEY(service_name, timestamp)
PARTITION BY RANGE(timestamp) ()
DISTRIBUTED BY RANDOM BUCKETS 250
PROPERTIES (
"compression" = "zstd",
"compaction_policy" = "time_series",
"inverted_index_storage_format" = "V2",
"dynamic_partition.enable" = "true",
"dynamic_partition.create_history_partition" = "true",
"dynamic_partition.time_unit" = "DAY",
"dynamic_partition.start" = "-30",
"dynamic_partition.end" = "1",
"dynamic_partition.prefix" = "p",
"dynamic_partition.buckets" = "250",
"dynamic_partition.replication_num" = "2", -- Not required in storage-compute decoupled mode
"replication_num" = "2", -- Not required in storage-compute decoupled mode
"storage_policy" = "log_policy_3day" -- Not required in storage-compute decoupled mode
);
2. Сбор данных трассировки
Doris предоставляет открытый универсальный Stream HTTP API, который интегрируется с системами сбора данных трассировки, такими как OpenTelemetry.
2.1 Общая схема конвейера
Приложение → OpenTelemetry SDK/Agent → OpenTelemetry Collector (с Doris Exporter) → таблица Doris.
2.2 Шаги интеграции с OpenTelemetry
Шаг 1: Интегрируйте OpenTelemetry SDK в приложение
Здесь используется официальный пример Spring Boot с интеграцией OpenTelemetry Java SDK, который возвращает простую строку Hello World! при обращении к пути /.
Скачайте OpenTelemetry Java Agent. Преимущество Java Agent в том, что он не требует изменений в существующем приложении.
Для других языков и способов интеграции см.:
Шаг 2: Разверните и настройте OpenTelemetry Collector
Скачайте OpenTelemetry Collector и распакуйте его.
Скачайте пакет выпуска, имя которого начинается с
otelcol-contrib. Он включает компонент Doris Exporter, позволяющий загружать данные трассировки в Doris.
Создайте файл конфигурации otel_demo.yaml со следующим содержимым. Дополнительные параметры настройки описаны в документации Doris Exporter:
receivers:
    otlp: # otlp protocol, receives data sent by the OpenTelemetry Java Agent
        protocols:
            grpc:
                endpoint: 0.0.0.0:4317
            http:
                endpoint: 0.0.0.0:4318

processors:
    batch:
        send_batch_size: 100000 # Number of records per batch; recommended batch size is between 100M and 1G
        timeout: 10s

exporters:
    doris:
        endpoint: http://localhost:8030 # FE HTTP address
        database: doris_db_name
        username: doris_username
        password: doris_password
        table:
            traces: doris_table_name
        create_schema: true # Whether to automatically create the schema; when set to false, you need to create the table manually
        mysql_endpoint: localhost:9030  # FE MySQL address
        history_days: 10
        create_history_days: 10
        timezone: Asia/Shanghai
        timeout: 60s # http stream load client timeout
        log_response: true
        sending_queue:
            enabled: true
            num_consumers: 20
            queue_size: 1000
        retry_on_failure:
            enabled: true
            initial_interval: 5s
            max_interval: 30s
        headers:
            load_to_single_tablet: "true"
Шаг 3: Запустите OpenTelemetry Collector
./otelcol-contrib --config otel_demo.yaml
Шаг 4: Запустите пример приложения Spring Boot
Перед запуском приложения достаточно задать несколько переменных окружения; изменять код не требуется:
export JAVA_TOOL_OPTIONS="${JAVA_TOOL_OPTIONS} -javaagent:/your/path/to/opentelemetry-javaagent.jar" # Path to the OpenTelemetry Java Agent
export OTEL_JAVAAGENT_LOGGING="none" # Disable otel logging to avoid interfering with the service's own logs
export OTEL_SERVICE_NAME="myproject"
export OTEL_TRACES_EXPORTER="otlp" # Use the otlp protocol to send trace data
export OTEL_EXPORTER_OTLP_ENDPOINT="http://localhost:4317" # Address of the OpenTelemetry Collector

java -jar myproject-0.0.1-SNAPSHOT.jar
Шаг 5: Обратитесь к примеру приложения и сгенерируйте данные трассировки
Выполните curl localhost:8080, чтобы вызвать сервис hello. OpenTelemetry Java Agent автоматически генерирует данные трассировки и отправляет их в OpenTelemetry Collector. Затем Collector записывает данные трассировки в таблицу Doris через настроенный Doris Exporter (по умолчанию таблица называется otel.otel_traces).
3. Запросы к данным трассировки
Запросы к данным трассировки обычно выполняют через графический интерфейс, например Grafana. Типичные сценарии:
-
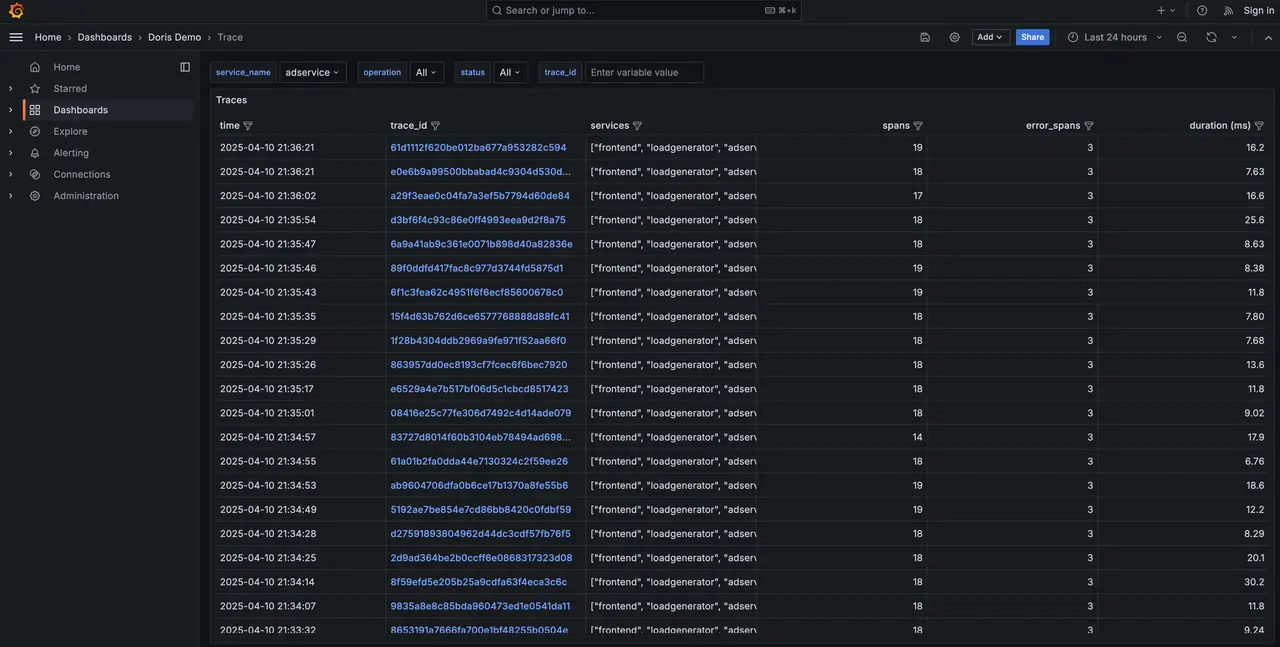
Отфильтруйте данные по диапазону времени и имени сервиса, чтобы увидеть обзор трассировок, включая диаграмму распределения задержек и последние трассировки.
-
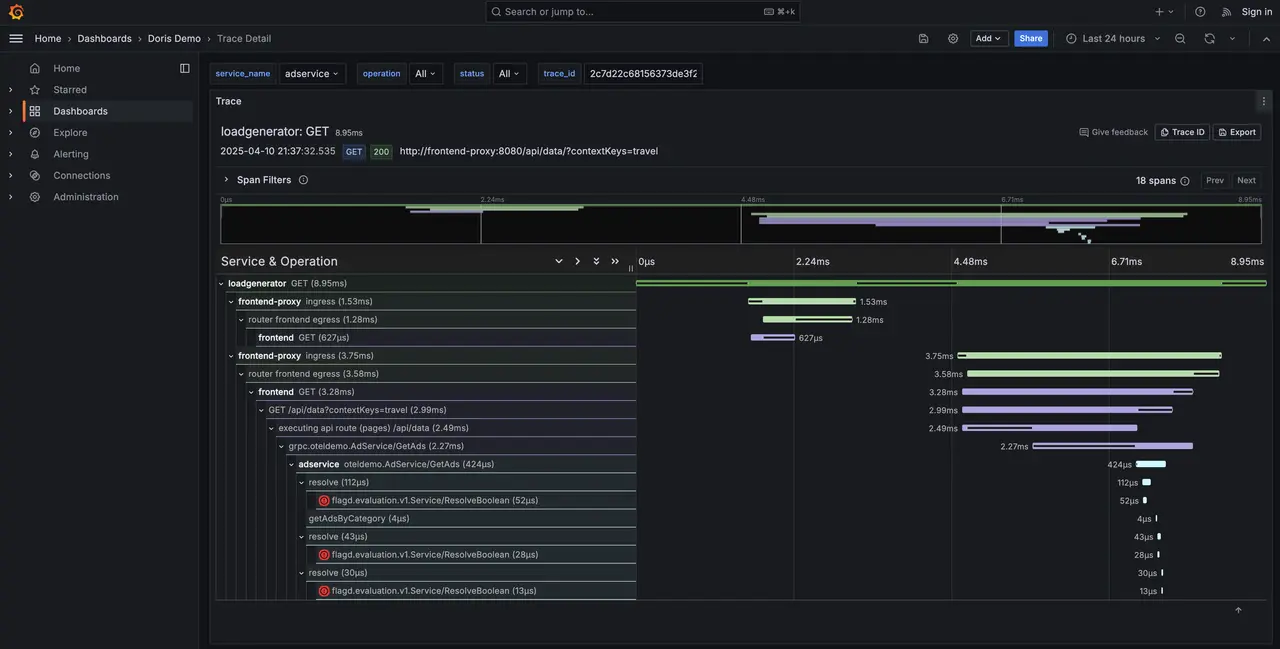
Нажмите ссылку, чтобы просмотреть подробности трассировки.