Redshift
При переносе данных из Redshift в Apache Doris в качестве промежуточного хранилища обычно используется сервис объектного хранения (например, Amazon S3). Общая последовательность миграции:
- Создайте целевую таблицу в Doris на основе схемы исходной таблицы.
- Экспортируйте данные в объектное хранилище с помощью оператора Redshift UNLOAD.
- Используйте функцию S3 Load в Doris, чтобы прочитать данные из объектного хранилища и загрузить их в Doris. Подробнее см. в разделе S3 Load.
Примечания
Перед миграцией обратите внимание на следующее:
- Модель данных и стратегия партиционирования: выберите подходящую модель данных Doris на основе схемы исходной таблицы Redshift и определите стратегию партиционирования и бакетирования. Дополнительные рекомендации по проектированию таблиц см. в разделе Рекомендации по загрузке.
- Преобразование типов: перед экспортом данных типа
TIMEиз Redshift необходимо выполнитьCASTвVARCHAR. - Ограничения для сложных типов: файлы Parquet/ORC, содержащие сложные типы (Struct/Array/Map), в настоящее время необходимо загружать с помощью TVF Load.
Сопоставление типов данных
Перед миграцией сопоставьте типы данных Redshift с типами данных Doris по следующей таблице:
| Redshift | Doris | Примечания |
|---|---|---|
| SMALLINT | SMALLINT | |
| INTEGER | INT | |
| BIGINT | BIGINT | |
| DECIMAL | DECIMAL | |
| REAL | FLOAT | |
| DOUBLE PRECISION | DOUBLE | |
| BOOLEAN | BOOLEAN | |
| CHAR | CHAR | |
| VARCHAR | VARCHAR/STRING | Максимальная длина VARCHAR: 65535 |
| DATE | DATE | |
| TIMESTAMP | DATETIME | |
| TIME/TIMEZ | STRING | |
| SUPER | VARIANT | |
| OTHER | UNSUPPORTED |
Этапы миграции
1. Создайте таблицу Doris
Перед миграцией создайте соответствующую целевую таблицу в Doris.
Цель: спланировать модель данных, партиционирование и стратегию бакетирования в Doris на основе схемы исходной таблицы Redshift.
Пример исходной таблицы Redshift:
CREATE TABLE sales_data (
    order_id      INTEGER,
    customer_name VARCHAR(128),
    order_date    DATE,
    amount        DECIMAL(10,2),
    country       VARCHAR(48)
)
DISTSTYLE AUTO;

INSERT INTO sales_data VALUES
(1, 'Alice', '2025-04-08', 99.99, 'USA'),
(2, 'Bob', '2025-04-08', 149.50, 'Canada'),
(3, 'Charlie', '2025-04-09', 75.00, 'UK'),
(4, 'Diana', '2025-04-10', 200.00, 'Australia');
Пример целевой таблицы Doris: на основе приведённой выше схемы создайте партиционированную таблицу Unique Key со столбцом партиционирования order_date и партициями по дням:
CREATE TABLE `sales_data` (
  order_id      INT,
  order_date    DATE NOT NULL,
  customer_name VARCHAR(128),
  amount        DECIMAL(10,2),
  country       VARCHAR(48)
) ENGINE=OLAP
UNIQUE KEY(`order_id`,`order_date`)
PARTITION BY RANGE(`order_date`) (
PARTITION p20250408 VALUES [('2025-04-08'), ('2025-04-09')),
PARTITION p20250409 VALUES [('2025-04-09'), ('2025-04-10')),
PARTITION p20250410 VALUES [('2025-04-10'), ('2025-04-11'))
)
DISTRIBUTED BY HASH(`order_id`) BUCKETS 16
PROPERTIES (
 "dynamic_partition.enable" = "true",
 "dynamic_partition.time_unit" = "DAY",
 "dynamic_partition.end" = "5",
 "dynamic_partition.prefix" = "p",
 "dynamic_partition.buckets" = "16",
 "replication_num" = "1"
);
2. Экспортируйте данные из Redshift в S3
2.1 Экспорт в Parquet с помощью UNLOAD
Цель: экспортировать данные Redshift в файлы Parquet с разделением по столбцу партиционирования Doris, чтобы затем загружать данные по отдельным партициям.
Команда:
unload ('select * from sales_data')
to 's3://mybucket/redshift/sales_data/'
iam_role 'arn:aws:iam::0123456789012:role/MyRedshiftRole'
PARQUET
PARTITION BY (order_date) INCLUDE
Примечание: рекомендуется выполнять экспорт по тому же столбцу партиционирования, который используется в Doris, чтобы данные можно было загружать пакетами по партициям.
2.2 Проверьте экспортированные файлы в S3
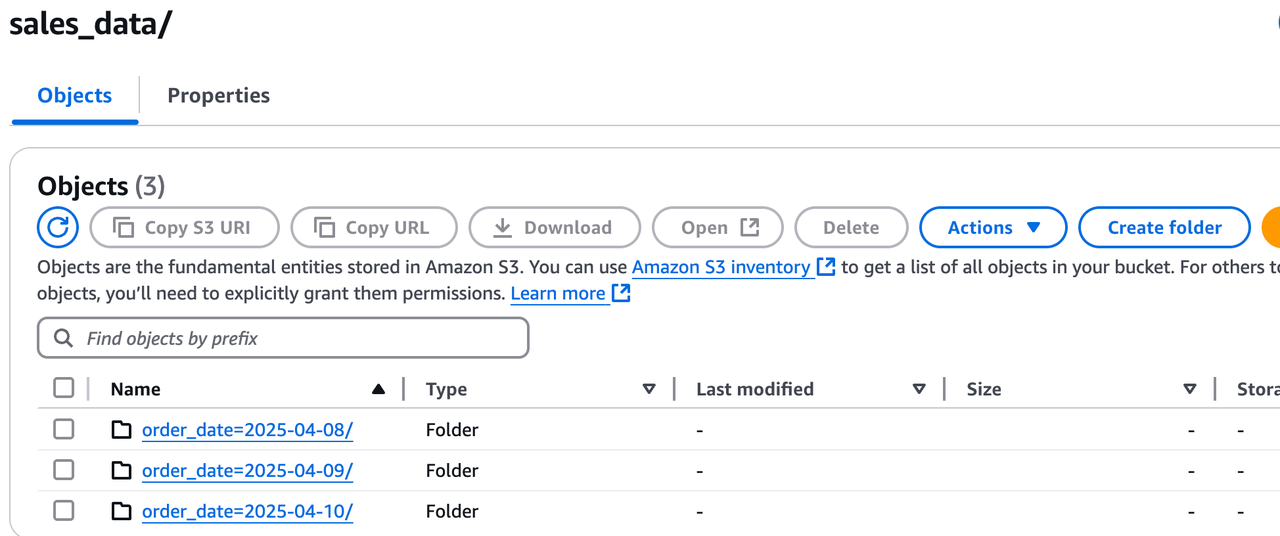
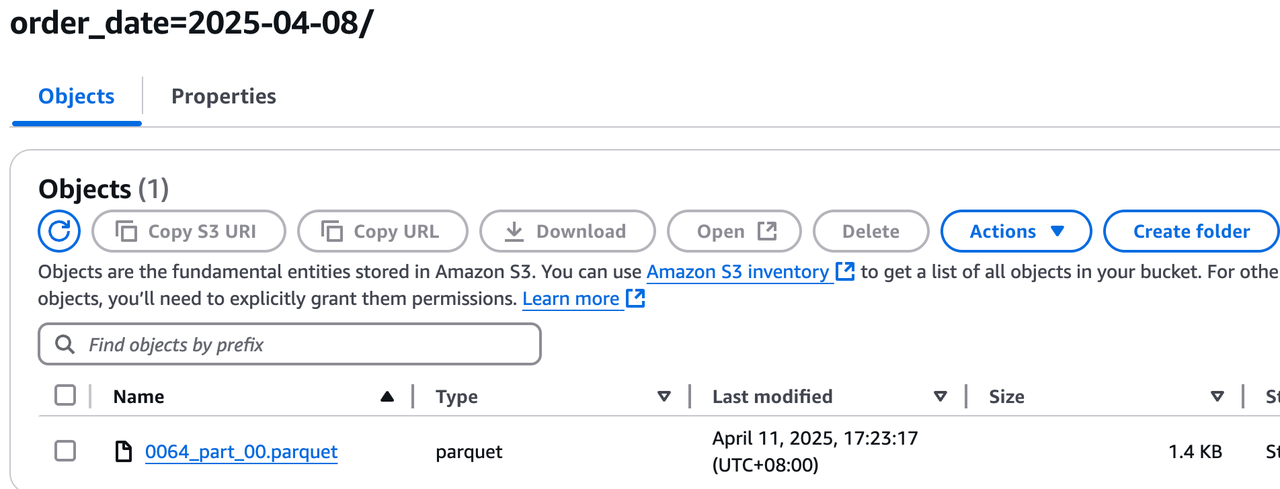
После экспорта в S3 создаётся подкаталог для каждой партиции, и каждый каталог содержит данные одной партиции:
3. Загрузите данные в Doris
Для загрузки используется S3 Load, асинхронный метод загрузки данных, при котором после отправки задания Doris самостоятельно получает данные из источника. Источником может быть любое объектное хранилище, совместимое с S3, включая AWS S3, GCS и AZURE.
Сравнение сценариев применения:
| Сценарий | Рекомендуемый метод |
|---|---|
| Большой объём данных, возможна асинхронная обработка | S3 Load |
| Требуется синхронная загрузка данных | TVF Load |
| Файлы содержат сложные типы (Struct/Array/Map) | TVF Load обязателен |
3.1 Загрузите одну партицию
LOAD LABEL sales_data_2025_04_08
(
    DATA INFILE("s3://mybucket/redshift/sales_data/order_date=2025-04-08/*")
    INTO TABLE sales_data
    FORMAT AS "parquet"
    (order_id, order_date, customer_name, amount, country)
)
WITH S3
(
    "provider" = "S3",
    "s3.endpoint" = "https://s3.ap-southeast-1.amazonaws.com",
    "s3.access_key" = "<ak>",
    "s3.secret_key"="<sk>",
    "s3.region" = "ap-southeast-1"
);
3.2 Проверьте состояние задания с помощью SHOW LOAD
Поскольку S3 Load запускается асинхронно, для проверки хода загрузки можно использовать SHOW LOAD, указав метку задания:
mysql> show load where label = "sales_data_2025_04_08"\G
*************************** 1. row ***************************
         JobId: 17956078
         Label: sales_data_2025_04_08
         State: FINISHED
      Progress: 100.00% (1/1)
          Type: BROKER
       EtlInfo: unselected.rows=0; dpp.abnorm.ALL=0; dpp.norm.ALL=2
      TaskInfo: cluster:s3.ap-southeast-1.amazonaws.com; timeout(s):3600; max_filter_ratio:0.0; priority:NORMAL
      ErrorMsg: NULL
    CreateTime: 2025-04-10 17:50:53
  EtlStartTime: 2025-04-10 17:50:54
 EtlFinishTime: 2025-04-10 17:50:54
 LoadStartTime: 2025-04-10 17:50:54
LoadFinishTime: 2025-04-10 17:50:54
           URL: NULL
    JobDetails: {"Unfinished backends":{"5eec1be8612d4872-91040ff1e7208a4f":[]},"ScannedRows":2,"TaskNumber":1,"LoadBytes":91,"All backends":{"5eec1be8612d4872-91040ff1e7208a4f":[10022]},"FileNumber":1,"FileSize":1620}
 TransactionId: 766228
  ErrorTablets: {}
          User: root
       Comment:
1 row in set (0.00 sec)
3.3 Обработайте ошибки загрузки
Шаг 1: получите список заданий загрузки, завершившихся с ошибкой. Если пакетная загрузка включает несколько заданий, используйте следующий запрос, чтобы отобрать метки заданий с ошибками и причины их сбоя:
mysql> show load where state='CANCELLED' and label like "label_test%"\G
*************************** 1. row ***************************
         JobId: 18312384
         Label: label_test123
         State: CANCELLED
      Progress: 100.00% (3/3)
          Type: BROKER
       EtlInfo: unselected.rows=0; dpp.abnorm.ALL=4; dpp.norm.ALL=0
      TaskInfo: cluster:s3.ap-southeast-1.amazonaws.com; timeout(s):14400; max_filter_ratio:0.0; priority:NORMAL
      ErrorMsg: type:ETL_QUALITY_UNSATISFIED; msg:quality not good enough to cancel
    CreateTime: 2025-04-15 17:32:59
  EtlStartTime: 2025-04-15 17:33:02
 EtlFinishTime: 2025-04-15 17:33:02
 LoadStartTime: 2025-04-15 17:33:02
LoadFinishTime: 2025-04-15 17:33:02
           URL: http://10.16.10.6:28747/api/_load_error_log?file=__shard_2/error_log_insert_stmt_7602ccd7c3a4854-95307efca7bfe342_7602ccd7c3a4854_95307efca7bfe342
    JobDetails: {"Unfinished backends":{"7602ccd7c3a4854-95307efca7bfe341":[]},"ScannedRows":4,"TaskNumber":1,"LoadBytes":188,"All backends":{"7602ccd7c3a4854-95307efca7bfe341":[10022]},"FileNumber":3,"FileSize":4839}
 TransactionId: 769213
  ErrorTablets: {}
          User: root
       Comment:
Шаг 2: определите тип ошибки. В приведённом выше примере возникла ошибка качества данных (ETL_QUALITY_UNSATISFIED). Откройте URL из результатов команды, чтобы просмотреть подробности ошибки. Например, приведённая ниже ошибка означает, что длина данных превышает допустимую длину столбца country, заданную в схеме:
[root@VM-10-6-centos ~]$ curl "http://10.16.10.6:28747/api/_load_error_log?file=__shard_2/error_log_insert_stmt_7602ccd7c3a4854-95307efca7bfe342_7602ccd7c3a4854_95307efca7bfe342"
Reason: column_name[country], the length of input is too long than schema. first 32 bytes of input str: [USA] schema length: 1; actual length: 3; . src line [];
Reason: column_name[country], the length of input is too long than schema. first 32 bytes of input str: [Canada] schema length: 1; actual length: 6; . src line [];
Reason: column_name[country], the length of input is too long than schema. first 32 bytes of input str: [UK] schema length: 1; actual length: 2; . src line [];
Reason: column_name[country], the length of input is too long than schema. first 32 bytes of input str: [Australia] schema length: 1; actual length: 9; . src line [];
Шаг 3: задайте допустимую долю ошибок (необязательно). Если допустимо пропустить часть строк с ошибками, задайте допустимую долю ошибок в PROPERTIES для S3 Load. Подробнее см. в разделе Параметры настройки загрузки.
3.4 Загружайте несколько партиций пакетами
При переносе больших объёмов исторических данных соблюдайте следующие рекомендации по пакетной загрузке:
- Каждый пакет должен соответствовать одной партиции Doris или небольшому числу партиций.
- Размер одного пакета не должен превышать 100 GB, чтобы снизить нагрузку на систему и затраты на повторную попытку после сбоя загрузки.
- В качестве примера можно использовать скрипт s3_load_demo.sh. Он перебирает каталоги партиций в S3 и автоматически отправляет в Doris задания S3 Load для пакетной загрузки.
Часто задаваемые вопросы
Вопрос 1: Почему данные типа TIME из Redshift нельзя загрузить напрямую в Doris?
Doris не поддерживает тип TIME. Перед экспортом из Redshift данных типа TIME/TIMEZ необходимо использовать CAST для преобразования в VARCHAR, а в Doris хранить их как STRING.
Вопрос 2: Можно ли использовать S3 Load для файлов Parquet/ORC, содержащих сложные типы, например Struct/Array/Map?
Нет. В настоящее время для файлов со сложными типами необходимо использовать TVF Load.
Вопрос 3: Загрузка S3 Load синхронная или асинхронная? Как узнать результат?
S3 Load использует асинхронный метод загрузки. После отправки задания выполните SHOW LOAD WHERE label = "<your_label>", чтобы проверить ход загрузки и результат.
Вопрос 4: Как обработать ошибку ETL_QUALITY_UNSATISFIED?
Эта ошибка означает, что качество данных не соответствует требованиям. Чтобы её устранить:
- Откройте
URL, возвращённый командойSHOW LOAD, чтобы получить подробный журнал ошибок. - Измените схему таблицы Doris или исходные данные на основе журнала ошибок (например, при превышении длины поля или несоответствии типов).
- Если часть строк с ошибками можно пропустить, измените допустимую долю ошибок
max_filter_ratioвPROPERTIESдля S3 Load.
Вопрос 5: Как избежать сбоя при единовременной загрузке больших объёмов данных?
Рекомендуется загружать данные пакетами по партициям Doris, поддерживать размер каждого пакета менее 100 GB и использовать скрипт s3_load_demo.sh для автоматической отправки пакетов на загрузку.