Broker Load
Broker Load запускается через MySQL API. Doris самостоятельно получает данные из удалённого источника в соответствии с информацией в операторе LOAD. Это асинхронный метод загрузки. После отправки задания необходимо использовать оператор SHOW LOAD, чтобы проверить ход и результат загрузки.
Этот метод устарел и будет удалён в версии 5.0. Используйте вместо него "insert into table select xxx from tvf or catalog table".
Broker Load подходит для следующих типичных сценариев:
- Исходные данные хранятся в удалённой системе, например в объектном хранилище или HDFS.
- Объём данных для одной загрузки велик: от GB до TB.
- Вы хотите загружать данные асинхронно, пакетами, чтобы Doris самостоятельно управлял параллельным выполнением и повторными попытками.
Также можно загружать данные через HDFS TVF или S3 TVF из раздела Lakehouse / TVF в сочетании с
INSERT INTO. В настоящее времяINSERT INTOна основе TVF выполняет синхронную загрузку, а Broker Load — асинхронную.
В ранних версиях Doris методы S3 Load и HDFS Load подключались к определённому процессу Broker через WITH BROKER. По мере развития версий S3 Load и HDFS Load перестали зависеть от дополнительного процесса Broker, но по-прежнему используют синтаксис, похожий на Broker Load. По историческим причинам и из-за сходства синтаксиса S3 Load, HDFS Load и Broker Load объединяют под общим названием Broker Load.
Ограничения
В следующей таблице перечислены возможности Broker Load:
| Характеристика | Поддерживаемые возможности |
|---|---|
| Хранилище | Протокол S3, протокол HDFS, другие протоколы (требуется соответствующий процесс Broker) |
| Шаблон пути к файлу | Подстановочные символы *, ?, [abc], [a-z]; раскрытие диапазонов {1..10}, {a,b,c}. Полный синтаксис приведён в разделе Шаблон пути к файлу. |
| Формат данных | CSV, JSON, PARQUET, ORC |
| Тип сжатия | PLAIN, GZ, LZO, BZ2, LZ4FRAME, DEFLATE, LZOP, LZ4BLOCK, SNAPPYBLOCK, ZLIB, ZSTD |
Основные принципы
После отправки задания загрузки:
- FE формирует соответствующий план и распределяет его для выполнения между несколькими узлами BE с учётом текущего количества узлов BE и размера файла.
- Каждый BE отвечает за загрузку части данных: получает данные из Broker, преобразует их и записывает в Doris.
- После завершения загрузки на всех узлах BE узел FE принимает окончательное решение об успешности загрузки.
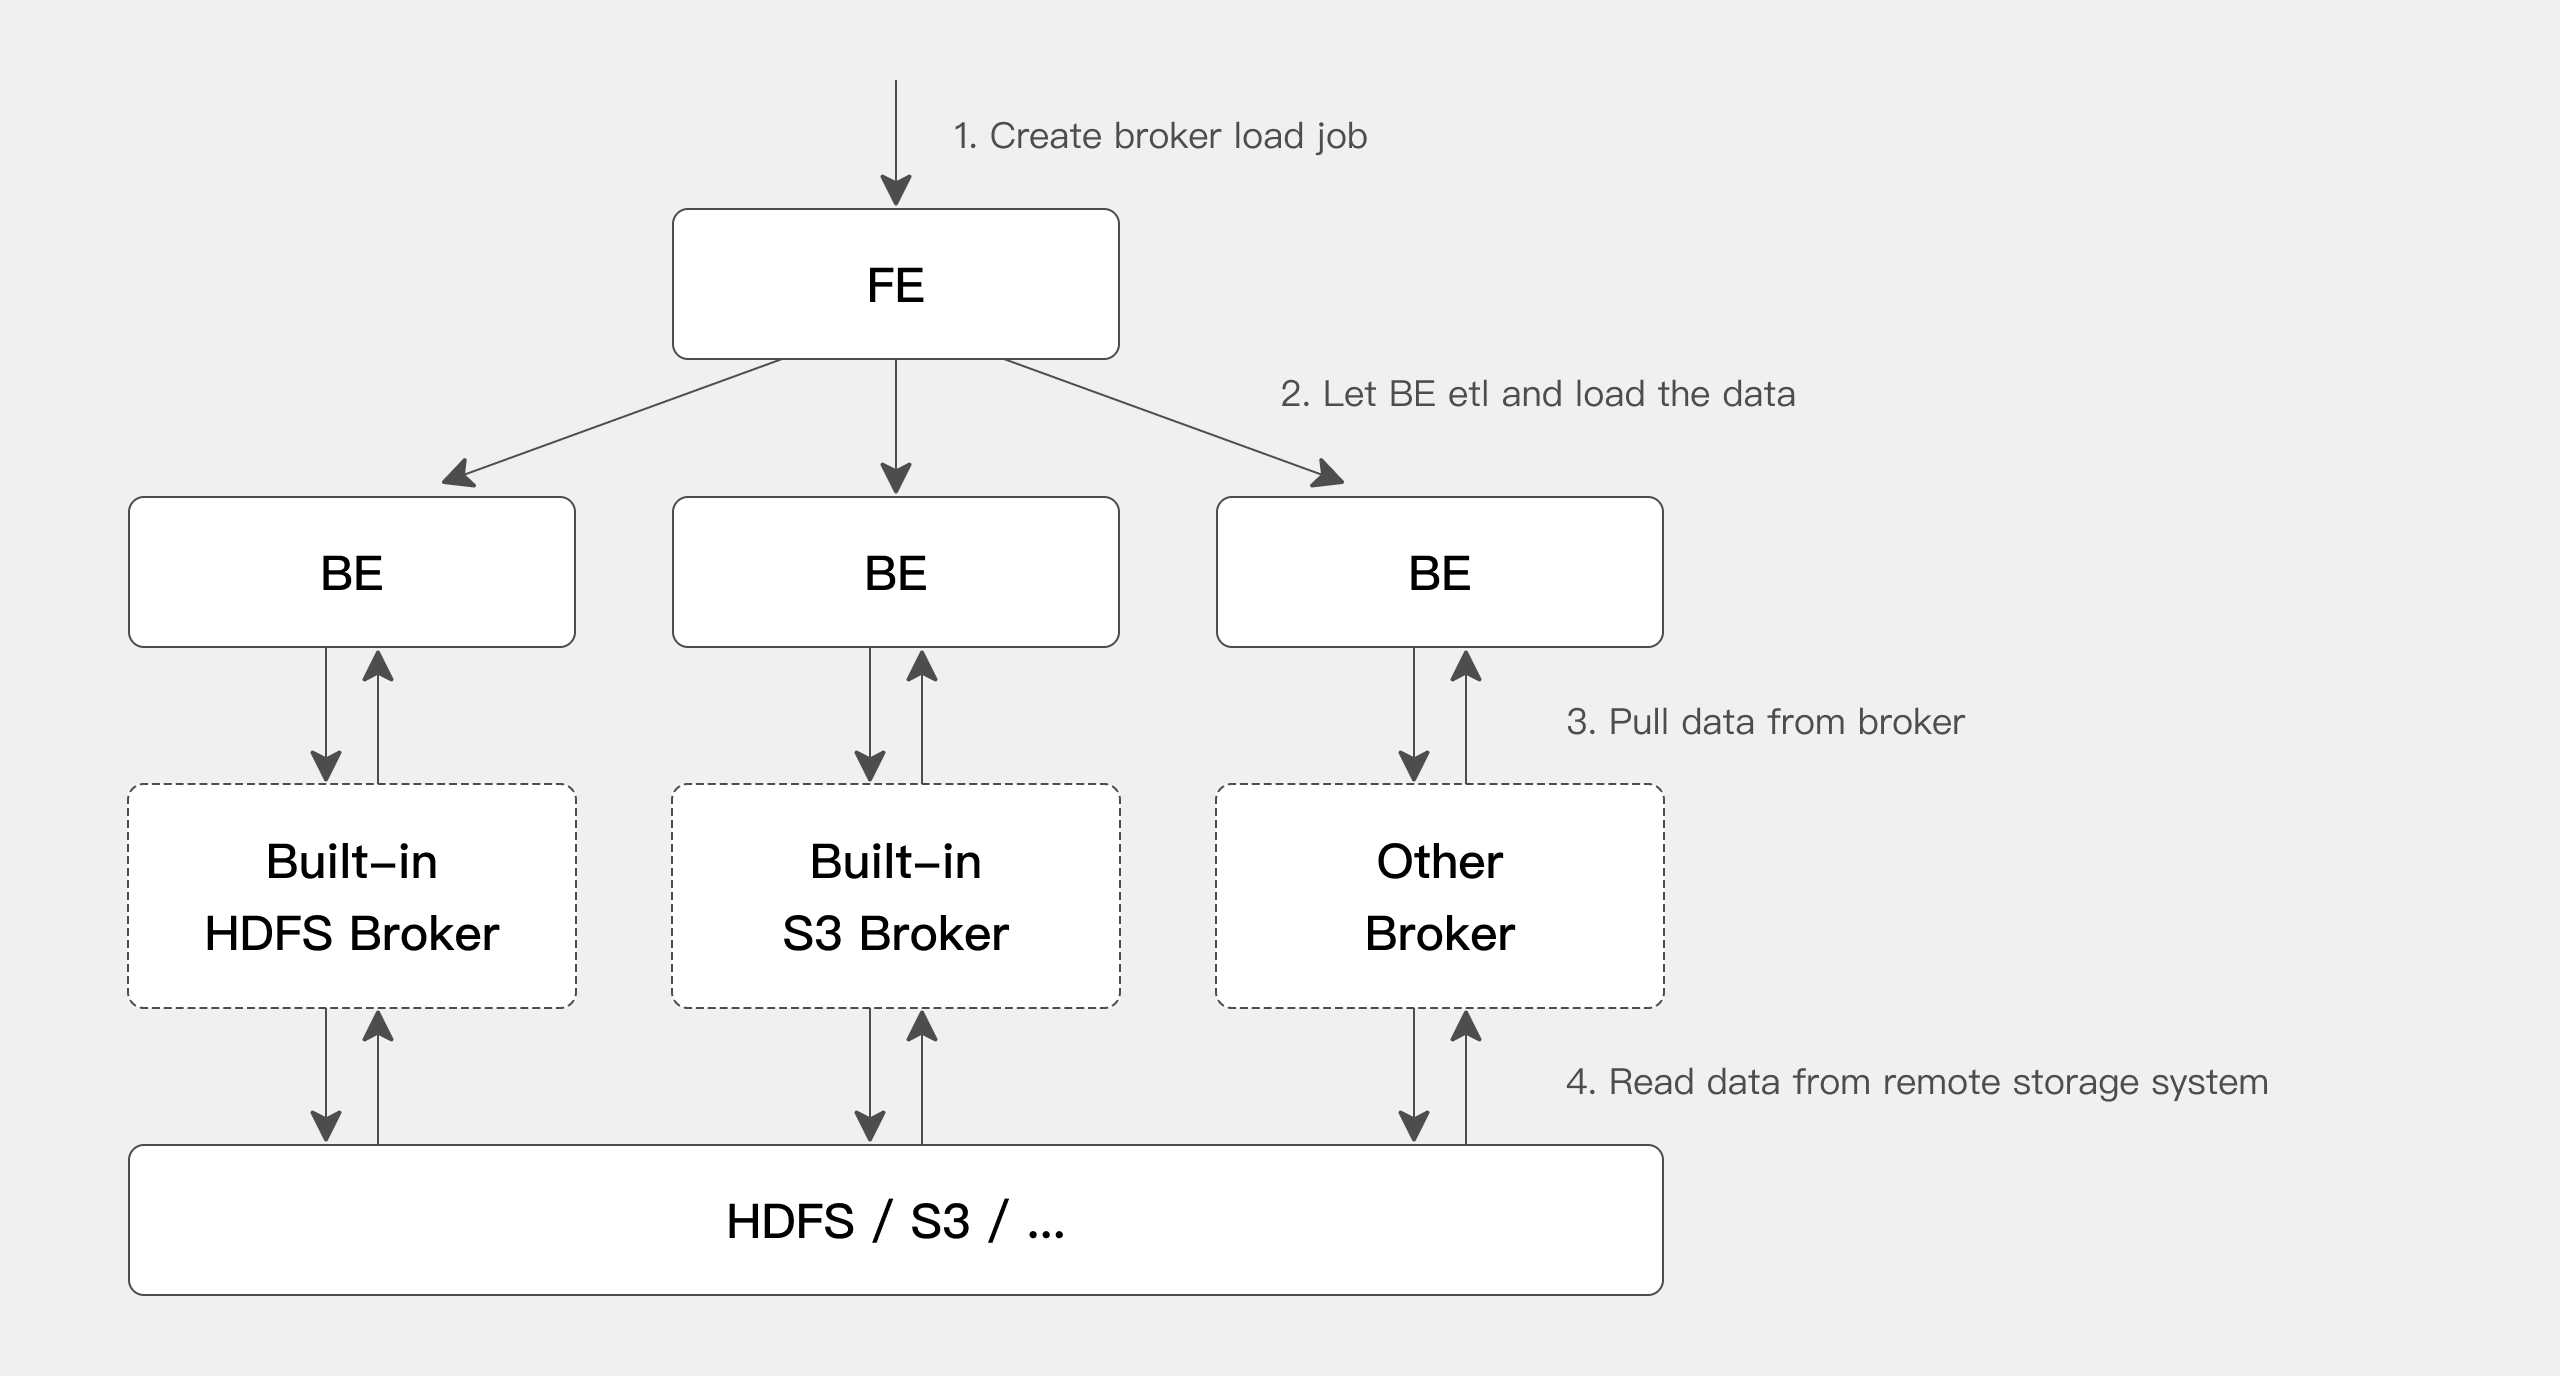
BE читает данные из удалённого хранилища через процесс Broker. Основные цели использования Broker:
- Совместимость с экосистемой: разработка на Java в соответствии со стандартом Broker упрощает поддержку различных систем хранения в экосистеме больших данных.
- Изоляция ошибок: процесс Broker отделён от процесса BE, что повышает стабильность BE.
BE имеет встроенную поддержку HDFS и S3, поэтому для загрузки данных из HDFS или S3 не требуется запускать дополнительный процесс Broker. Если вы используете собственную реализацию Broker, необходимо развернуть соответствующий процесс Broker.
Быстрый старт
В этом разделе весь процесс показан на примере S3 Load. Полный синтаксис приведён в разделе Broker Load руководства по SQL.
Предварительные проверки
1. Права на таблицу Doris
Для Broker Load требуется право INSERT на целевую таблицу. Если у вас нет этого права, предоставьте его командой GRANT.
2. Данные аутентификации и подключения к S3
Рассмотрим AWS S3 в качестве примера (для других объектных хранилищ можно действовать аналогично):
| Сведения | Как получить |
|---|---|
| AK / SK | Просмотрите или создайте Access keys в разделе My Security Credentials консоли AWS. |
| REGION | Выбирается при создании бакета; также отображается в списке бакетов. |
| ENDPOINT | См. документацию AWS: конечные точки S3. |
Создание задания загрузки
Шаг 1: подготовьте CSV-файл в S3
Создайте brokerload_example.csv со следующим содержимым:
1,Emily,25
2,Benjamin,35
3,Olivia,28
4,Alexander,60
5,Ava,17
6,William,69
7,Sophia,32
8,James,64
9,Emma,37
10,Liam,64
Шаг 2: создайте целевую таблицу в Doris
CREATE TABLE testdb.test_brokerload(
    user_id            BIGINT       NOT NULL COMMENT "user id",
    name               VARCHAR(20)           COMMENT "name",
    age                INT                   COMMENT "age"
)
DUPLICATE KEY(user_id)
DISTRIBUTED BY HASH(user_id) BUCKETS 10;
Шаг 3: отправьте задание Broker Load
Замените имя бакета и данные аутентификации S3 фактическими значениями:
LOAD LABEL broker_load_2022_04_01
(
    DATA INFILE("s3://your_bucket_name/brokerload_example.csv")
    INTO TABLE test_brokerload
    COLUMNS TERMINATED BY ","
    FORMAT AS "CSV"
    (user_id, name, age)
)
WITH S3
(
    "provider" = "S3",
    "AWS_ENDPOINT" = "https://s3.us-west-2.amazonaws.com",
    "AWS_ACCESS_KEY" = "<your-ak>",
    "AWS_SECRET_KEY"="<your-sk>",
    "AWS_REGION" = "us-west-2",
    "compress_type" = "PLAIN"
)
PROPERTIES
(
    "timeout" = "3600"
);
Поле provider необходимо заполнить в соответствии с фактическим поставщиком объектного хранилища. Doris поддерживает следующие значения provider:
| provider | Поставщик |
|---|---|
S3 | Amazon AWS |
AZURE | Microsoft Azure |
GCP | Google GCP |
OSS | Alibaba Cloud |
COS | Tencent Cloud |
OBS | Huawei Cloud |
BOS | Baidu Cloud |
Если поставщика нет в списке (например, MinIO), можно попробовать использовать S3 (режим совместимости с AWS).
Просмотр задания загрузки
Broker Load выполняет загрузку асинхронно. Результат можно просмотреть с помощью команды SHOW LOAD:
mysql> show load order by createtime desc limit 1\G;
*************************** 1. row ***************************
         JobId: 41326624
         Label: broker_load_2022_04_01
         State: FINISHED
      Progress: ETL:100%; LOAD:100%
          Type: BROKER
       EtlInfo: unselected.rows=0; dpp.abnorm.ALL=0; dpp.norm.ALL=27
      TaskInfo: cluster:N/A; timeout(s):1200; max_filter_ratio:0.1
      ErrorMsg: NULL
    CreateTime: 2022-04-01 18:59:06
  EtlStartTime: 2022-04-01 18:59:11
 EtlFinishTime: 2022-04-01 18:59:11
 LoadStartTime: 2022-04-01 18:59:11
LoadFinishTime: 2022-04-01 18:59:11
           URL: NULL
    JobDetails: {"Unfinished backends":{"5072bde59b74b65-8d2c0ee5b029adc0":[]},"ScannedRows":27,"TaskNumber":1,"All backends":{"5072bde59b74b65-8d2c0ee5b029adc0":[36728051]},"FileNumber":1,"FileSize":5540}
1 row in set (0.01 sec)
Отмена задания загрузки
Если задание Broker Load не находится в состоянии CANCELLED или FINISHED, его можно отменить вручную. При отмене необходимо указать метку задания. Синтаксис приведён в разделе CANCEL LOAD.
Например, чтобы отменить задание загрузки с меткой broker_load_2022_04_01 в базе данных demo:
CANCEL LOAD FROM demo WHERE LABEL = "broker_load_2022_04_01";
Привязка вычислительной группы
В режиме с разделением хранения и вычислений Broker Load выбирает вычислительную группу в следующем порядке приоритета:
- Вычислительная группа, указанная в операторе
use db@cluster. - Вычислительная группа, указанная в свойстве пользователя
default_compute_group. - Одна из вычислительных групп, к которым у текущего пользователя есть доступ.
В режиме с совместным хранением и вычислениями выбирается вычислительная группа, указанная в свойстве пользователя resource_tags.location. Если это свойство пользователя не задано, используется вычислительная группа с именем default.
Справочная информация
Синтаксис команды загрузки
LOAD LABEL load_label
(
data_desc1[, data_desc2, ...]
[format_properties]
)
WITH [S3|HDFS|BROKER broker_name]
[broker_properties]
[load_properties]
[COMMENT "comments"];
Предложение WITH определяет способ доступа к системе хранения, а broker_properties задаёт параметры конфигурации для этого способа:
| Предложение | Описание |
|---|---|
S3 | Система хранения, использующая протокол S3. |
HDFS | Система хранения, использующая протокол HDFS. |
BROKER broker_name | Системы хранения, использующие другие протоколы. Список доступных broker_name можно просмотреть с помощью SHOW BROKER. Подробнее см. ниже в разделе «Другие способы загрузки через Broker». |
Параметры конфигурации загрузки
Свойства загрузки
| Имя свойства | Тип | Значение по умолчанию | Описание |
|---|---|---|---|
timeout | Long | 14400 | Время ожидания загрузки в секундах. Диапазон: от 1 до 259200 секунд. |
max_filter_ratio | Float | 0.0 | Максимально допустимая доля некорректных данных. По умолчанию некорректные данные не допускаются. Диапазон значений: от 0 до 1. Если доля ошибок превышает это значение, загрузка завершается с ошибкой. Строки, отфильтрованные условием WHERE, не считаются некорректными данными. |
strict_mode | Boolean | false | Включать ли строгий режим. |
partial_columns | Boolean | false | Использовать ли частичное обновление столбцов. Действует только для таблиц Unique Key с Merge on Write. |
timezone | String | "Asia/Shanghai" | Часовой пояс для этой загрузки. Влияет на результат всех функций, связанных с часовыми поясами. |
load_parallelism | Integer | 8 | Верхний предел количества параллельных экземпляров на каждом BE. |
send_batch_parallelism | Integer | 1 | Степень параллелизма узла sink при отправке данных. Действует только при отключённом memtable-on-sink. |
load_to_single_tablet | Boolean | false | Загружать ли данные только в один tablet на раздел. Допускается только для таблиц OLAP со случайным распределением по бакетам. |
priority | HIGH / NORMAL / LOW | NORMAL | Приоритет задания загрузки. |
Свойства формата
| Имя параметра | Тип | Значение по умолчанию | Описание |
|---|---|---|---|
skip_lines | Integer | 0 | Пропустить указанное количество строк в начале CSV-файла. Не действует для форматов csv_with_names и csv_with_names_and_types. |
trim_double_quotes | Boolean | false | Удалять ли внешние двойные кавычки у полей. |
enclose | String | "" | Символ обрамления для полей, содержащих перевод строки или разделитель. Например, если разделитель — ,, а символ обрамления — ', то 'b,c' разбирается как одно поле. |
escape | String | "" | Символ экранирования, используемый для экранирования символа обрамления. Например, если символ экранирования — \, а символ обрамления — ', поле 'b,\'c' корректно разбирается как 'b,'c'. |
- Параметры формата определяют, как разбирается исходный файл (например, разделители и обработка кавычек). Их следует задавать в предложении
PROPERTIESвнутри оператораLOAD. - Параметры загрузки управляют поведением загрузки (например, временем ожидания и повторными попытками). Их следует задавать во внешнем блоке
PROPERTIESза пределами оператораLOAD.
LOAD LABEL s3_load_example (
    DATA INFILE("s3://bucket/path/file.csv")
    INTO TABLE users
    COLUMNS TERMINATED BY ","
    FORMAT AS "CSV"
    (user_id, name, age)
    PROPERTIES (
        "trim_double_quotes" = "true"  -- Format parameter
    )
)
WITH S3 (
    ...
)
PROPERTIES (
    "timeout" = "3600"  -- Load parameter
);
Системные параметры конфигурации fe.conf
Следующие системные параметры конфигурации Broker Load применяются ко всем заданиям загрузки Broker Load. Обычно их настраивают в файле fe.conf.
| Параметр конфигурации | Тип | Значение по умолчанию | Описание |
|---|---|---|---|
min_bytes_per_broker_scanner | Long | 67108864 (64 MB) | Минимальный объём данных, обрабатываемый одним BE, в байтах. |
max_bytes_per_broker_scanner | Long | 536870912000 (500 GB) | Максимальный объём данных, обрабатываемый одним BE, в байтах. Максимальный объём данных для одного задания загрузки приблизительно равен max_bytes_per_broker_scanner * number of BE nodes. Если требуется загрузить больший объём данных, увеличьте это значение соответствующим образом. |
max_broker_concurrency | Integer | 10 | Максимальная степень параллелизма загрузки для одного задания. |
default_load_parallelism | Integer | 8 | Максимальное количество параллельных экземпляров на узел BE. |
broker_load_default_timeout_second | Integer | 14400 | Время ожидания загрузки Broker Load по умолчанию в секундах. |
Расчёт степени параллелизма загрузки
Степень параллелизма этой загрузки определяется совместно минимальным объёмом обрабатываемых данных, максимальной степенью параллелизма, размером исходного файла и текущим количеством узлов BE в кластере:
Concurrency of this import = Math.min(source file size / min_bytes_per_broker_scanner, max_broker_concurrency, number of current BE nodes * load_parallelism)
Amount processed by a single BE for this import = source file size / concurrency of this import
Переменные сеанса
| Переменная сеанса | Тип | Значение по умолчанию | Описание |
|---|---|---|---|
time_zone | String | "Asia/Shanghai" | Часовой пояс по умолчанию, влияющий на результат функций, связанных с часовыми поясами, во время загрузки. |
send_batch_parallelism | Integer | 1 | Степень параллелизма узла sink при отправке данных. Действует только при отключённом memtable-on-sink. |
Примеры загрузки
Следующие типичные сценарии показывают распространённые способы использования Broker Load.
Сценарий 1: загрузка TXT-файла из HDFS
LOAD LABEL demo.label_20220402
(
    DATA INFILE("hdfs://host:port/tmp/test_hdfs.txt")
    INTO TABLE `load_hdfs_file_test`
    COLUMNS TERMINATED BY "\t"
    (id,age,name)
)
with HDFS
(
    "fs.defaultFS"="hdfs://host:port",
    "hadoop.username" = "user"
)
PROPERTIES
(
    "timeout"="1200",
    "max_filter_ratio"="0.1"
);
Сценарий 2: HDFS с конфигурацией NameNode HA
LOAD LABEL demo.label_20220402
(
    DATA INFILE("hdfs://hafs/tmp/test_hdfs.txt")
    INTO TABLE `load_hdfs_file_test`
    COLUMNS TERMINATED BY "\t"
    (id,age,name)
)
with HDFS
(
    "hadoop.username" = "user",
    "fs.defaultFS"="hdfs://hafs",
    "dfs.nameservices" = "hafs",
    "dfs.ha.namenodes.hafs" = "my_namenode1, my_namenode2",
    "dfs.namenode.rpc-address.hafs.my_namenode1" = "nn1_host:rpc_port",
    "dfs.namenode.rpc-address.hafs.my_namenode2" = "nn2_host:rpc_port",
    "dfs.client.failover.proxy.provider.hafs" = "org.apache.hadoop.hdfs.server.namenode.ha.ConfiguredFailoverProxyProvider"
)
PROPERTIES
(
    "timeout"="1200",
    "max_filter_ratio"="0.1"
);
Сценарий 3: выбор двух наборов файлов с помощью подстановочных символов и их загрузка в две таблицы
Broker Load поддерживает подстановочные символы (*, ?, [...]) и шаблоны диапазонов ({1..10}) в пути к файлу. Полный синтаксис приведён в разделе Шаблон пути к файлу.
LOAD LABEL example_db.label2
(
    DATA INFILE("hdfs://host:port/input/file-10*")
    INTO TABLE `my_table1`
    PARTITION (p1)
    COLUMNS TERMINATED BY ","
    (k1, tmp_k2, tmp_k3)
    SET (
        k2 = tmp_k2 + 1,
        k3 = tmp_k3 + 1
    ),
    DATA INFILE("hdfs://host:port/input/file-20*")
    INTO TABLE `my_table2`
    COLUMNS TERMINATED BY ","
    (k1, k2, k3)
)
with HDFS
(
    "fs.defaultFS"="hdfs://host:port",
    "hadoop.username" = "user"
);
Используйте подстановочные символы для выбора двух наборов файлов file-10* и file-20* и загрузки их в my_table1 и my_table2 соответственно. Данные для my_table1 загружаются в раздел p1, а значения второго и третьего столбцов исходного файла перед загрузкой увеличиваются на 1.
Сценарий 4: загрузка набора данных из HDFS с помощью подстановочных символов
LOAD LABEL example_db.label3
(
    DATA INFILE("hdfs://host:port/user/doris/data/*/*")
    INTO TABLE `my_table`
    COLUMNS TERMINATED BY "\\x01"
)
with HDFS
(
    "fs.defaultFS"="hdfs://host:port",
    "hadoop.username" = "user"
);
Укажите разделитель \\x01, который обычно используется в Hive по умолчанию, и используйте подстановочный символ *, чтобы выбрать все файлы во всех подкаталогах каталога data.
Сценарий 5: загрузка данных в формате Parquet
LOAD LABEL example_db.label4
(
    DATA INFILE("hdfs://host:port/input/file")
    INTO TABLE `my_table`
    FORMAT AS "parquet"
    (k1, k2, k3)
)
with HDFS
(
    "fs.defaultFS"="hdfs://host:port",
    "hadoop.username" = "user"
);
Если FORMAT AS не указан, по умолчанию формат определяется по расширению файла.
Сценарий 6: извлечение полей раздела из пути к файлу
LOAD LABEL example_db.label5
(
    DATA INFILE("hdfs://host:port/input/city=beijing/*/*")
    INTO TABLE `my_table`
    FORMAT AS "csv"
    (k1, k2, k3)
    COLUMNS FROM PATH AS (city, utc_date)
)
with HDFS
(
    "fs.defaultFS"="hdfs://host:port",
    "hadoop.username" = "user"
);
Таблица my_table содержит столбцы k1, k2, k3, city, utc_date.
Каталог hdfs://hdfs_host:hdfs_port/user/doris/data/input/dir/city=beijing содержит следующие файлы:
hdfs://hdfs_host:hdfs_port/input/city=beijing/utc_date=2020-10-01/0000.csv
hdfs://hdfs_host:hdfs_port/input/city=beijing/utc_date=2020-10-02/0000.csv
hdfs://hdfs_host:hdfs_port/input/city=tianji/utc_date=2020-10-03/0000.csv
hdfs://hdfs_host:hdfs_port/input/city=tianji/utc_date=2020-10-04/0000.csv
Файлы содержат только три столбца: k1, k2, k3. Ещё два столбца, city и utc_date, извлекаются из пути к файлу.
Сценарий 7: фильтрация загружаемых данных
LOAD LABEL example_db.label6
(
    DATA INFILE("hdfs://host:port/input/file")
    INTO TABLE `my_table`
    (k1, k2, k3)
    SET (
        k2 = k2 + 1
    )
    PRECEDING FILTER k1 = 1
    WHERE k1 > k2
)
with HDFS
(
    "fs.defaultFS"="hdfs://host:port",
    "hadoop.username" = "user"
);
Загружаются только те строки, для которых в исходных данных выполняется k1 = 1, а после преобразования — k1 > k2.
Сценарий 8: извлечение временного поля раздела из пути к файлу
LOAD LABEL example_db.label7
(
    DATA INFILE("hdfs://host:port/user/data/*/test.txt")
    INTO TABLE `tbl12`
    COLUMNS TERMINATED BY ","
    (k2,k3)
    COLUMNS FROM PATH AS (data_time)
    SET (
        data_time=str_to_date(data_time, '%Y-%m-%d %H%%3A%i%%3A%s')
    )
)
with HDFS
(
    "fs.defaultFS"="hdfs://host:port",
    "hadoop.username" = "user"
);
Время содержит %3A. В путях HDFS символ : не допускается, поэтому все символы : заменены на %3A.
По этому пути находятся следующие файлы:
/user/data/data_time=2020-02-17 00%3A00%3A00/test.txt
/user/data/data_time=2020-02-18 00%3A00%3A00/test.txt
Схема таблицы:
CREATE TABLE IF NOT EXISTS tbl12 (
    data_time DATETIME,
    k2        INT,
    k3        INT
) DISTRIBUTED BY HASH(data_time) BUCKETS 10
PROPERTIES (
    "replication_num" = "3"
);
Сценарий 9: загрузка со слиянием
LOAD LABEL example_db.label8
(
    MERGE DATA INFILE("hdfs://host:port/input/file")
    INTO TABLE `my_table`
    (k1, k2, k3, v2, v1)
    DELETE ON v2 > 100
)
with HDFS
(
    "fs.defaultFS"="hdfs://host:port",
    "hadoop.username"="user"
)
PROPERTIES
(
    "timeout" = "3600",
    "max_filter_ratio" = "0.1"
);
my_table должна быть таблицей Unique Key. Если для загружаемых данных выполняется v2 > 100, строка обрабатывается как удаление. Время ожидания загрузки составляет 3600 секунд, а допустимая доля ошибок — 10%.
Сценарий 10: указание столбца source_sequence для обеспечения порядка замены
LOAD LABEL example_db.label9
(
    DATA INFILE("hdfs://host:port/input/file")
    INTO TABLE `my_table`
    COLUMNS TERMINATED BY ","
    (k1,k2,source_sequence,v1,v2)
    ORDER BY source_sequence
)
with HDFS
(
    "fs.defaultFS"="hdfs://host:port",
    "hadoop.username"="user"
);
my_table должна быть таблицей модели Unique Key с заданным столбцом Sequence. Порядок данных обеспечивается значением столбца source_sequence в исходных данных.
Сценарий 11: загрузка JSON с использованием json_root / jsonpaths
LOAD LABEL example_db.label10
(
    DATA INFILE("hdfs://host:port/input/file.json")
    INTO TABLE `my_table`
    FORMAT AS "json"
    PROPERTIES(
      "json_root" = "$.item",
      "jsonpaths" = "[\"$.id\", \"$.city\", \"$.code\"]"
    )
)
with HDFS
(
    "fs.defaultFS"="hdfs://host:port",
    "hadoop.username"="user"
);
jsonpaths также можно использовать вместе с column list и SET (column_mapping):
LOAD LABEL example_db.label10
(
    DATA INFILE("hdfs://host:port/input/file.json")
    INTO TABLE `my_table`
    FORMAT AS "json"
    (id, code, city)
    SET (id = id * 10)
    PROPERTIES(
      "json_root" = "$.item",
      "jsonpaths" = "[\"$.id\", \"$.city\", \"$.code\"]"
    )
)
with HDFS
(
    "fs.defaultFS"="hdfs://host:port",
    "hadoop.username"="user"
);
Чтобы загрузить объект JSON из корневого узла JSON-файла, задайте для jsonpaths значение $., то есть PROPERTIES("jsonpaths"="$.").
Расширенная настройка
Стиль доступа к URL в S3 Load
По умолчанию S3 SDK использует стиль доступа virtual-hosted-style. Однако в некоторых объектных хранилищах virtual-hosted-style отключён или не поддерживается. Чтобы принудительно использовать path-style, можно добавить параметр use_path_style:
WITH S3
(
    "AWS_ENDPOINT" = "AWS_ENDPOINT",
    "AWS_ACCESS_KEY" = "AWS_ACCESS_KEY",
    "AWS_SECRET_KEY"="AWS_SECRET_KEY",
    "AWS_REGION" = "AWS_REGION",
    "use_path_style" = "true"
)
Временные учётные данные S3 Load
Для доступа к любому объектному хранилищу, поддерживающему протокол S3, можно использовать временные учётные данные (TOKEN):
WITH S3
(
    "AWS_ENDPOINT" = "AWS_ENDPOINT",
    "AWS_ACCESS_KEY" = "AWS_TEMP_ACCESS_KEY",
    "AWS_SECRET_KEY" = "AWS_TEMP_SECRET_KEY",
    "AWS_TOKEN" = "AWS_TEMP_TOKEN",
    "AWS_REGION" = "AWS_REGION"
)
Аутентификация HDFS
1. Простая аутентификация
Простая аутентификация означает, что для параметра конфигурации Hadoop hadoop.security.authentication задано значение simple:
(
    "username" = "user",
    "password" = ""
);
Укажите в username имя пользователя для доступа и оставьте пароль пустым.
2. Аутентификация Kerberos
Для этого способа аутентификации требуются следующие сведения:
| Параметр | Описание |
|---|---|
hadoop.security.authentication | Задаёт способ аутентификации kerberos. |
hadoop.kerberos.principal | Задаёт принципал Kerberos. |
hadoop.kerberos.keytab | Задаёт путь к файлу keytab Kerberos. Необходимо указать абсолютный путь на сервере, где работает процесс Broker; файл должен быть доступен этому процессу. |
kerberos_keytab_content | Задаёт содержимое файла keytab в кодировке base64. Используйте либо этот параметр, либо hadoop.kerberos.keytab. |
Пример:
(
    "hadoop.security.authentication" = "kerberos",
    "hadoop.kerberos.principal" = "doris@YOUR.COM",
    "hadoop.kerberos.keytab" = "/home/doris/my.keytab"
)
(
    "hadoop.security.authentication" = "kerberos",
    "hadoop.kerberos.principal" = "doris@YOUR.COM",
    "kerberos_keytab_content" = "ASDOWHDLAWIDJHWLDKSALDJSDIWALD"
)
Для аутентификации Kerberos требуется файл krb5.conf. Он содержит конфигурацию Kerberos и обычно находится в каталоге /etc. Расположение по умолчанию также можно переопределить через переменную окружения KRB5_CONFIG. Пример содержимого krb5.conf:
[libdefaults]
    default_realm = DORIS.HADOOP
    default_tkt_enctypes = des3-hmac-sha1 des-cbc-crc
    default_tgs_enctypes = des3-hmac-sha1 des-cbc-crc
    dns_lookup_kdc = true
    dns_lookup_realm = false

[realms]
    DORIS.HADOOP = {
        kdc = kerberos-doris.hadoop.service:7005
    }
Режим HDFS HA
Эта конфигурация используется для доступа к кластеру HDFS, развёрнутому в режиме HA.
| Параметр | Описание |
|---|---|
dfs.nameservices | Задаёт имя службы HDFS (определяется пользователем), например "dfs.nameservices" = "my_ha". |
dfs.ha.namenodes.xxx | Заданные пользователем имена NameNode (несколько имён разделяются запятыми). xxx — имя, заданное пользователем в dfs.nameservices, например "dfs.ha.namenodes.my_ha" = "my_nn". |
dfs.namenode.rpc-address.xxx.nn | Задаёт RPC-адрес NameNode. nn — имя NameNode из dfs.ha.namenodes.xxx, например "dfs.namenode.rpc-address.my_ha.my_nn" = "host:port". |
dfs.client.failover.proxy.provider.[nameservice ID] | Задаёт провайдер, используемый клиентом для подключения к NameNode. Значение по умолчанию — org.apache.hadoop.hdfs.server.namenode.ha.ConfiguredFailoverProxyProvider. |
Пример:
(
    "fs.defaultFS" = "hdfs://my_ha",
    "dfs.nameservices" = "my_ha",
    "dfs.ha.namenodes.my_ha" = "my_namenode1, my_namenode2",
    "dfs.namenode.rpc-address.my_ha.my_namenode1" = "nn1_host:rpc_port",
    "dfs.namenode.rpc-address.my_ha.my_namenode2" = "nn2_host:rpc_port",
    "dfs.client.failover.proxy.provider.my_ha" = "org.apache.hadoop.hdfs.server.namenode.ha.ConfiguredFailoverProxyProvider"
)
Режим HA можно сочетать с обоими описанными выше способами аутентификации. Например, доступ к HDFS в режиме HA с простой аутентификацией:
(
    "username"="user",
    "password"="passwd",
    "fs.defaultFS" = "hdfs://my_ha",
    "dfs.nameservices" = "my_ha",
    "dfs.ha.namenodes.my_ha" = "my_namenode1, my_namenode2",
    "dfs.namenode.rpc-address.my_ha.my_namenode1" = "nn1_host:rpc_port",
    "dfs.namenode.rpc-address.my_ha.my_namenode2" = "nn2_host:rpc_port",
    "dfs.client.failover.proxy.provider.my_ha" = "org.apache.hadoop.hdfs.server.namenode.ha.ConfiguredFailoverProxyProvider"
)
Другие способы загрузки через Broker
Процессы Broker для других удалённых систем хранения — необязательные компоненты кластера Doris. В основном они обеспечивают чтение и запись файлов и каталогов в удалённом хранилище. В настоящее время Doris предоставляет реализации Broker для следующих удалённых систем хранения:
- Tencent Cloud CHDFS
- Tencent Cloud GFS
- JuiceFS
В ранних версиях Doris также поддерживал Broker для различных объектных хранилищ, но сейчас для загрузки данных из объектных хранилищ рекомендуется использовать WITH S3; использование WITH BROKER больше не рекомендуется.
Broker — это Java-процесс без сохранения состояния, предоставляющий сервисы через RPC-порт. Он инкапсулирует файловые операции, аналогичные POSIX (например, open, pread, pwrite), для чтения и записи в удалённом хранилище. Broker не сохраняет никакую другую информацию. Все необходимые сведения, включая данные подключения, сведения о файлах и правах доступа к удалённому хранилищу, должны передаваться в качестве параметров RPC-вызовов.
Broker служит только для передачи данных и не участвует в вычислениях, поэтому потребляет мало памяти. Обычно в системе Doris развёртывают один или несколько процессов Broker. Процессы Broker одного типа образуют группу с общим именем (именем Broker).
Сведения о Broker
Сведения о Broker состоят из двух частей: имя и данные аутентификации. Общий синтаксис:
WITH BROKER "broker_name"
(
    "username" = "xxx",
    "password" = "yyy",
    "other_prop" = "prop_value",
    ...
);
Имя (имя Broker)
Укажите существующее имя Broker в предложении WITH BROKER "broker_name". Имя Broker задаётся пользователем при добавлении процесса Broker командой ALTER SYSTEM ADD BROKER. Обычно одному имени соответствует один или несколько процессов Broker, и Doris выбирает доступный процесс Broker по имени. Просмотреть существующие процессы Broker в кластере можно с помощью SHOW BROKER.
Имя Broker задаётся пользователем и не обозначает тип Broker.
Данные аутентификации
Для разных типов Broker и способов доступа требуются разные данные аутентификации. Обычно они задаются парами ключ-значение в наборе свойств после WITH BROKER "broker_name".
Параметры подключения для различных Broker
Alibaba Cloud OSS
(
    "fs.oss.accessKeyId" = "",
    "fs.oss.accessKeySecret" = "",
    "fs.oss.endpoint" = ""
)
Baidu Cloud BOS
При использовании BOS скачайте соответствующий пакет SDK. Подробные сведения о настройке и использовании приведены в официальной документации BOS HDFS. После скачивания и распаковки поместите JAR-пакет в каталог lib Broker.
(
    "fs.bos.access.key" = "xx",
    "fs.bos.secret.access.key" = "xx",
    "fs.bos.endpoint" = "xx"
)
Huawei Cloud OBS
(
    "fs.obs.access.key" = "xx",
    "fs.obs.secret.key" = "xx",
    "fs.obs.endpoint" = "xx"
)
JuiceFS
(
    "fs.defaultFS" = "jfs://xxx/",
    "fs.jfs.impl" = "io.juicefs.JuiceFileSystem",
    "fs.AbstractFileSystem.jfs.impl" = "io.juicefs.JuiceFS",
    "juicefs.meta" = "xxx",
    "juicefs.access-log" = "xxx"
)
GCS
При доступе к GCS через Broker параметр Project ID обязателен. Остальные параметры необязательны. Полный список параметров конфигурации приведён в разделе Конфигурация GCS:
(
    "fs.gs.project.id" = "Your Project ID",
    "fs.AbstractFileSystem.gs.impl" = "com.google.cloud.hadoop.fs.gcs.GoogleHadoopFS",
    "fs.gs.impl" = "com.google.cloud.hadoop.fs.gcs.GoogleHadoopFileSystem",
)
Часто задаваемые вопросы и устранение неполадок
Распространённые ошибки
1. Ошибка загрузки: Scan bytes per broker scanner exceed limit:xxx
См. раздел «Превышение времени ожидания загрузки». Измените параметры конфигурации FE max_bytes_per_broker_scanner и max_broker_concurrency.
2. Ошибка загрузки: failed to send batch или TabletWriter add batch with unknown id
Скорректируйте значения query_timeout и streaming_load_rpc_max_alive_time_sec.
3. Ошибка загрузки: LOAD_RUN_FAIL; msg:Invalid Column Name:xxx
Для данных PARQUET или ORC имена столбцов в заголовке файла должны совпадать с именами столбцов в таблице Doris. Например:
(tmp_c1,tmp_c2)
SET
(
    id=tmp_c2,
    name=tmp_c1
)
Это означает: получить столбцы с именами (tmp_c1, tmp_c2) из файла Parquet или ORC и сопоставить их со столбцами (id, name) таблицы Doris. Если SET не указан, для сопоставления используются столбцы из column.
Примечание: для файлов ORC, созданных непосредственно некоторыми версиями Hive, заголовок файла содержит не метаданные Hive, а
(_col0, _col1, _col2, ...), что может привести к ошибкеInvalid Column Name. В этом случае используйтеSETдля сопоставления.
4. Ошибка загрузки: Failed to get S3 FileSystem for bucket is null/empty
Сведения о бакете неверны или отсутствуют, либо формат бакета не поддерживается. Например, если при создании бакета в GCS в его имени используется _ (как в s3://gs_bucket/load_tbl), клиент S3 возвращает ошибку при обращении к GCS. Рекомендуется избегать _ при создании путей к бакетам.
5. Превышение времени ожидания загрузки
По умолчанию значение timeout для загрузки составляет 4 часа. При превышении времени ожидания не рекомендуется просто увеличивать максимальное время ожидания. Если одна загрузка занимает более 4 часов, рекомендуется разделить загружаемый файл и выполнить загрузку несколькими пакетами, поскольку при очень большом времени ожидания повторная попытка после сбоя требует слишком больших затрат.
Для оценки максимального объёма данных одной загрузки, который предположительно сможет обработать кластер Doris, можно использовать следующую формулу:
Expected maximum import file data volume = 14400s * 10M/s * number of BEs

For example, if the number of BEs in the cluster is 10:
Expected maximum import file data volume = 14400s * 10M/s * 10 = 1440000M ≈ 1440G

Note: A typical user environment may not reach 10M/s, so it is recommended to split files larger than 500G before importing.
Дополнительная справка
Более подробные сведения о синтаксисе и рекомендуемых подходах к использованию Broker Load приведены в руководстве по команде Broker Load. Дополнительную справку также можно получить, выполнив HELP BROKER LOAD в командной строке клиента MySQL.