Routine Load
Routine Load — это предоставляемое Apache Doris задание потоковой загрузки, которое непрерывно получает данные из топика Kafka и записывает их в таблицу Doris. После отправки задания Routine Load Doris поддерживает его непрерывную работу, в реальном времени создаёт задачи загрузки для получения сообщений из указанного топика кластера Kafka и обеспечивает семантику Exactly-Once, гарантирующую отсутствие потерь и дублирования данных.
Быстрая навигация
Перейдите к разделу, который соответствует вашей задаче:
| Моя задача | Раздел |
|---|---|
| Сразу запустить минимальный пример | Быстрый старт |
| Разобраться в принципах работы, автомате состояний и механизме автоматического восстановления | Основные принципы |
| Найти все настраиваемые параметры (FE/BE/задание/Kafka) | Справочное руководство |
| Найти примеры для конкретного сценария (допустимые ошибки, фильтрация, JSON, Kerberos и т. д.) | Примеры загрузки |
Задание переходит в PAUSED, сообщает об ошибке out of range или возникают ошибки SSL | Часто задаваемые вопросы (FAQ) |
Сценарии использования
Routine Load подходит для следующих сценариев:
- Непрерывная синхронизация данных из топика Kafka в Doris в реальном времени.
- Обеспечение семантики Exactly-Once для предотвращения потерь и дублирования данных.
- Сопоставление столбцов, фильтрация, вычисление производных столбцов и другие преобразования загружаемых данных.
- Динамическое распределение данных из одного топика Kafka по нескольким таблицам Doris (один поток, несколько таблиц).
Поддерживаемые источники и форматы данных
Routine Load поддерживает получение данных только из кластера Kafka и следующие два формата сообщений:
| Формат | Описание |
|---|---|
| CSV | Каждое сообщение представляет собой одну строку, в конце которой нет символа перевода строки. |
| JSON | Один объект JSON или массив JSON, содержащий несколько объектов. |
При загрузке данных в формате CSV важно различать значения NULL и пустые строки:
- Значение NULL обозначается как
\n. Например,a,\n,bозначает, что средний столбец содержит значение NULL. - Пустая строка задаётся отсутствием данных между разделителями. Например,
a,,bозначает, что средний столбец содержит пустую строку ('').
Ограничения
При использовании Routine Load для получения данных из Kafka действуют следующие ограничения:
| Ограничение | Описание |
|---|---|
| Формат сообщений | Поддерживаются только текстовые форматы CSV и JSON. Каждое сообщение CSV представляет собой одну строку, в конце которой нет символа перевода строки. |
| Версия Kafka | По умолчанию поддерживается Kafka 0.10.0.0 и выше. Чтобы использовать версию Kafka ниже 0.10.0.0 (0.9.0, 0.8.2, 0.8.1, 0.8.0), укажите нужную старую версию в параметре конфигурации BE kafka_broker_version_fallback или задайте property.broker.version.fallback непосредственно при создании задания. При использовании старой версии некоторые новые возможности Routine Load могут быть недоступны, например задание смещений партиций Kafka по времени. |
Основные принципы
Routine Load непрерывно получает данные из топика Kafka и записывает их в Doris. После создания задания Routine Load в Doris формируется длительно выполняющееся задание загрузки, которое содержит несколько задач загрузки:
- Load Job: задание Routine Load — это длительно выполняющееся задание загрузки, которое непрерывно получает данные из источника.
- Load Task: для фактического получения данных задание загрузки разделяется на несколько задач. Каждая задача представляет собой независимую транзакцию.
Подробная схема работы Routine Load показана на следующем рисунке:
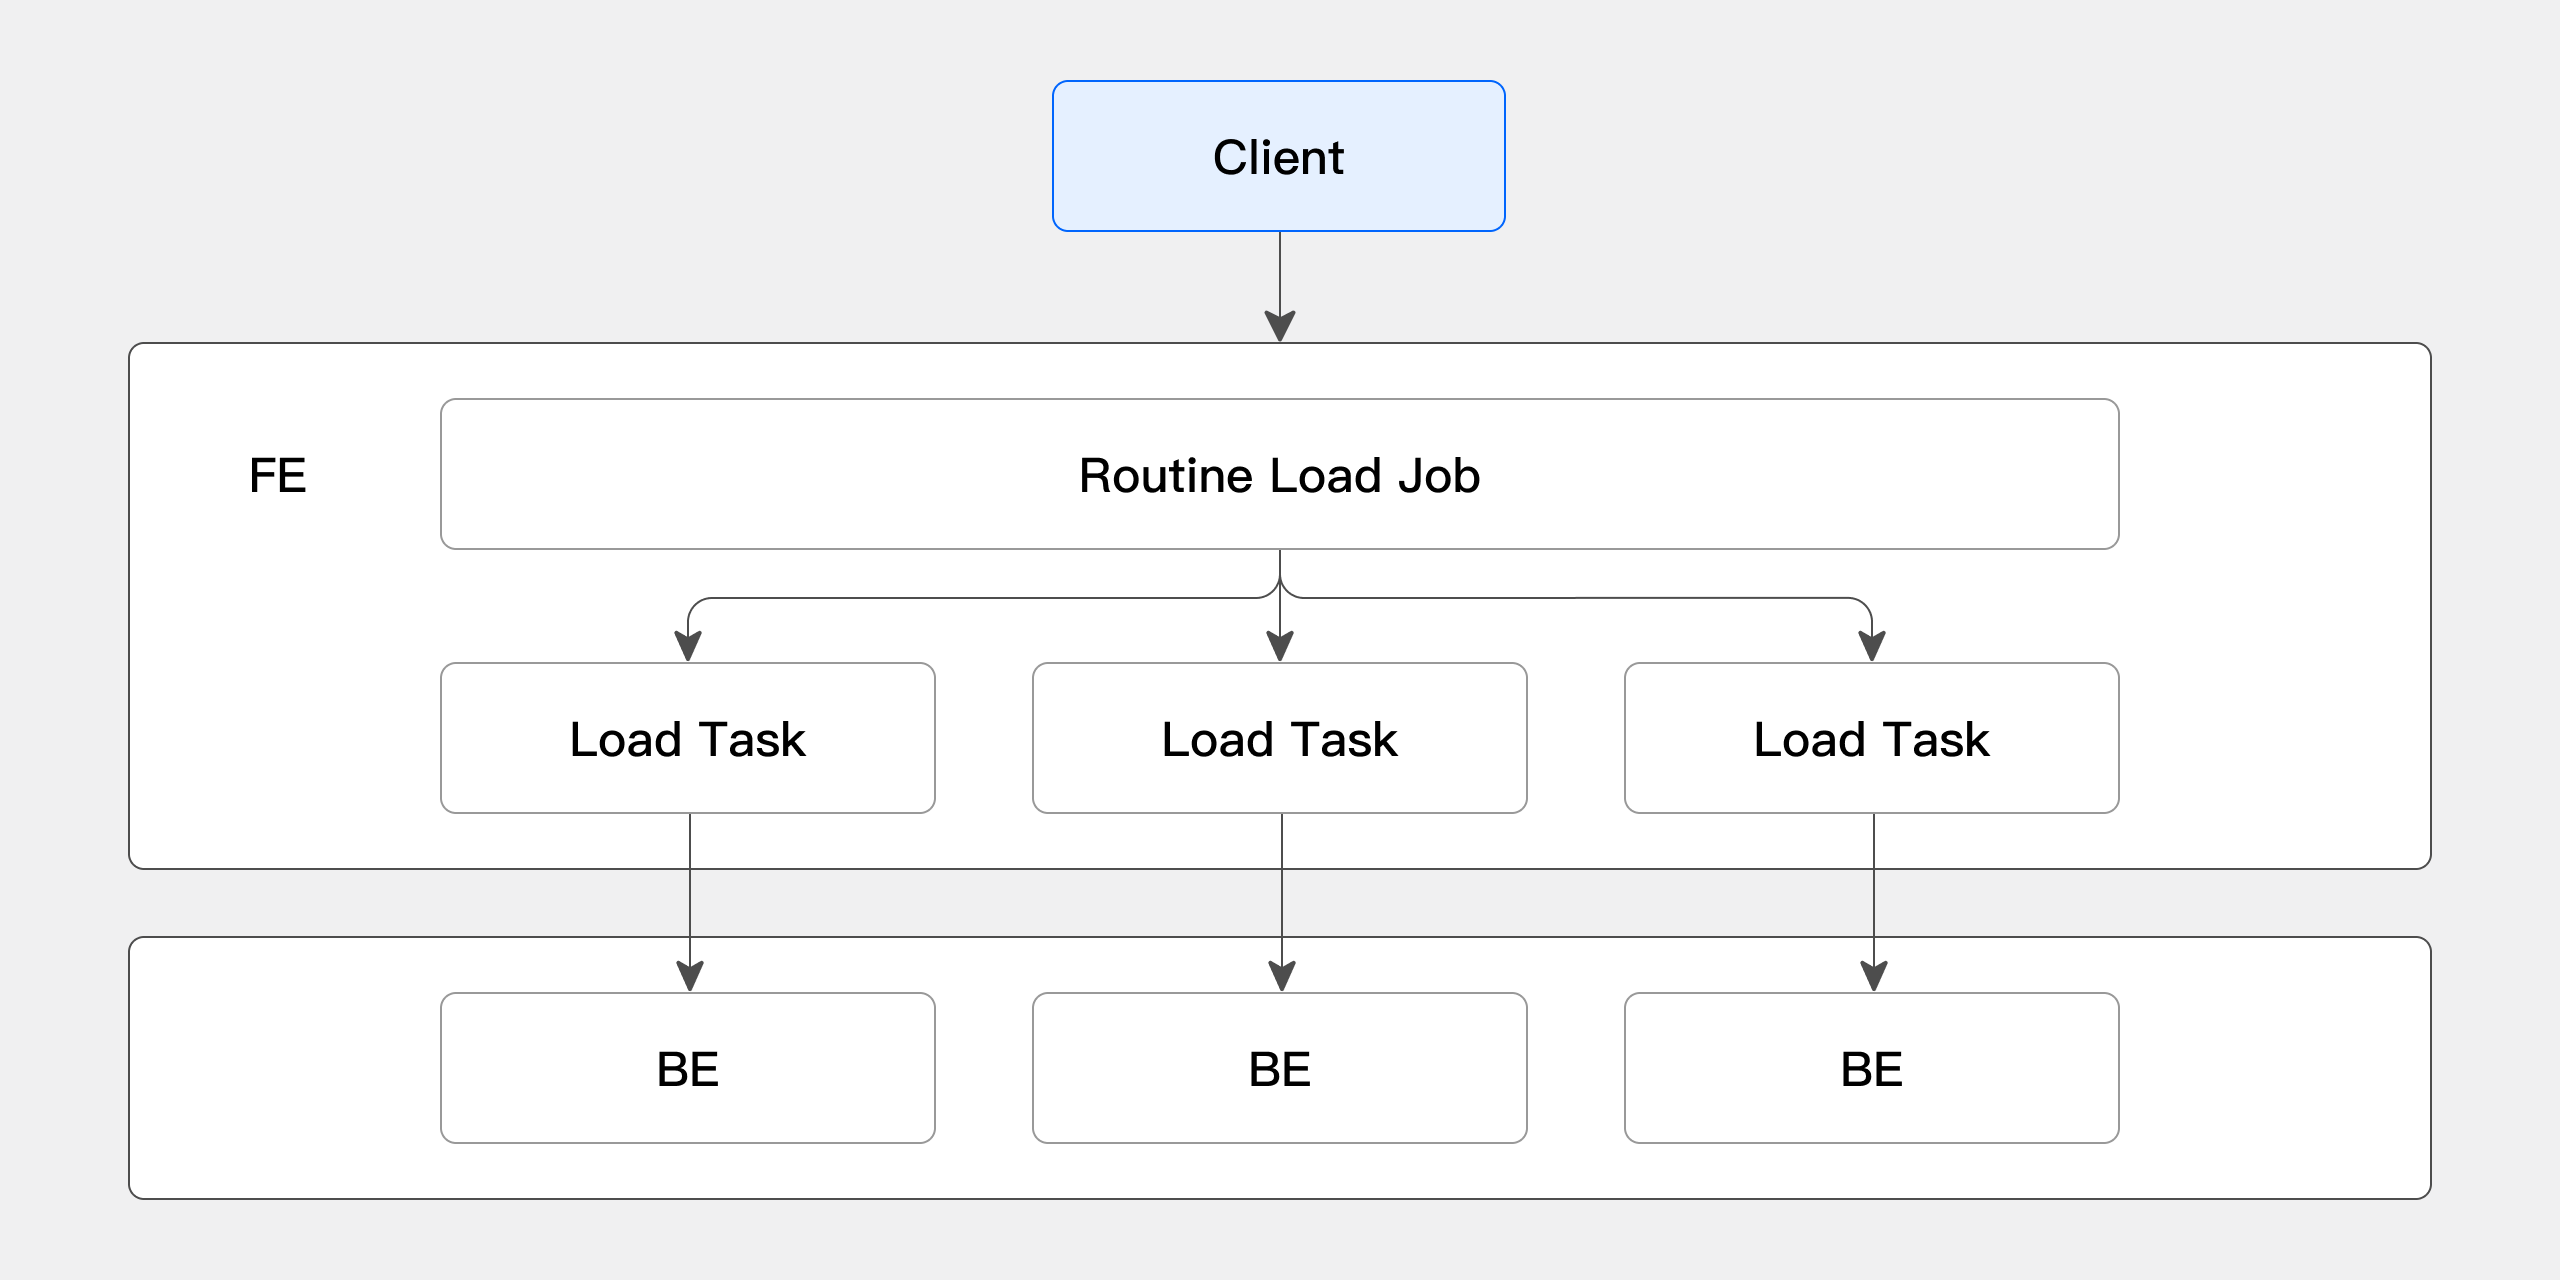
Общий процесс выглядит следующим образом:
- Клиент отправляет в FE запрос на создание задания Routine Load. FE через Routine Load Manager создаёт длительно выполняющееся задание загрузки (Routine Load Job).
- FE через Job Scheduler разделяет Routine Load Job на несколько задач Routine Load Task. Затем Task Scheduler распределяет их по узлам BE.
- После завершения загрузки на BE задача Routine Load Task фиксирует транзакцию в FE и обновляет метаданные задания.
- После фиксации Routine Load Task создаются новые задачи или повторно запускаются задачи с истёкшим временем ожидания.
- Task Scheduler непрерывно планирует выполнение вновь созданных задач Routine Load Task.
Механизм автоматического восстановления
Для обеспечения высокой доступности заданий в Routine Load предусмотрен механизм автоматического восстановления. Если задание неожиданно приостанавливается, поток Routine Load Scheduler пытается автоматически восстановить его работу. При неожиданных сбоях на стороне Kafka и других ситуациях, препятствующих работе, этот механизм позволяет заданию загрузки продолжить нормальную работу после восстановления Kafka без вмешательства пользователя.
В следующей таблице указано, в каких случаях восстановление происходит автоматически, а в каких требуется вмешательство пользователя:
| Причина приостановки | Автоматическое восстановление | Рекомендуемое действие |
|---|---|---|
| Временная недоступность брокера Kafka, нестабильность сети | Да | Scheduler автоматически повторяет попытки с интервалом period_of_auto_resume_min. |
Пользователь вручную выполняет PAUSE ROUTINE LOAD | Нет | Вручную выполните RESUME ROUTINE LOAD. |
Проблема с качеством данных (превышен max_filter_ratio или max_error_number) | Нет | Изучите ErrorLogUrls, скорректируйте данные или параметры, затем выполните RESUME. |
| Неустранимые ошибки метаданных, например удаление базы данных или таблицы | Нет | Заново создайте таблицу или задание. |
Быстрый старт
В этом разделе приведён минимальный рабочий пример создания задания Routine Load для Kafka, а также основные операции просмотра, приостановки, возобновления, изменения и остановки задания.
Создание задания загрузки
Создать длительно выполняющееся задание загрузки Routine Load можно с помощью команды CREATE ROUTINE LOAD. Routine Load может получать данные в форматах CSV и JSON.
Загрузка данных CSV
-
Подготовьте пример данных в Kafka:
kafka-console-consumer.sh --bootstrap-server localhost:9092 --topic test-routine-load-csv --from-beginning
1,Emily,25
2,Benjamin,35
3,Olivia,28
4,Alexander,60
5,Ava,17
6,William,69
7,Sophia,32
8,James,64
9,Emma,37
10,Liam,64 -
Создайте целевую таблицу для загрузки:
CREATE TABLE testdb.test_routineload_tbl(
    user_id            BIGINT       NOT NULL COMMENT "user id",
    name               VARCHAR(20)           COMMENT "name",
    age                INT                   COMMENT "age"
)
DUPLICATE KEY(user_id)
DISTRIBUTED BY HASH(user_id) BUCKETS 10; -
Создайте задание загрузки Routine Load:
CREATE ROUTINE LOAD testdb.example_routine_load_csv ON test_routineload_tbl
COLUMNS TERMINATED BY ",",
COLUMNS(user_id, name, age)
FROM KAFKA(
    "kafka_broker_list" = "192.168.88.62:9092",
    "kafka_topic" = "test-routine-load-csv",
    "property.kafka_default_offsets" = "OFFSET_BEGINNING"
);
Загрузка данных JSON
-
Подготовьте пример данных в Kafka:
kafka-console-consumer.sh --bootstrap-server localhost:9092 --topic test-routine-load-json --from-beginning
{"user_id":1,"name":"Emily","age":25}
{"user_id":2,"name":"Benjamin","age":35}
{"user_id":3,"name":"Olivia","age":28}
{"user_id":4,"name":"Alexander","age":60}
{"user_id":5,"name":"Ava","age":17}
{"user_id":6,"name":"William","age":69}
{"user_id":7,"name":"Sophia","age":32}
{"user_id":8,"name":"James","age":64}
{"user_id":9,"name":"Emma","age":37}
{"user_id":10,"name":"Liam","age":64} -
Создайте целевую таблицу для загрузки:
CREATE TABLE testdb.test_routineload_tbl(
    user_id            BIGINT       NOT NULL COMMENT "user id",
    name               VARCHAR(20)           COMMENT "name",
    age                INT                   COMMENT "age"
)
DUPLICATE KEY(user_id)
DISTRIBUTED BY HASH(user_id) BUCKETS 10; -
Создайте задание загрузки Routine Load:
CREATE ROUTINE LOAD testdb.example_routine_load_json ON test_routineload_tbl
COLUMNS(user_id,name,age)
PROPERTIES(
    "format"="json",
    "jsonpaths"="[\"$.user_id\",\"$.name\",\"$.age\"]"
)
FROM KAFKA(
    "kafka_broker_list" = "192.168.88.62:9092",
    "kafka_topic" = "test-routine-load-json",
    "property.kafka_default_offsets" = "OFFSET_BEGINNING"
);
Чтобы загрузить объект JSON из корня файла JSON, задайте для jsonpaths значение $., например: PROPERTIES("jsonpaths"="$.").
Просмотр состояния загрузки
Состояние Routine Load можно просматривать на двух уровнях:
- Задание загрузки: сведения о целевой таблице задания, количестве подзадач, задержке загрузки, конфигурации и результатах загрузки.
- Задача загрузки: состояние подзадач загрузки, ход получения данных и узел BE, на который направлена задача.
Просмотр задания загрузки
Для просмотра задания загрузки используйте команду SHOW ROUTINE LOAD. Она выводит основные сведения о текущем задании: целевую таблицу загрузки, задержку, конфигурацию загрузки и информацию об ошибках.
Следующая команда показывает состояние задания testdb.example_routine_load_csv:
mysql> SHOW ROUTINE LOAD FOR testdb.example_routine_load\G
*************************** 1. row ***************************
                  Id: 12025
                Name: example_routine_load
          CreateTime: 2024-01-15 08:12:42
           PauseTime: NULL
             EndTime: NULL
              DbName: default_cluster:testdb
           TableName: test_routineload_tbl
        IsMultiTable: false
               State: RUNNING
      DataSourceType: KAFKA
      CurrentTaskNum: 1
       JobProperties: {"max_batch_rows":"200000","timezone":"America/New_York","send_batch_parallelism":"1","load_to_single_tablet":"false","column_separator":"','","line_delimiter":"\n","current_concurrent_number":"1","delete":"*","partial_columns":"false","merge_type":"APPEND","exec_mem_limit":"2147483648","strict_mode":"false","jsonpaths":"","max_batch_interval":"10","max_batch_size":"104857600","fuzzy_parse":"false","partitions":"*","columnToColumnExpr":"user_id,name,age","whereExpr":"*","desired_concurrent_number":"5","precedingFilter":"*","format":"csv","max_error_number":"0","max_filter_ratio":"1.0","json_root":"","strip_outer_array":"false","num_as_string":"false"}
DataSourceProperties: {"topic":"test-topic","currentKafkaPartitions":"0","brokerList":"192.168.88.62:9092"}
    CustomProperties: {"kafka_default_offsets":"OFFSET_BEGINNING","group.id":"example_routine_load_73daf600-884e-46c0-a02b-4e49fdf3b4dc"}
           Statistic: {"receivedBytes":28,"runningTxns":[],"errorRows":0,"committedTaskNum":3,"loadedRows":3,"loadRowsRate":0,"abortedTaskNum":0,"errorRowsAfterResumed":0,"totalRows":3,"unselectedRows":0,"receivedBytesRate":0,"taskExecuteTimeMs":30069}
            Progress: {"0":"2"}
                 Lag: {"0":0}
ReasonOfStateChanged:
        ErrorLogUrls:
            OtherMsg:
                User: root
             Comment:
1 row in set (0.00 sec)
Просмотр подзадач загрузки
Для просмотра подзадач загрузки используйте команду SHOW ROUTINE LOAD TASK. Задание Routine Load можно указать с помощью WHERE JobName = <job_name> или FOR [<db>.]<job_name> (если <db> не указан, используется текущая база данных). Команда выводит сведения о подзадачах текущего задания, например состояние подзадачи и идентификатор BE, на который она направлена.
Следующая команда показывает сведения о подзадачах задания testdb.example_routine_load_csv:
mysql> SHOW ROUTINE LOAD TASK WHERE jobname = 'example_routine_load_csv';
+-----------------------------------+-------+-----------+-------+---------------------+---------------------+---------+-------+----------------------+
| TaskId                            | TxnId | TxnStatus | JobId | CreateTime          | ExecuteStartTime    | Timeout | BeId  | DataSourceProperties |
+-----------------------------------+-------+-----------+-------+---------------------+---------------------+---------+-------+----------------------+
| 8cf47e6a68ed4da3-8f45b431db50e466 | 195   | PREPARE   | 12177 | 2024-01-15 12:20:41 | 2024-01-15 12:21:01 | 20      | 10429 | {"4":1231,"9":2603}  |
| f2d4525c54074aa2-b6478cf8daaeb393 | 196   | PREPARE   | 12177 | 2024-01-15 12:20:41 | 2024-01-15 12:21:01 | 20      | 12109 | {"1":1225,"6":1216}  |
| cb870f1553864250-975279875a25fab6 | -1    | NULL      | 12177 | 2024-01-15 12:20:52 | NULL                | 20      | -1    | {"2":7234,"7":4865}  |
| 68771fd8a1824637-90a9dac2a7a0075e | -1    | NULL      | 12177 | 2024-01-15 12:20:52 | NULL                | 20      | -1    | {"3":1769,"8":2982}  |
| 77112dfea5e54b0a-a10eab3d5b19e565 | 197   | PREPARE   | 12177 | 2024-01-15 12:21:02 | 2024-01-15 12:21:02 | 20      | 12098 | {"0":3000,"5":2622}  |
+-----------------------------------+-------+-----------+-------+---------------------+---------------------+---------+-------+----------------------+
Также можно использовать следующий синтаксис:
mysql> SHOW ROUTINE LOAD TASK FOR testdb.example_routine_load_csv;
Приостановка задания загрузки
Приостановить задание загрузки можно с помощью команды PAUSE ROUTINE LOAD. После приостановки задание переходит в состояние PAUSED, но не завершается. Возобновить его можно командой RESUME ROUTINE LOAD.
PAUSE ROUTINE LOAD FOR testdb.example_routine_load_csv;
Возобновление задания загрузки
Возобновить задание загрузки в состоянии PAUSED можно с помощью команды RESUME ROUTINE LOAD.
RESUME ROUTINE LOAD FOR testdb.example_routine_load_csv;
Изменение задания загрузки
Изменить созданное задание загрузки можно с помощью команды ALTER ROUTINE LOAD. Перед изменением приостановите задание командой PAUSE ROUTINE LOAD. После завершения изменений возобновите его командой RESUME ROUTINE LOAD.
Например, чтобы изменить параметр желаемого параллелизма desired_concurrent_number и сведения о топике Kafka:
ALTER ROUTINE LOAD FOR testdb.example_routine_load_csv
PROPERTIES(
    "desired_concurrent_number" = "3"
)
FROM KAFKA(
    "kafka_broker_list" = "192.168.88.60:9092",
    "kafka_topic" = "test-topic"
);
Отмена задания загрузки
Остановить и удалить задание загрузки Routine Load можно с помощью команды STOP ROUTINE LOAD. Удалённое задание загрузки невозможно восстановить, и оно недоступно для просмотра командой SHOW ROUTINE LOAD.
STOP ROUTINE LOAD FOR testdb.example_routine_load_csv;
Привязка Compute Group
В режиме разделения хранения и вычислений выбор Compute Group для Routine Load выполняется в следующем порядке приоритета:
- Выбирается Compute Group, указанная в операторе
use db@cluster. - Выбирается Compute Group, указанная в свойстве пользователя
default_compute_group. - Выбирается одна Compute Group из тех, к которым у текущего пользователя есть доступ.
В режиме совместного хранения и вычислений выбирается Compute Group, указанная в свойстве пользователя resource_tags.location. Если в свойствах пользователя Compute Group не задана, используется Compute Group с именем default.
Compute Group для задания Routine Load можно указать только при его создании. После создания задания изменить привязанную Compute Group нельзя.
Справочное руководство
Синтаксис команды загрузки
Синтаксис создания длительно выполняющегося задания загрузки Routine Load:
CREATE ROUTINE LOAD [<db_name>.]<job_name> [ON <tbl_name>]
[merge_type]
[load_properties]
[job_properties]
FROM KAFKA [data_source_properties]
[COMMENT "<comment>"]
Описание модулей:
| Модуль | Описание |
|---|---|
| db_name | Указывает базу данных, в которой создаётся задача загрузки. |
| job_name | Указывает имя создаваемой задачи загрузки. В одной базе данных не может быть задач с одинаковым именем. |
| tbl_name | Указывает имя таблицы, в которую загружаются данные. Необязательный параметр. Если он не задан, используется динамический выбор таблицы, при котором данные в Kafka должны содержать имя таблицы. |
| merge_type | Тип слияния данных. Значение по умолчанию — APPEND. Доступны три варианта: - APPEND: загрузка с добавлением. - MERGE: загрузка со слиянием. - DELETE: все загружаемые данные подлежат удалению. |
| load_properties | Модуль описания загрузки, включающий следующие компоненты: - предложение column_separator - предложение columns_mapping - предложение preceding_filter - предложение where_predicates - предложение partitions - предложение delete_on - предложение order_by |
| job_properties | Задаёт общие параметры загрузки Routine Load. |
| data_source_properties | Описывает свойства источника данных Kafka. |
| comment | Задаёт комментарий к заданию загрузки. |
Описание параметров загрузки
Параметры конфигурации FE
| Параметр | Значение по умолчанию | Динамический | Только для FE Master | Описание |
|---|---|---|---|---|
| max_routine_load_task_concurrent_num | 256 | Да | Да | Ограничивает максимальное количество параллельных подзадач задания загрузки Routine Load. Рекомендуется оставить значение по умолчанию. Слишком большое значение может привести к чрезмерному количеству параллельных задач и расходу ресурсов кластера. |
| max_routine_load_task_num_per_be | 1024 | Да | Да | Максимальное количество параллельных задач Routine Load на одном BE. Значение max_routine_load_task_num_per_be должно быть меньше routine_load_thread_pool_size. |
| max_routine_load_job_num | 100 | Да | Да | Ограничивает максимальное количество заданий Routine Load, включая задания в состояниях NEED_SCHEDULED, RUNNING и PAUSE. |
| max_tolerable_backend_down_num | 0 | Да | Да | Если хотя бы один BE недоступен, Routine Load не может восстановиться автоматически. При выполнении определённых условий Doris может повторно запланировать задачу в состоянии PAUSED и перевести её в состояние RUNNING. Значение 0 означает, что повторное планирование разрешено только тогда, когда доступны все узлы BE. |
| period_of_auto_resume_min | 5 (минут) | Да | Да | Интервал автоматического восстановления Routine Load. |
Параметры конфигурации BE
| Параметр | Значение по умолчанию | Динамический | Описание |
|---|---|---|---|
| max_consumer_num_per_group | 3 | Да | Максимальное количество потребителей, которые одна подзадача может создать для получения данных. |
Параметры конфигурации загрузки
При создании задания Routine Load с помощью команды CREATE ROUTINE LOAD можно указать параметры конфигурации загрузки для различных модулей.
Предложение tbl_name
Указывает имя таблицы для загрузки. Необязательный параметр.
Если параметр не задан, используется динамический выбор таблицы, при котором данные в Kafka должны содержать имя таблицы. В настоящее время динамическое имя таблицы можно извлечь только из Kafka Value, и данные должны соответствовать следующему формату. Для JSON: table_name|{"col1": "val1", "col2": "val2"}, где tbl_name — имя таблицы, а | — разделитель между именем таблицы и её данными. Для CSV используется аналогичный формат, например: table_name|val1,val2,val3.
Указанное здесь table_name должно точно совпадать с именем таблицы в Doris, иначе загрузка завершится ошибкой. При динамическом выборе таблицы column_mapping не поддерживается.
Предложение merge_type
Тип слияния данных можно задать с помощью модуля merge_type. Доступны три варианта:
- APPEND: загрузка с добавлением.
- MERGE: загрузка со слиянием. Применима только к модели Unique Key. Необходимо использовать вместе с модулем
[DELETE ON]для установки отметки в столбце Delete Flag. - DELETE: все загружаемые данные подлежат удалению.
Предложение load_properties
Свойства загружаемых данных можно описать с помощью модуля load_properties. Синтаксис:
[COLUMNS TERMINATED BY <column_separator>,]
[COLUMNS (<column1_name>[, <column2_name>, <column_mapping>, ...]),]
[WHERE <where_expr>,]
[PARTITION(<partition1_name>, [<partition2_name>, <partition3_name>, ...]),]
[DELETE ON <delete_expr>,]
[ORDER BY <order_by_column1>[, <order_by_column2>, <order_by_column3>, ...]]
Параметры каждого модуля:
| Подмодуль | Параметр | Описание |
|---|---|---|
| COLUMNS TERMINATED BY | <column_separator> | Задаёт разделитель столбцов. По умолчанию — \t. Например, чтобы задать запятую в качестве разделителя: COLUMN TERMINATED BY ",". Особенности обработки NULL:- Значение NULL обозначается как - Пустая строка задаётся отсутствием данных между разделителями. |
| COLUMNS | <column_name> | Задаёт имя соответствующего столбца. Например, чтобы указать загружаемые столбцы (k1, k2, k3): COLUMNS(k1, k2, k3). Предложение COLUMNS можно опустить в следующих случаях:- Столбцы CSV взаимно однозначно соответствуют столбцам таблицы. - Имена ключей JSON совпадают с именами столбцов таблицы. |
<column_mapping> | При загрузке можно фильтровать и преобразовывать столбцы с помощью сопоставления столбцов. Например, целевой столбец k4 вычисляется из столбца k3 по формуле k3+1: COLUMNS(k1, k2, k3, k4 = k3 + 1). Подробнее см. в разделе Преобразование данных. | |
| WHERE | <where_expr> | Фильтрует исходные загружаемые данные по условию. Например, чтобы загрузить только данные с age > 30: WHERE age > 30. |
| PARTITION | <partition_name> | Указывает партиции целевой таблицы, в которые нужно загрузить данные. Если не задано, данные автоматически загружаются в соответствующие партиции. Например, для загрузки в партиции p1 и p2: PARTITION(p1, p2). |
| DELETE ON | <delete_expr> | В режиме загрузки MERGE используйте delete_expr, чтобы отметить столбцы, подлежащие удалению. Например, чтобы при MERGE удалить столбцы, для которых age > 30: DELETE ON age > 30. |
| ORDER BY | <order_by_column> | Действует только для модели Unique Key. Задаёт Sequence Column в загружаемых данных для обеспечения порядка данных. Например, чтобы указать create_time в качестве Sequence Column: ORDER BY create_time. Подробнее см. в разделе Обновление данных / Sequence Column. |
Предложение job_properties
При создании задания загрузки Routine Load его свойства можно задать с помощью предложения job_properties. Синтаксис:
PROPERTIES ("<key1>" = "<value1>"[, "<key2>" = "<value2>" ...])
Доступные параметры предложения job_properties:
| Параметр | Описание |
|---|---|
| desired_concurrent_number | Значение по умолчанию: 256 Желаемый параллелизм для отдельной задачи загрузки. В процессе загрузки желаемое количество параллельных подзадач может отличаться от фактического. Фактический параллелизм вычисляется следующим образом:
- - - |
| max_batch_interval | Максимальное время выполнения каждой подзадачи в секундах. Должно быть больше 0. Значение по умолчанию — 60. Параметры max_batch_interval, max_batch_rows и max_batch_size совместно задают порог завершения подзадачи. При достижении любого из них подзадача загрузки завершается и создаётся новая. |
| max_batch_rows | Максимальное количество строк, которое может прочитать каждая подзадача. Должно быть больше или равно 200000. Значение по умолчанию — 20000000. Параметры max_batch_interval, max_batch_rows и max_batch_size совместно задают порог завершения подзадачи. При достижении любого из них подзадача загрузки завершается и создаётся новая. |
| max_batch_size | Максимальное количество байтов, которое может прочитать каждая подзадача. Значение задаётся в байтах, диапазон — от 100 MB до 1 GB, значение по умолчанию — 1 GB. Параметры max_batch_interval, max_batch_rows и max_batch_size совместно задают порог завершения подзадачи. При достижении любого из них подзадача загрузки завершается и создаётся новая. |
| max_error_number | Максимальное количество ошибочных строк, допустимое в окне выборки. Должно быть больше или равно 0. Значение по умолчанию — 0 (ошибочные строки не допускаются). Размер окна выборки — max_batch_rows * 10. Если количество ошибочных строк в окне выборки превышает max_error_number, задание Routine Load приостанавливается. Для проверки проблем с качеством данных требуется вмешательство пользователя. Выявить эти проблемы можно с помощью поля ErrorLogUrls в выводе команды SHOW ROUTINE LOAD. Строки, отфильтрованные условием where, не считаются ошибочными. |
| strict_mode | Определяет, включён ли строгий режим. По умолчанию отключён. Строгий режим обеспечивает строгую фильтрацию при преобразовании типов столбцов во время загрузки. Если он включён и исходное значение, отличное от NULL, после преобразования типа столбца становится NULL, оно отфильтровывается. Правила фильтрации: - Строгий режим не влияет на производные столбцы (созданные преобразованием с помощью функций). - Если требуется преобразование типа столбца, данные неверного типа отфильтровываются. Их можно просмотреть через - Если тип загружаемого столбца имеет ограничения диапазона и исходные данные проходят преобразование типа, но выходят за пределы диапазона, строгий режим на них не влияет. Например, если тип — |
| timezone | Задаёт часовой пояс задания загрузки. По умолчанию используется параметр часового пояса сеанса. Этот параметр влияет на результаты всех функций, связанных с часовым поясом, которые используются при загрузке. |
| format | Задаёт формат загружаемых данных. По умолчанию — CSV. Поддерживается формат JSON. |
| jsonpaths | Если данные загружаются в формате JSON, с помощью jsonpaths можно указать поля, извлекаемые из данных JSON. Например: "jsonpaths" = "[\"$.userid\",\"$.username\",\"$.age\",\"$.city\"]" |
| json_root | Если данные загружаются в формате JSON, с помощью json_root можно указать корневой узел данных JSON. Doris извлекает и разбирает элементы из корневого узла, заданного в json_root. По умолчанию значение пустое. Например: "json_root" = "$.RECORDS" |
| strip_outer_array | Если данные загружаются в формате JSON, значение true для strip_outer_array означает, что данные JSON представлены массивом, а каждый его элемент обрабатывается как отдельная строка. По умолчанию — false. Данные JSON в Kafka часто представлены массивом, то есть внешний уровень заключён в скобки []. В этом случае можно указать "strip_outer_array" = "true". Например, следующие данные разбираются как две строки: [{"user_id":1,"name":"Emily","age":25},{"user_id":2,"name":"Benjamin","age":35}] |
| send_batch_parallelism | Задаёт параллелизм отправки пакетов данных. Если значение параллелизма превышает параметр конфигурации BE max_send_batch_parallelism_per_job, BE, выполняющий роль координатора, использует значение max_send_batch_parallelism_per_job. |
| load_to_single_tablet | Позволяет загружать данные задачи только в один tablet соответствующей партиции. По умолчанию — false. Этот параметр можно задать только при загрузке данных в таблицу OLAP со случайным распределением по бакетам. |
| partial_columns | Определяет, включено ли частичное обновление столбцов. По умолчанию — false. Этот параметр можно задать только для таблицы модели Unique с Merge on Write. Загрузка из одного потока в несколько таблиц не поддерживает этот параметр. Подробнее см. в разделе Частичное обновление столбцов. |
| unique_key_update_mode | Задаёт режим обновления таблицы Unique Key. Варианты:
|
| partial_update_new_key_behavior | Определяет обработку новых строк при частичном обновлении столбцов в таблице Unique Merge on Write. Два варианта: APPEND и ERROR.- APPEND: разрешить вставку новых строк.- ERROR: при вставке новой строки загрузка завершается неудачей и возвращается ошибка. |
| max_filter_ratio | Максимальная допустимая доля отфильтрованных строк в окне выборки. Должна быть больше или равна 0 и меньше или равна 1. Значение по умолчанию — 1.0, что допускает любое количество ошибочных строк. Размер окна выборки — max_batch_rows * 10. Если отношение количества ошибочных строк к общему количеству строк в окне выборки превышает max_filter_ratio, задание Routine Load приостанавливается. Для проверки проблем с качеством данных требуется вмешательство пользователя. Строки, отфильтрованные условием where, не считаются ошибочными. |
| enclose | Задаёт символ обрамления. Если поля CSV содержат разделители строк или столбцов, можно указать однобайтовый символ обрамления, чтобы предотвратить непреднамеренное разделение данных. Например, если разделитель столбцов — ,, а символ обрамления — ', то в данных a,'b,c' значение b,c разбирается как одно поле. |
| escape | Задаёт символ экранирования. Используется для экранирования символов внутри поля, совпадающих с символом обрамления. Например, для данных a,'b,'c' с символом обрамления ', чтобы разобрать b,'c как одно поле, необходимо задать однобайтовый символ экранирования (например, \) и изменить данные на a,'b,\'c'. |
Предложение data_source_properties
При создании задания загрузки Routine Load свойства источника данных Kafka можно задать с помощью предложения data_source_properties. Синтаксис:
FROM KAFKA ("<key1>" = "<value1>"[, "<key2>" = "<value2>" ...])
Доступные параметры предложения data_source_properties:
| Параметр | Описание |
|---|---|
| kafka_broker_list | Задаёт сведения для подключения к брокерам Kafka. Формат — <kafka_broker_ip>:<kafka port>. Несколько брокеров разделяются запятыми. Например: "kafka_broker_list" = "<broker1_ip>:9092,<broker2_ip>:9092" |
| kafka_topic | Задаёт топик Kafka для подписки. Одно задание загрузки может получать данные только из одного топика Kafka. |
| kafka_partitions | Задаёт партиции Kafka для подписки. Если не указано, по умолчанию данные получаются из всех партиций. |
| kafka_offsets | Начальное смещение для получения данных из партиции Kafka. Если указано время, получение данных начинается с самого позднего смещения, время которого больше или равно указанному. Можно задать конкретное значение смещения, большее или равное 0, либо использовать один из следующих форматов: - - - Формат времени, например: Если не задано, по умолчанию подписка на все партиции топика начинается с Примечание: формат времени нельзя смешивать с форматом OFFSET. |
| property | Задаёт пользовательские параметры Kafka, аналогичные параметру --property командной оболочки Kafka. Если значение параметра является файлом, добавьте к значению префикс FILE:. Для создания файла см. команду CREATE FILE. Дополнительные поддерживаемые пользовательские параметры описаны в настройках клиента в официальном документе librdkafka CONFIGURATION. Например: "property.client.id" = "12345", "property.group.id" = "group_id_0", "property.ssl.ca.location" = "FILE:ca.pem". |
С помощью параметров свойств Kafka в data_source_properties можно настроить защищённый доступ. В настоящее время Doris поддерживает несколько протоколов безопасности Kafka, включая plaintext (по умолчанию), SSL, PLAIN и Kerberos.
Состояние загрузки
Просмотреть состояние задания загрузки можно с помощью команды SHOW ROUTINE LOAD:
SHOW [ALL] ROUTINE LOAD [FOR jobName];
Пример результата:
mysql> SHOW ROUTINE LOAD FOR testdb.example_routine_load\G
*************************** 1. row ***************************
                  Id: 12025
                Name: example_routine_load
          CreateTime: 2024-01-15 08:12:42
           PauseTime: NULL
             EndTime: NULL
              DbName: default_cluster:testdb
           TableName: test_routineload_tbl
        IsMultiTable: false
               State: RUNNING
      DataSourceType: KAFKA
      CurrentTaskNum: 1
       JobProperties: {"max_batch_rows":"200000","timezone":"America/New_York","send_batch_parallelism":"1","load_to_single_tablet":"false","column_separator":"','","line_delimiter":"\n","current_concurrent_number":"1","delete":"*","partial_columns":"false","merge_type":"APPEND","exec_mem_limit":"2147483648","strict_mode":"false","jsonpaths":"","max_batch_interval":"10","max_batch_size":"104857600","fuzzy_parse":"false","partitions":"*","columnToColumnExpr":"user_id,name,age","whereExpr":"*","desired_concurrent_number":"5","precedingFilter":"*","format":"csv","max_error_number":"0","max_filter_ratio":"1.0","json_root":"","strip_outer_array":"false","num_as_string":"false"}
DataSourceProperties: {"topic":"test-topic","currentKafkaPartitions":"0","brokerList":"192.168.88.62:9092"}
    CustomProperties: {"kafka_default_offsets":"OFFSET_BEGINNING","group.id":"example_routine_load_73daf600-884e-46c0-a02b-4e49fdf3b4dc"}
           Statistic: {"receivedBytes":28,"runningTxns":[],"errorRows":0,"committedTaskNum":3,"loadedRows":3,"loadRowsRate":0,"abortedTaskNum":0,"errorRowsAfterResumed":0,"totalRows":3,"unselectedRows":0,"receivedBytesRate":0,"taskExecuteTimeMs":30069}
            Progress: {"0":"2"}
                 Lag: {"0":0}
ReasonOfStateChanged:
        ErrorLogUrls:
            OtherMsg:
                User: root
             Comment:
1 row in set (0.00 sec)
Описание столбцов результата:
| Столбец результата | Описание |
|---|---|
| Id | Идентификатор задания, автоматически создаваемый Doris. |
| Name | Имя задания. |
| CreateTime | Время создания задания. |
| PauseTime | Время последней приостановки задания. |
| EndTime | Время завершения задания. |
| DbName | Имя соответствующей базы данных. |
| TableName | Имя соответствующей таблицы. Для заданий с несколькими таблицами (динамический выбор таблиц) конкретное имя таблицы не отображается; вместо него выводится multi-table. |
| IsMultiTable | Определяет, работает ли задание с несколькими таблицами (один поток, несколько таблиц). |
| State | Состояние выполнения задания. Всего 5 состояний. См. раздел Автомат состояний задания ниже. |
| DataSourceType | Тип источника данных: KAFKA. |
| CurrentTaskNum | Текущее количество подзадач. |
| JobProperties | Подробная конфигурация задания. |
| DataSourceProperties | Подробная конфигурация источника данных. |
| CustomProperties | Пользовательская конфигурация. |
| Statistic | Статистика выполнения задания. |
| Progress | Ход выполнения задания. Для источников данных Kafka отображает текущее обработанное смещение каждой партиции. Например, {"0":"2"} означает, что получение данных из партиции Kafka 0 достигло смещения 2. |
| Lag | Состояние задержки задания. Для источников данных Kafka отображает отставание в получении данных для каждой партиции. Например, {"0":10} означает, что отставание для партиции Kafka 0 составляет 10. |
| ReasonOfStateChanged | Причина изменения состояния задания. |
| ErrorLogUrls | URL для просмотра отфильтрованных данных низкого качества. |
| OtherMsg | Другая информация об ошибках. |
Автомат состояний задания
У задания Routine Load есть 5 состояний. Переходы между ними описаны ниже:
| Состояние | Значение | Условие перехода | Возможное следующее состояние |
|---|---|---|---|
NEED_SCHEDULE | Задание ожидает планирования. | Начальное состояние после CREATE ROUTINE LOAD или RESUME ROUTINE LOAD. | RUNNING |
RUNNING | Задание выполняется и непрерывно получает данные из Kafka. | Переход после успешного планирования. | PAUSED / STOPPED |
PAUSED | Задание приостановлено, но не завершено. | Ручное выполнение PAUSE ROUTINE LOAD или автоматическая приостановка при ошибке. | NEED_SCHEDULE (ручное выполнение RESUME или автоматическое восстановление) / CANCELLED |
STOPPED | Задание остановлено, и его невозможно перезапустить. | STOP ROUTINE LOAD. | Конечное состояние. |
CANCELLED | Задание отменено. | Удаление базы данных или таблицы либо другие ошибки. | Конечное состояние. |
Примеры загрузки
Для быстрой навигации в следующей таблице перечислены все типовые примеры этого раздела по сценариям использования:
| Категория | Сценарий | Решаемая задача |
|---|---|---|
| Качество данных и фильтрация | Настройка максимального допустимого уровня ошибок загрузки | Нестабильное качество данных: требуется допускать некорректные данные. |
| Качество данных и фильтрация | Настройка условий фильтрации при загрузке | Загрузка только данных, удовлетворяющих условиям. |
| Качество данных и фильтрация | Загрузка в строгом режиме | Строгая фильтрация ошибок преобразования типов. |
| Управление получением данных | Получение данных с указанного смещения | Точное управление смещением Kafka. |
| Управление получением данных | Указание group.id и client.id группы потребителей | Настройка пользовательского идентификатора потребителя Kafka. |
| Управление записью данных | Загрузка данных в указанную партицию | Запись только в указанные партиции целевой таблицы. |
| Управление записью данных | Настройка часового пояса загрузки | Обработка временных полей с учётом часовых поясов. |
| Управление записью данных | Настройка merge_type | Удаление или слияние при записи в таблицу Unique Key. |
| Преобразование данных | Сопоставление столбцов и вычисление производных столбцов при загрузке | Вычисление полей во время загрузки. |
| Преобразование данных | Загрузка данных с символами обрамления | Наличие разделителей в полях CSV. |
| Сложные форматы | Загрузка в формате JSON | Данные Kafka в формате JSON. |
| Сложные форматы | Загрузка сложных типов | Обработка типов Array, Map, Bitmap и HLL. |
| Безопасность и работа с несколькими таблицами | Аутентификация Kafka | Сценарии аутентификации SSL/Kerberos/PLAIN и другие. |
| Безопасность и работа с несколькими таблицами | Загрузка из одного потока в несколько таблиц | Запись данных из одного топика в несколько таблиц Doris. |
Настройка максимального допустимого уровня ошибок загрузки
-
Пример загружаемых данных:
1,Benjamin,18
2,Emily,20
3,Alexander,dirty_data -
Схема таблицы:
CREATE TABLE demo.routine_test01 (
    id       INT             NOT NULL   COMMENT "User ID",
    name     VARCHAR(30)     NOT NULL   COMMENT "Name",
    age      INT                        COMMENT "Age"
)
DUPLICATE KEY(`id`)
DISTRIBUTED BY HASH(`id`) BUCKETS 1; -
Команда загрузки:
CREATE ROUTINE LOAD demo.kafka_job01 ON routine_test01
        COLUMNS TERMINATED BY ","
        PROPERTIES
        (
            "max_filter_ratio"="0.5",
            "max_error_number" = "100",
            "strict_mode" = "true"
        )
        FROM KAFKA
        (
            "kafka_broker_list" = "10.16.10.6:9092",
            "kafka_topic" = "routineLoad01",
            "property.kafka_default_offsets" = "OFFSET_BEGINNING"
); -
Результат загрузки:
mysql> select * from routine_test01;
+------+------------+------+
| id   | name       | age  |
+------+------------+------+
|    1 | Benjamin   |   18 |
|    2 | Emily      |   20 |
+------+------------+------+
2 rows in set (0.01 sec)
Получение данных с указанного смещения
-
Пример загружаемых данных:
1,Benjamin,18
2,Emily,20
3,Alexander,22
4,Sophia,24
5,William,26
6,Charlotte,28 -
Схема таблицы:
CREATE TABLE demo.routine_test02 (
    id       INT             NOT NULL   COMMENT "User ID",
    name     VARCHAR(30)     NOT NULL   COMMENT "Name",
    age      INT                        COMMENT "Age"
)
DUPLICATE KEY(`id`)
DISTRIBUTED BY HASH(`id`) BUCKETS 1; -
Команда загрузки:
CREATE ROUTINE LOAD demo.kafka_job02 ON routine_test02
        COLUMNS TERMINATED BY ","
        FROM KAFKA
        (
            "kafka_broker_list" = "10.16.10.6:9092",
            "kafka_topic" = "routineLoad02",
            "kafka_partitions" = "0",
            "kafka_offsets" = "3"
); -
Результат загрузки:
mysql> select * from routine_test02;
+------+--------------+------+
| id   | name         | age  |
+------+--------------+------+
|    4 | Sophia       |   24 |
|    5 | William      |   26 |
|    6 | Charlotte    |   28 |
+------+--------------+------+
3 rows in set (0.01 sec)
Указание group.id и client.id группы потребителей
-
Пример загружаемых данных:
1,Benjamin,18
2,Emily,20
3,Alexander,22 -
Схема таблицы:
CREATE TABLE demo.routine_test03 (
    id       INT             NOT NULL   COMMENT "User ID",
    name     VARCHAR(30)     NOT NULL   COMMENT "Name",
    age      INT                        COMMENT "Age"
)
DUPLICATE KEY(`id`)
DISTRIBUTED BY HASH(`id`) BUCKETS 1; -
Команда загрузки:
CREATE ROUTINE LOAD demo.kafka_job03 ON routine_test03
        COLUMNS TERMINATED BY ","
        FROM KAFKA
        (
            "kafka_broker_list" = "10.16.10.6:9092",
            "kafka_topic" = "routineLoad01",
            "property.group.id" = "kafka_job03",
            "property.client.id" = "kafka_client_03",
            "property.kafka_default_offsets" = "OFFSET_BEGINNING"
); -
Результат загрузки:
mysql> select * from routine_test03;
+------+------------+------+
| id   | name       | age  |
+------+------------+------+
|    1 | Benjamin   |   18 |
|    2 | Emily      |   20 |
|    3 | Alexander  |   22 |
+------+------------+------+
3 rows in set (0.01 sec)
Настройка условий фильтрации при загрузке
-
Пример загружаемых данных:
1,Benjamin,18
2,Emily,20
3,Alexander,22
4,Sophia,24
5,William,26
6,Charlotte,28 -
Схема таблицы:
CREATE TABLE demo.routine_test04 (
    id       INT             NOT NULL   COMMENT "User ID",
    name     VARCHAR(30)     NOT NULL   COMMENT "Name",
    age      INT                        COMMENT "Age"
)
DUPLICATE KEY(`id`)
DISTRIBUTED BY HASH(`id`) BUCKETS 1; -
Команда загрузки:
CREATE ROUTINE LOAD demo.kafka_job04 ON routine_test04
        COLUMNS TERMINATED BY ",",
        WHERE id >= 3
        FROM KAFKA
        (
            "kafka_broker_list" = "10.16.10.6:9092",
            "kafka_topic" = "routineLoad04",
            "property.kafka_default_offsets" = "OFFSET_BEGINNING"
); -
Результат загрузки:
mysql> select * from routine_test04;
+------+--------------+------+
| id   | name         | age  |
+------+--------------+------+
|    4 | Sophia       |   24 |
|    5 | William      |   26 |
|    6 | Charlotte    |   28 |
+------+--------------+------+
3 rows in set (0.01 sec)
Загрузка данных в указанную партицию
-
Пример загружаемых данных:
1,Benjamin,18,2024-02-04 10:00:00
2,Emily,20,2024-02-05 11:00:00
3,Alexander,22,2024-02-06 12:00:00 -
Схема таблицы:
CREATE TABLE demo.routine_test05 (
    id      INT            NOT NULL  COMMENT "ID",
    name    VARCHAR(30)    NOT NULL  COMMENT "Name",
    age     INT                      COMMENT "Age",
    date    DATETIME                 COMMENT "Date"
)
DUPLICATE KEY(`id`)
PARTITION BY RANGE(`id`)
(PARTITION partition_a VALUES [("0"), ("1")),
PARTITION partition_b VALUES [("1"), ("2")),
PARTITION partition_c VALUES [("2"), ("3")))
DISTRIBUTED BY HASH(`id`) BUCKETS 1; -
Команда загрузки:
CREATE ROUTINE LOAD demo.kafka_job05 ON routine_test05
        COLUMNS TERMINATED BY ",",
        PARTITION(partition_b)
        FROM KAFKA
        (
            "kafka_broker_list" = "10.16.10.6:9092",
            "kafka_topic" = "routineLoad05",
            "property.kafka_default_offsets" = "OFFSET_BEGINNING"
); -
Результат загрузки:
mysql> select * from routine_test05;
+------+----------+------+---------------------+
| id   | name     | age  | date                |
+------+----------+------+---------------------+
|    1 | Benjamin |   18 | 2024-02-04 10:00:00 |
+------+----------+------+---------------------+
1 rows in set (0.01 sec)
Настройка часового пояса загрузки
-
Пример загружаемых данных:
1,Benjamin,18,2024-02-04 10:00:00
2,Emily,20,2024-02-05 11:00:00
3,Alexander,22,2024-02-06 12:00:00 -
Схема таблицы:
CREATE TABLE demo.routine_test06 (
    id      INT            NOT NULL  COMMENT "id",
    name    VARCHAR(30)    NOT NULL  COMMENT "name",
    age     INT                      COMMENT "age",
    date    DATETIME                 COMMENT "date"
)
DUPLICATE KEY(id)
DISTRIBUTED BY HASH(id) BUCKETS 1; -
Команда загрузки:
CREATE ROUTINE LOAD demo.kafka_job06 ON routine_test06
        COLUMNS TERMINATED BY ","
        PROPERTIES
        (
            "timezone" = "Asia/Shanghai"
        )
        FROM KAFKA
        (
            "kafka_broker_list" = "10.16.10.6:9092",
            "kafka_topic" = "routineLoad06",
            "property.kafka_default_offsets" = "OFFSET_BEGINNING"
); -
Результат загрузки:
mysql> select * from routine_test06;
+------+-------------+------+---------------------+
| id   | name        | age  | date                |
+------+-------------+------+---------------------+
|    1 | Benjamin    |   18 | 2024-02-04 10:00:00 |
|    2 | Emily       |   20 | 2024-02-05 11:00:00 |
|    3 | Alexander   |   22 | 2024-02-06 12:00:00 |
+------+-------------+------+---------------------+
3 rows in set (0.00 sec)
Настройка merge_type
Указание merge_type для удаления
-
Пример загружаемых данных:
3,Alexander,22
5,William,26
Данные в таблице до загрузки:
mysql> SELECT * FROM routine_test07;
+------+----------------+------+
| id   | name           | age  |
+------+----------------+------+
|    1 | Benjamin       |   18 |
|    2 | Emily          |   20 |
|    3 | Alexander      |   22 |
|    4 | Sophia         |   24 |
|    5 | William        |   26 |
|    6 | Charlotte      |   28 |
+------+----------------+------+ -
Схема таблицы:
CREATE TABLE demo.routine_test07 (
    id      INT            NOT NULL  COMMENT "id",
    name    VARCHAR(30)    NOT NULL  COMMENT "name",
    age     INT                      COMMENT "age"
)
UNIQUE KEY(id)
DISTRIBUTED BY HASH(id) BUCKETS 1; -
Команда загрузки:
CREATE ROUTINE LOAD demo.kafka_job07 ON routine_test07
        WITH DELETE
        COLUMNS TERMINATED BY ","
        FROM KAFKA
        (
            "kafka_broker_list" = "10.16.10.6:9092",
            "kafka_topic" = "routineLoad07",
            "property.kafka_default_offsets" = "OFFSET_BEGINNING"
); -
Результат загрузки:
mysql> SELECT * FROM routine_test07;
+------+----------------+------+
| id   | name           | age  |
+------+----------------+------+
|    1 | Benjamin       |   18 |
|    2 | Emily          |   20 |
|    4 | Sophia         |   24 |
|    6 | Charlotte      |   28 |
+------+----------------+------+
Указание merge_type для слияния
-
Пример загружаемых данных:
1,xiaoxiaoli,28
2,xiaoxiaowang,30
3,xiaoxiaoliu,32
4,dadali,34
5,dadawang,36
6,dadaliu,38
Данные в таблице до загрузки:
mysql> SELECT * FROM routine_test08;
+------+----------------+------+
| id   | name           | age  |
+------+----------------+------+
|    1 | Benjamin       |   18 |
|    2 | Emily          |   20 |
|    3 | Alexander      |   22 |
|    4 | Sophia         |   24 |
|    5 | William        |   26 |
|    6 | Charlotte      |   28 |
+------+----------------+------+
6 rows in set (0.01 sec) -
Схема таблицы:
CREATE TABLE demo.routine_test08 (
    id      INT            NOT NULL  COMMENT "id",
    name    VARCHAR(30)    NOT NULL  COMMENT "name",
    age     INT                      COMMENT "age"
)
UNIQUE KEY(id)
DISTRIBUTED BY HASH(id) BUCKETS 1; -
Команда загрузки:
CREATE ROUTINE LOAD demo.kafka_job08 ON routine_test08
        WITH MERGE
        COLUMNS TERMINATED BY ",",
        DELETE ON id = 2
        FROM KAFKA
        (
            "kafka_broker_list" = "10.16.10.6:9092",
            "kafka_topic" = "routineLoad08",
            "property.kafka_default_offsets" = "OFFSET_BEGINNING"
); -
Результат загрузки:
mysql> SELECT * FROM routine_test08;
+------+-------------+------+
| id   | name        | age  |
+------+-------------+------+
|    1 | xiaoxiaoli  |   28 |
|    3 | xiaoxiaoliu |   32 |
|    4 | dadali      |   34 |
|    5 | dadawang    |   36 |
|    6 | dadaliu     |   38 |
+------+-------------+------+
5 rows in set (0.00 sec)
Указание Sequence Column для загрузки со слиянием
-
Пример загружаемых данных:
1,xiaoxiaoli,28
2,xiaoxiaowang,30
3,xiaoxiaoliu,32
4,dadali,34
5,dadawang,36
6,dadaliu,38
Данные в таблице до загрузки:
mysql> SELECT * FROM routine_test09;
+------+----------------+------+
| id   | name           | age  |
+------+----------------+------+
|    1 | Benjamin       |   18 |
|    2 | Emily          |   20 |
|    3 | Alexander      |   22 |
|    4 | Sophia         |   24 |
|    5 | William        |   26 |
|    6 | Charlotte      |   28 |
+------+----------------+------+
6 rows in set (0.01 sec) -
Схема таблицы:
CREATE TABLE demo.routine_test08 (
    id      INT            NOT NULL  COMMENT "id",
    name    VARCHAR(30)    NOT NULL  COMMENT "name",
    age     INT                      COMMENT "age"
)
UNIQUE KEY(id)
DISTRIBUTED BY HASH(id) BUCKETS 1
PROPERTIES (
    "function_column.sequence_col" = "age"
); -
Команда загрузки:
CREATE ROUTINE LOAD demo.kafka_job09 ON routine_test09
        WITH MERGE
        COLUMNS TERMINATED BY ",",
        COLUMNS(id, name, age),
        DELETE ON id = 2,
        ORDER BY age
        PROPERTIES
        (
            "desired_concurrent_number"="1",
            "strict_mode" = "false"
        )
        FROM KAFKA
        (
            "kafka_broker_list" = "10.16.10.6:9092",
            "kafka_topic" = "routineLoad09",
            "property.kafka_default_offsets" = "OFFSET_BEGINNING"
); -
Результат загрузки:
mysql> SELECT * FROM routine_test09;
+------+-------------+------+
| id   | name        | age  |
+------+-------------+------+
|    1 | xiaoxiaoli  |   28 |
|    3 | xiaoxiaoliu |   32 |
|    4 | dadali      |   34 |
|    5 | dadawang    |   36 |
|    6 | dadaliu     |   38 |
+------+-------------+------+
5 rows in set (0.00 sec)
Сопоставление столбцов и вычисление производных столбцов при загрузке
-
Пример загружаемых данных:
1,Benjamin,18
2,Emily,20
3,Alexander,22 -
Схема таблицы:
CREATE TABLE demo.routine_test10 (
    id      INT            NOT NULL  COMMENT "id",
    name    VARCHAR(30)    NOT NULL  COMMENT "name",
    age     INT                      COMMENT "age",
    num     INT                      COMMENT "number"
)
DUPLICATE KEY(`id`)
DISTRIBUTED BY HASH(`id`) BUCKETS 1; -
Команда загрузки:
CREATE ROUTINE LOAD demo.kafka_job10 ON routine_test10
        COLUMNS TERMINATED BY ",",
        COLUMNS(id, name, age, num=age*10)
        FROM KAFKA
        (
            "kafka_broker_list" = "10.16.10.6:9092",
            "kafka_topic" = "routineLoad10",
            "property.kafka_default_offsets" = "OFFSET_BEGINNING"
); -
Результат загрузки:
mysql> SELECT * FROM routine_test10;
+------+----------------+------+------+
| id   | name           | age  | num  |
+------+----------------+------+------+
|    1 | Benjamin       |   18 |  180 |
|    2 | Emily          |   20 |  200 |
|    3 | Alexander      |   22 |  220 |
+------+----------------+------+------+
3 rows in set (0.01 sec)
Загрузка данных с символами обрамления
-
Пример загружаемых данных:
1,"Benjamin",18
2,"Emily",20
3,"Alexander",22 -
Схема таблицы:
CREATE TABLE demo.routine_test11 (
    id      INT            NOT NULL  COMMENT "id",
    name    VARCHAR(30)    NOT NULL  COMMENT "name",
    age     INT                      COMMENT "age",
    num     INT                      COMMENT "number"
)
DUPLICATE KEY(`id`)
DISTRIBUTED BY HASH(`id`) BUCKETS 1; -
Команда загрузки:
CREATE ROUTINE LOAD demo.kafka_job11 ON routine_test11
        COLUMNS TERMINATED BY ","
        PROPERTIES
        (
            "desired_concurrent_number"="1",
            "enclose" = "\""
        )
        FROM KAFKA
        (
            "kafka_broker_list" = "10.16.10.6:9092",
            "kafka_topic" = "routineLoad12",
            "property.kafka_default_offsets" = "OFFSET_BEGINNING"
); -
Результат загрузки:
mysql> SELECT * FROM routine_test11;
+------+----------------+------+------+
| id   | name           | age  | num  |
+------+----------------+------+------+
|    1 | Benjamin       |   18 |  180 |
|    2 | Emily          |   20 |  200 |
|    3 | Alexander      |   22 |  220 |
+------+----------------+------+------+
3 rows in set (0.02 sec)
Загрузка в формате JSON
Загрузка данных JSON в простом режиме
-
Пример загружаемых данных:
{ "id" : 1, "name" : "Benjamin", "age":18 }
{ "id" : 2, "name" : "Emily", "age":20 }
{ "id" : 3, "name" : "Alexander", "age":22 } -
Схема таблицы:
CREATE TABLE demo.routine_test12 (
    id      INT            NOT NULL  COMMENT "id",
    name    VARCHAR(30)    NOT NULL  COMMENT "name",
    age     INT                      COMMENT "age"
)
DUPLICATE KEY(`id`)
DISTRIBUTED BY HASH(`id`) BUCKETS 1; -
Команда загрузки:
CREATE ROUTINE LOAD demo.kafka_job12 ON routine_test12
        PROPERTIES
        (
            "format" = "json"
        )
        FROM KAFKA
        (
            "kafka_broker_list" = "10.16.10.6:9092",
            "kafka_topic" = "routineLoad12",
            "property.kafka_default_offsets" = "OFFSET_BEGINNING"
); -
Результат загрузки:
mysql> select * from routine_test12;
+------+----------------+------+
| id   | name           | age  |
+------+----------------+------+
|    1 | Benjamin       |   18 |
|    2 | Emily          |   20 |
|    3 | Alexander      |   22 |
+------+----------------+------+
3 rows in set (0.02 sec)
Загрузка сложных данных JSON в режиме сопоставления
-
Пример загружаемых данных:
{ "name" : "Benjamin", "id" : 1, "num":180 , "age":18 }
{ "name" : "Emily", "id" : 2, "num":200 , "age":20 }
{ "name" : "Alexander", "id" : 3, "num":220 , "age":22 } -
Схема таблицы:
CREATE TABLE demo.routine_test13 (
    id      INT            NOT NULL  COMMENT "id",
    name    VARCHAR(30)    NOT NULL  COMMENT "name",
    age     INT                      COMMENT "age",
    num     INT                      COMMENT "num"
)
DUPLICATE KEY(`id`)
DISTRIBUTED BY HASH(`id`) BUCKETS 1; -
Команда загрузки:
CREATE ROUTINE LOAD demo.kafka_job13 ON routine_test13
        COLUMNS(name, id, num, age)
        PROPERTIES
        (
            "format" = "json",
            "jsonpaths" = "[\"$.name\",\"$.id\",\"$.num\",\"$.age\"]"
        )
        FROM KAFKA
        (
            "kafka_broker_list" = "10.16.10.6:9092",
            "kafka_topic" = "routineLoad13",
            "property.kafka_default_offsets" = "OFFSET_BEGINNING"
); -
Результат загрузки:
mysql> select * from routine_test13;
+------+----------------+------+------+
| id   | name           | age  | num  |
+------+----------------+------+------+
|    1 | Benjamin       |   18 |  180 |
|    2 | Emily          |   20 |  200 |
|    3 | Alexander      |   22 |  220 |
+------+----------------+------+------+
3 rows in set (0.01 sec)
Загрузка данных с указанным корневым узлом JSON
-
Пример загружаемых данных:
{"id": 1231, "source" :{ "id" : 1, "name" : "Benjamin", "age":18 }}
{"id": 1232, "source" :{ "id" : 2, "name" : "Emily", "age":20 }}
{"id": 1233, "source" :{ "id" : 3, "name" : "Alexander", "age":22 }} -
Схема таблицы:
CREATE TABLE demo.routine_test14 (
    id      INT            NOT NULL  COMMENT "id",
    name    VARCHAR(30)    NOT NULL  COMMENT "name",
    age     INT                      COMMENT "age"
)
DUPLICATE KEY(`id`)
DISTRIBUTED BY HASH(`id`) BUCKETS 1; -
Команда загрузки:
CREATE ROUTINE LOAD demo.kafka_job14 ON routine_test14
        PROPERTIES
        (
            "format" = "json",
            "json_root" = "$.source"
        )
        FROM KAFKA
        (
            "kafka_broker_list" = "10.16.10.6:9092",
            "kafka_topic" = "routineLoad14",
            "property.kafka_default_offsets" = "OFFSET_BEGINNING"
); -
Результат загрузки:
mysql> select * from routine_test14;
+------+----------------+------+
| id   | name           | age  |
+------+----------------+------+
|    1 | Benjamin       |   18 |
|    2 | Emily          |   20 |
|    3 | Alexander      |   22 |
+------+----------------+------+
3 rows in set (0.01 sec)
Сопоставление столбцов и вычисление производных столбцов при загрузке (JSON)
-
Пример загружаемых данных:
{ "id" : 1, "name" : "Benjamin", "age":18 }
{ "id" : 2, "name" : "Emily", "age":20 }
{ "id" : 3, "name" : "Alexander", "age":22 } -
Схема таблицы:
CREATE TABLE demo.routine_test15 (
    id      INT            NOT NULL  COMMENT "id",
    name    VARCHAR(30)    NOT NULL  COMMENT "name",
    age     INT                      COMMENT "age",
    num     INT                      COMMENT "num"
)
DUPLICATE KEY(`id`)
DISTRIBUTED BY HASH(`id`) BUCKETS 1; -
Команда загрузки:
CREATE ROUTINE LOAD demo.kafka_job15 ON routine_test15
        COLUMNS(id, name, age, num=age*10)
        PROPERTIES
        (
            "format" = "json"
        )
        FROM KAFKA
        (
            "kafka_broker_list" = "10.16.10.6:9092",
            "kafka_topic" = "routineLoad15",
            "property.kafka_default_offsets" = "OFFSET_BEGINNING"
); -
Результат загрузки:
mysql> select * from routine_test15;
+------+----------------+------+------+
| id   | name           | age  | num  |
+------+----------------+------+------+
|    1 | Benjamin       |   18 |  180 |
|    2 | Emily          |   20 |  200 |
|    3 | Alexander      |   22 |  220 |
+------+----------------+------+------+
3 rows in set (0.01 sec)
Гибкое частичное обновление столбцов
В этом примере показано гибкое частичное обновление столбцов, при котором в каждой строке могут обновляться разные столбцы. Это особенно полезно в сценариях CDC, поскольку записи об изменениях могут содержать разные поля.
-
Пример загружаемых данных (каждая запись JSON обновляет разные столбцы):
{"id": 1, "balance": 150.00, "last_active": "2024-01-15 10:30:00"}
{"id": 2, "city": "Shanghai", "age": 28}
{"id": 3, "name": "Alice", "balance": 500.00, "city": "Beijing"}
{"id": 1, "age": 30}
{"id": 4, "__DORIS_DELETE_SIGN__": 1} -
Создайте таблицу (необходимо включить Merge-on-Write и столбец skip bitmap):
CREATE TABLE demo.routine_test_flexible (
    id           INT            NOT NULL  COMMENT "id",
    name         VARCHAR(30)              COMMENT "name",
    age          INT                      COMMENT "age",
    city         VARCHAR(50)              COMMENT "city",
    balance      DECIMAL(10,2)            COMMENT "balance",
    last_active  DATETIME                 COMMENT "last active time"
)
UNIQUE KEY(`id`)
DISTRIBUTED BY HASH(`id`) BUCKETS 1
PROPERTIES (
    "replication_num" = "1",
    "enable_unique_key_merge_on_write" = "true",
    "enable_unique_key_skip_bitmap_column" = "true"
); -
Вставьте исходные данные:
INSERT INTO demo.routine_test_flexible VALUES
(1, 'John', 25, 'Shenzhen', 100.00, '2024-01-01 08:00:00'),
(2, 'Jane', 30, 'Guangzhou', 200.00, '2024-01-02 09:00:00'),
(3, 'Bob', 35, 'Hangzhou', 300.00, '2024-01-03 10:00:00'),
(4, 'Tom', 40, 'Nanjing', 400.00, '2024-01-04 11:00:00'); -
Команда загрузки:
CREATE ROUTINE LOAD demo.kafka_job_flexible ON routine_test_flexible
        PROPERTIES
        (
            "format" = "json",
            "unique_key_update_mode" = "UPDATE_FLEXIBLE_COLUMNS"
        )
        FROM KAFKA
        (
            "kafka_broker_list" = "10.16.10.6:9092",
            "kafka_topic" = "routineLoadFlexible",
            "property.kafka_default_offsets" = "OFFSET_BEGINNING"
); -
Результат загрузки:
mysql> SELECT * FROM demo.routine_test_flexible ORDER BY id;
+------+-------+------+-----------+---------+---------------------+
| id   | name  | age  | city      | balance | last_active         |
+------+-------+------+-----------+---------+---------------------+
|    1 | John  |   30 | Shenzhen  |  150.00 | 2024-01-15 10:30:00 |
|    2 | Jane  |   28 | Shanghai  |  200.00 | 2024-01-02 09:00:00 |
|    3 | Alice |   35 | Beijing   |  500.00 | 2024-01-03 10:00:00 |
+------+-------+------+-----------+---------+---------------------+
3 rows in set (0.01 sec)ПримечаниеСтрока с
id=4удаляется благодаря__DORIS_DELETE_SIGN__. Для каждой строки обновляются только столбцы, включённые в соответствующую запись JSON.
Загрузка сложных типов
Загрузка данных типа Array
-
Пример загружаемых данных:
{ "id" : 1, "name" : "Benjamin", "age":18, "array":[1,2,3,4,5]}
{ "id" : 2, "name" : "Emily", "age":20, "array":[6,7,8,9,10]}
{ "id" : 3, "name" : "Alexander", "age":22, "array":[11,12,13,14,15]} -
Схема таблицы:
CREATE TABLE demo.routine_test16
(
    id      INT             NOT NULL  COMMENT "id",
    name    VARCHAR(30)     NOT NULL  COMMENT "name",
    age     INT                       COMMENT "age",
    array   ARRAY<int(11)>  NULL      COMMENT "test array column"
)
DUPLICATE KEY(`id`)
DISTRIBUTED BY HASH(`id`) BUCKETS 1; -
Команда загрузки:
CREATE ROUTINE LOAD demo.kafka_job16 ON routine_test16
        PROPERTIES
        (
            "format" = "json"
        )
        FROM KAFKA
        (
            "kafka_broker_list" = "10.16.10.6:9092",
            "kafka_topic" = "routineLoad16",
            "property.kafka_default_offsets" = "OFFSET_BEGINNING"
); -
Результат загрузки:
mysql> select * from routine_test16;
+------+----------------+------+----------------------+
| id   | name           | age  | array                |
+------+----------------+------+----------------------+
|    1 | Benjamin       |   18 | [1, 2, 3, 4, 5]      |
|    2 | Emily          |   20 | [6, 7, 8, 9, 10]     |
|    3 | Alexander      |   22 | [11, 12, 13, 14, 15] |
+------+----------------+------+----------------------+
3 rows in set (0.00 sec)
Загрузка данных типа Map
-
Пример загружаемых данных:
{ "id" : 1, "name" : "Benjamin", "age":18, "map":{"a": 100, "b": 200}}
{ "id" : 2, "name" : "Emily", "age":20, "map":{"c": 300, "d": 400}}
{ "id" : 3, "name" : "Alexander", "age":22, "map":{"e": 500, "f": 600}} -
Схема таблицы:
CREATE TABLE demo.routine_test17 (
    id      INT                 NOT NULL  COMMENT "id",
    name    VARCHAR(30)         NOT NULL  COMMENT "name",
    age     INT                           COMMENT "age",
    map     Map<STRING, INT>    NULL      COMMENT "test column"
)
DUPLICATE KEY(`id`)
DISTRIBUTED BY HASH(`id`) BUCKETS 1; -
Команда загрузки:
CREATE ROUTINE LOAD demo.kafka_job17 ON routine_test17
    PROPERTIES
        (
            "format" = "json"
        )
        FROM KAFKA
        (
            "kafka_broker_list" = "10.16.10.6:9092",
            "kafka_topic" = "routineLoad17",
            "property.kafka_default_offsets" = "OFFSET_BEGINNING"
); -
Результат загрузки:
mysql> select * from routine_test17;
+------+----------------+------+--------------------+
| id   | name           | age  | map                |
+------+----------------+------+--------------------+
|    1 | Benjamin       |   18 | {"a":100, "b":200} |
|    2 | Emily          |   20 | {"c":300, "d":400} |
|    3 | Alexander      |   22 | {"e":500, "f":600} |
+------+----------------+------+--------------------+
3 rows in set (0.01 sec)
Загрузка данных типа Bitmap
-
Пример загружаемых данных:
{ "id" : 1, "name" : "Benjamin", "age":18, "bitmap_id":243}
{ "id" : 2, "name" : "Emily", "age":20, "bitmap_id":28574}
{ "id" : 3, "name" : "Alexander", "age":22, "bitmap_id":8573} -
Схема таблицы:
CREATE TABLE demo.routine_test18 (
    id        INT            NOT NULL      COMMENT "id",
    name      VARCHAR(30)    NOT NULL      COMMENT "name",
    age       INT                          COMMENT "age",
    bitmap_id INT                          COMMENT "test",
    device_id BITMAP         BITMAP_UNION  COMMENT "test column"
)
AGGREGATE KEY (`id`,`name`,`age`,`bitmap_id`)
DISTRIBUTED BY HASH(`id`) BUCKETS 1; -
Команда загрузки:
CREATE ROUTINE LOAD demo.kafka_job18 ON routine_test18
        COLUMNS(id, name, age, bitmap_id, device_id=to_bitmap(bitmap_id))
        PROPERTIES
        (
            "format" = "json"
        )
        FROM KAFKA
        (
            "kafka_broker_list" = "10.16.10.6:9092",
            "kafka_topic" = "routineLoad18",
            "property.kafka_default_offsets" = "OFFSET_BEGINNING"
); -
Результат загрузки:
mysql> select id, BITMAP_UNION_COUNT(pv) over(order by id) uv from(
    ->    select id, BITMAP_UNION(device_id) as pv
    ->    from routine_test18
    -> group by id
    -> ) final;
+------+------+
| id   | uv   |
+------+------+
|    1 |    1 |
|    2 |    2 |
|    3 |    3 |
+------+------+
3 rows in set (0.00 sec)
Загрузка данных типа HLL
-
Пример загружаемых данных:
2022-05-05,10001,Test01,Beijing,windows
2022-05-05,10002,Test01,Beijing,linux
2022-05-05,10003,Test01,Beijing,macos
2022-05-05,10004,Test01,Hebei,windows
2022-05-06,10001,Test01,Shanghai,windows
2022-05-06,10002,Test01,Shanghai,linux
2022-05-06,10003,Test01,Jiangsu,macos
2022-05-06,10004,Test01,Shaanxi,windows -
Схема таблицы:
create table demo.routine_test19 (
    dt        DATE,
    id        INT,
    name      VARCHAR(10),
    province  VARCHAR(10),
    os        VARCHAR(10),
    pv        hll hll_union
)
Aggregate KEY (dt,id,name,province,os)
distributed by hash(id) buckets 10; -
Команда загрузки:
CREATE ROUTINE LOAD demo.kafka_job19 ON routine_test19
        COLUMNS TERMINATED BY ",",
        COLUMNS(dt, id, name, province, os, pv=hll_hash(id))
        FROM KAFKA
        (
            "kafka_broker_list" = "10.16.10.6:9092",
            "kafka_topic" = "routineLoad19",
            "property.kafka_default_offsets" = "OFFSET_BEGINNING"
); -
Результат загрузки:
mysql> select * from routine_test19;
+------------+-------+----------+----------+---------+------+
| dt         | id    | name     | province | os      | pv   |
+------------+-------+----------+----------+---------+------+
| 2022-05-05 | 10001 | Test01   | Beijing     | windows | NULL |
| 2022-05-06 | 10001 | Test01   | Shanghai    | windows | NULL |
| 2022-05-05 | 10002 | Test01   | Beijing     | linux   | NULL |
| 2022-05-06 | 10002 | Test01   | Shanghai    | linux   | NULL |
| 2022-05-05 | 10004 | Test01   | Heibei      | windows | NULL |
| 2022-05-06 | 10004 | Test01   | Shanxi      | windows | NULL |
| 2022-05-05 | 10003 | Test01   | Beijing     | macos   | NULL |
| 2022-05-06 | 10003 | Test01   | Jiangsu     | macos   | NULL |
+------------+-------+----------+----------+---------+------+
8 rows in set (0.01 sec)

mysql> SELECT HLL_UNION_AGG(pv) FROM routine_test19;
+-------------------+
| hll_union_agg(pv) |
+-------------------+
|                 4 |
+-------------------+
1 row in set (0.01 sec)
Аутентификация Kafka
Doris поддерживает следующие способы доступа с использованием протоколов безопасности Kafka. Ниже приведены примеры загрузки и описания параметров.
Загрузка данных Kafka с аутентификацией SSL
Пример команды загрузки:
CREATE ROUTINE LOAD demo.kafka_job20 ON routine_test20
        PROPERTIES
        (
            "format" = "json"
        )
        FROM KAFKA
        (
            "kafka_broker_list" = "192.168.100.129:9092",
            "kafka_topic" = "routineLoad21",
            "property.security.protocol" = "ssl",
            "property.ssl.ca.location" = "FILE:ca.pem",
            "property.ssl.certificate.location" = "FILE:client.pem",
            "property.ssl.key.location" = "FILE:client.key",
            "property.ssl.key.password" = "ssl_passwd"
        );
Описание параметров:
| Параметр | Описание |
|---|---|
| property.security.protocol | Используемый протокол безопасности. В примере выше используется SSL. |
| property.ssl.ca.location | Расположение сертификата центра сертификации (CA). |
| property.ssl.certificate.location | (Требуется только при включённой аутентификации клиентов на сервере Kafka) Расположение открытого ключа клиента. |
| property.ssl.key.location | (Требуется только при включённой аутентификации клиентов на сервере Kafka) Расположение закрытого ключа клиента. |
| property.ssl.key.password | (Требуется только при включённой аутентификации клиентов на сервере Kafka) Пароль закрытого ключа клиента. |
Загрузка данных Kafka с аутентификацией Kerberos
Пример команды загрузки:
CREATE ROUTINE LOAD demo.kafka_job21 ON routine_test21
        PROPERTIES
        (
            "format" = "json"
        )
        FROM KAFKA
        (
            "kafka_broker_list" = "192.168.100.129:9092",
            "kafka_topic" = "routineLoad21",
            "property.security.protocol" = "SASL_PLAINTEXT",
            "property.sasl.kerberos.service.name" = "kafka",
            "property.sasl.kerberos.keytab"="/opt/third/kafka/kerberos/kafka_client.keytab",
            "property.sasl.kerberos.principal" = "clients/stream.dt.local@EXAMPLE.COM"
        );
Описание параметров:
| Параметр | Описание |
|---|---|
| property.security.protocol | Используемый протокол безопасности. В примере выше используется SASL_PLAINTEXT. |
| property.sasl.kerberos.service.name | Задаёт имя службы брокера. По умолчанию — Kafka. |
| property.sasl.kerberos.keytab | Расположение файла keytab. |
| property.sasl.kerberos.principal | Задаёт principal Kerberos. |
Рекомендуется задать rdnbs=true в krb5.conf. Иначе может возникнуть следующая ошибка: Server kafka/15.5.4.68@EXAMPLE.COM not found in Kerberos database
Загрузка из кластера Kafka с аутентификацией PLAIN
Пример команды загрузки:
CREATE ROUTINE LOAD demo.kafka_job22 ON routine_test22
        PROPERTIES
        (
            "format" = "json"
        )
        FROM KAFKA
        (
            "kafka_broker_list" = "192.168.100.129:9092",
            "kafka_topic" = "routineLoad22",
            "property.security.protocol"="SASL_PLAINTEXT",
            "property.sasl.mechanism"="PLAIN",
            "property.sasl.username"="admin",
            "property.sasl.password"="admin"
        );
Описание параметров:
| Параметр | Описание |
|---|---|
| property.security.protocol | Используемый протокол безопасности. В примере выше используется SASL_PLAINTEXT. |
| property.sasl.mechanism | Задаёт PLAIN в качестве механизма аутентификации SASL. |
| property.sasl.username | Имя пользователя SASL. |
| property.sasl.password | Пароль SASL. |
Подключение к службе Kafka с шифрованием и аутентификацией (пример StreamNative)
Рассмотрим доступ к службе обмена сообщениями StreamNative:
CREATE ROUTINE LOAD example_db.test1 ON example_tbl
COLUMNS(user_id, name, age)
FROM KAFKA (
    "kafka_broker_list" = "pc-xxxx.aws-mec1-test-xwiqv.aws.snio.cloud:9093",
    "kafka_topic" = "my_topic",
    "property.security.protocol" = "SASL_SSL",
    "property.sasl.mechanism" = "PLAIN",
    "property.sasl.username" = "user",
    "property.sasl.password" = "token:eyJhbxxx",
    "property.group.id" = "my_group_id_1",
    "property.client.id" = "my_client_id_1",
    "property.enable.ssl.certificate.verification" = "false"
);
- Если на стороне BE не настроен путь к доверенному сертификату CA, задайте
"property.enable.ssl.certificate.verification" = "false", чтобы пропустить проверку сертификата сервера. - В противном случае укажите путь к доверенному сертификату CA:
"property.ssl.ca.location" = "/path/to/ca-cert.pem".
Загрузка из одного потока в несколько таблиц
Создайте задачу Routine Load для Kafka с динамическим выбором нескольких таблиц, задав имя test1 для базы данных example_db. Укажите group.id и client.id; по умолчанию данные автоматически получаются из всех партиций, а подписка начинается с позиции, с которой доступны данные (OFFSET_BEGINNING).
Предположим, вам нужно загрузить данные из Kafka в таблицы tbl1 и tbl2 базы данных example_db. Можно создать задачу Routine Load с именем test1 для загрузки данных топика Kafka my_topic в обе таблицы: tbl1 и tbl2:
CREATE ROUTINE LOAD example_db.test1
FROM KAFKA
(
    "kafka_broker_list" = "broker1:9092,broker2:9092,broker3:9092",
    "kafka_topic" = "my_topic",
    "property.kafka_default_offsets" = "OFFSET_BEGINNING"
);
В этом случае данные в Kafka должны содержать имя таблицы. В настоящее время динамическое имя таблицы можно извлечь только из Kafka Value, и данные должны соответствовать следующему формату. Для JSON: table_name|{"col1": "val1", "col2": "val2"}, где tbl_name — имя таблицы, а | — разделитель между именем таблицы и её данными. Для CSV используется аналогичный формат, например: table_name|val1,val2,val3.
Указанное здесь table_name должно точно совпадать с именем таблицы в Doris, иначе загрузка завершится ошибкой. При динамическом выборе таблицы column_mapping не поддерживается.
Загрузка в строгом режиме
Создайте задачу Routine Load для Kafka с именем test1 для таблицы example_tbl в базе данных example_db, включив строгий режим:
CREATE ROUTINE LOAD example_db.test1 ON example_tbl
COLUMNS(k1, k2, k3, v1, v2, v3 = k1 * 100),
PRECEDING FILTER k1 = 1,
WHERE k1 < 100 and k2 like "%doris%"
PROPERTIES
(
    "strict_mode" = "true"
)
FROM KAFKA
(
    "kafka_broker_list" = "broker1:9092,broker2:9092,broker3:9092",
    "kafka_topic" = "my_topic"
);
Часто задаваемые вопросы (FAQ)
Что делать, если задание Routine Load автоматически переходит в состояние PAUSED?
Обычно это вызвано проблемами с качеством данных или ошибками на стороне Kafka:
- Выполните
SHOW ROUTINE LOAD FOR <job_name>, чтобы просмотретьReasonOfStateChangedиErrorLogUrls. - При наличии некорректных данных при необходимости увеличьте
max_filter_ratioиmax_error_number. - При ошибках Kafka убедитесь, что брокер и топик доступны, затем выполните
RESUME ROUTINE LOADдля восстановления работы.
Как устранить ошибку Offset out of range или out of range?
Обычно это означает, что данные по сохранённому смещению уже удалены из Kafka (по истечении срока хранения):
- Приостановите задание:
PAUSE ROUTINE LOAD FOR <job_name>. - С помощью
ALTER ROUTINE LOADзадайте дляkafka_offsetsдопустимую позицию (например,OFFSET_BEGINNINGили конкретное смещение). - Выполните
RESUME ROUTINE LOAD, чтобы возобновить задание.
Что делать при ошибке Server kafka/xxx@EXAMPLE.COM not found in Kerberos database?
При использовании аутентификации Kerberos задайте rdnbs=true в krb5.conf.
Что делать при ошибке Server certificate verification failed или других ошибках SSL?
Если на стороне BE не настроен доверенный сертификат CA, задайте "property.enable.ssl.certificate.verification" = "false" или явно укажите "property.ssl.ca.location" = "/path/to/ca-cert.pem".
Почему желаемый параллелизм (desired_concurrent_number) не применяется?
Фактический параллелизм определяется минимальным из следующих трёх значений:
min(topic_partition_num, desired_concurrent_number, max_routine_load_task_concurrent_num)
Проверьте количество партиций топика Kafka и параметр конфигурации FE max_routine_load_task_concurrent_num.
Как использовать старую версию Kafka (< 0.10.0.0)?
Задайте kafka_broker_version_fallback в конфигурации BE или укажите совместимую версию с помощью property.broker.version.fallback при создании задания.
Как указать целевую таблицу при загрузке из одного потока в несколько таблиц?
Значение Value сообщения Kafka должно содержать имя таблицы в формате table_name|<data>, причём имя должно точно совпадать с именем таблицы в Doris. При динамическом выборе таблицы column_mapping не поддерживается.
Как просмотреть некорректные данные, которые не удалось загрузить?
Выполните SHOW ROUTINE LOAD FOR <job_name> и проверьте поле ErrorLogUrls в результате. Откройте этот URL в браузере или с помощью wget, чтобы получить пример отфильтрованных ошибочных данных и узнать причину ошибки.
Нужно ли приостанавливать задание Routine Load перед изменением?
Да. Для выполнения команды ALTER ROUTINE LOAD задание должно находиться в состоянии PAUSED. Последовательность изменения: PAUSE ROUTINE LOAD -> ALTER ROUTINE LOAD -> RESUME ROUTINE LOAD.
Дополнительная помощь
- Справочник SQL: CREATE ROUTINE LOAD
- Для получения дополнительной справки выполните
HELP ROUTINE LOADв командной строке клиента.