Stream Load
Stream Load поддерживает импорт локальных файлов или потоков данных в Doris по HTTP. Stream Load работает синхронно: результат возвращается после выполнения импорта, поэтому по ответу можно определить, завершился ли импорт успешно. Как правило, Stream Load используют для импорта файлов размером менее 10 GB. Более крупные файлы сначала разделите на части, а затем импортируйте каждую часть с помощью Stream Load. Stream Load гарантирует атомарность пакета задач импорта: либо все строки импортируются успешно, либо не импортируется ни одна.
Для параллельного импорта рекомендуется использовать специализированный инструмент Doris Streamloader. В отличие от импорта в один поток с помощью curl, этот клиентский инструмент для импорта данных в Doris обеспечивает параллельный импорт и сокращает время загрузки больших объёмов данных. Инструкции и практические рекомендации см. в документации Doris Streamloader.
Сценарии использования
Stream Load подходит для следующих типичных сценариев:
- Импорт локальных или удалённых файлов CSV, JSON, Parquet или ORC в Doris.
- Непрерывная запись данных из программ на Java, Go, Python и других языках через потоки HTTP.
- Случаи, когда требуется атомарность отдельного задания импорта: либо все строки импортируются успешно, либо всё задание завершается ошибкой.
- Импорт отдельных файлов, размер которых обычно составляет менее 10 GB. Более крупные файлы разделите перед импортом или используйте Doris Streamloader.
При импорте файлов CSV чётко различайте значения null и пустые строки:
- Значение null (null): обозначается как
\N. Например,a,\N,bозначает, что средний столбец содержит null. - Пустая строка: если между двумя разделителями нет символов, значение представляет собой пустую строку. Например, в
a,,bмежду двумя запятыми нет символов, поэтому средний столбец содержит пустую строку.
Основные принципы
При использовании Stream Load задание импорта отправляется на узел FE по HTTP. Для балансировки нагрузки FE перенаправляет запросы на узлы BE по круговому алгоритму. HTTP-запрос также можно отправить напрямую на определённый узел BE. В Stream Load Doris назначает один из узлов координатором (Coordinator). Узел Coordinator отвечает за приём данных и их распределение между другими узлами.
На следующей схеме показан основной процесс работы Stream Load:
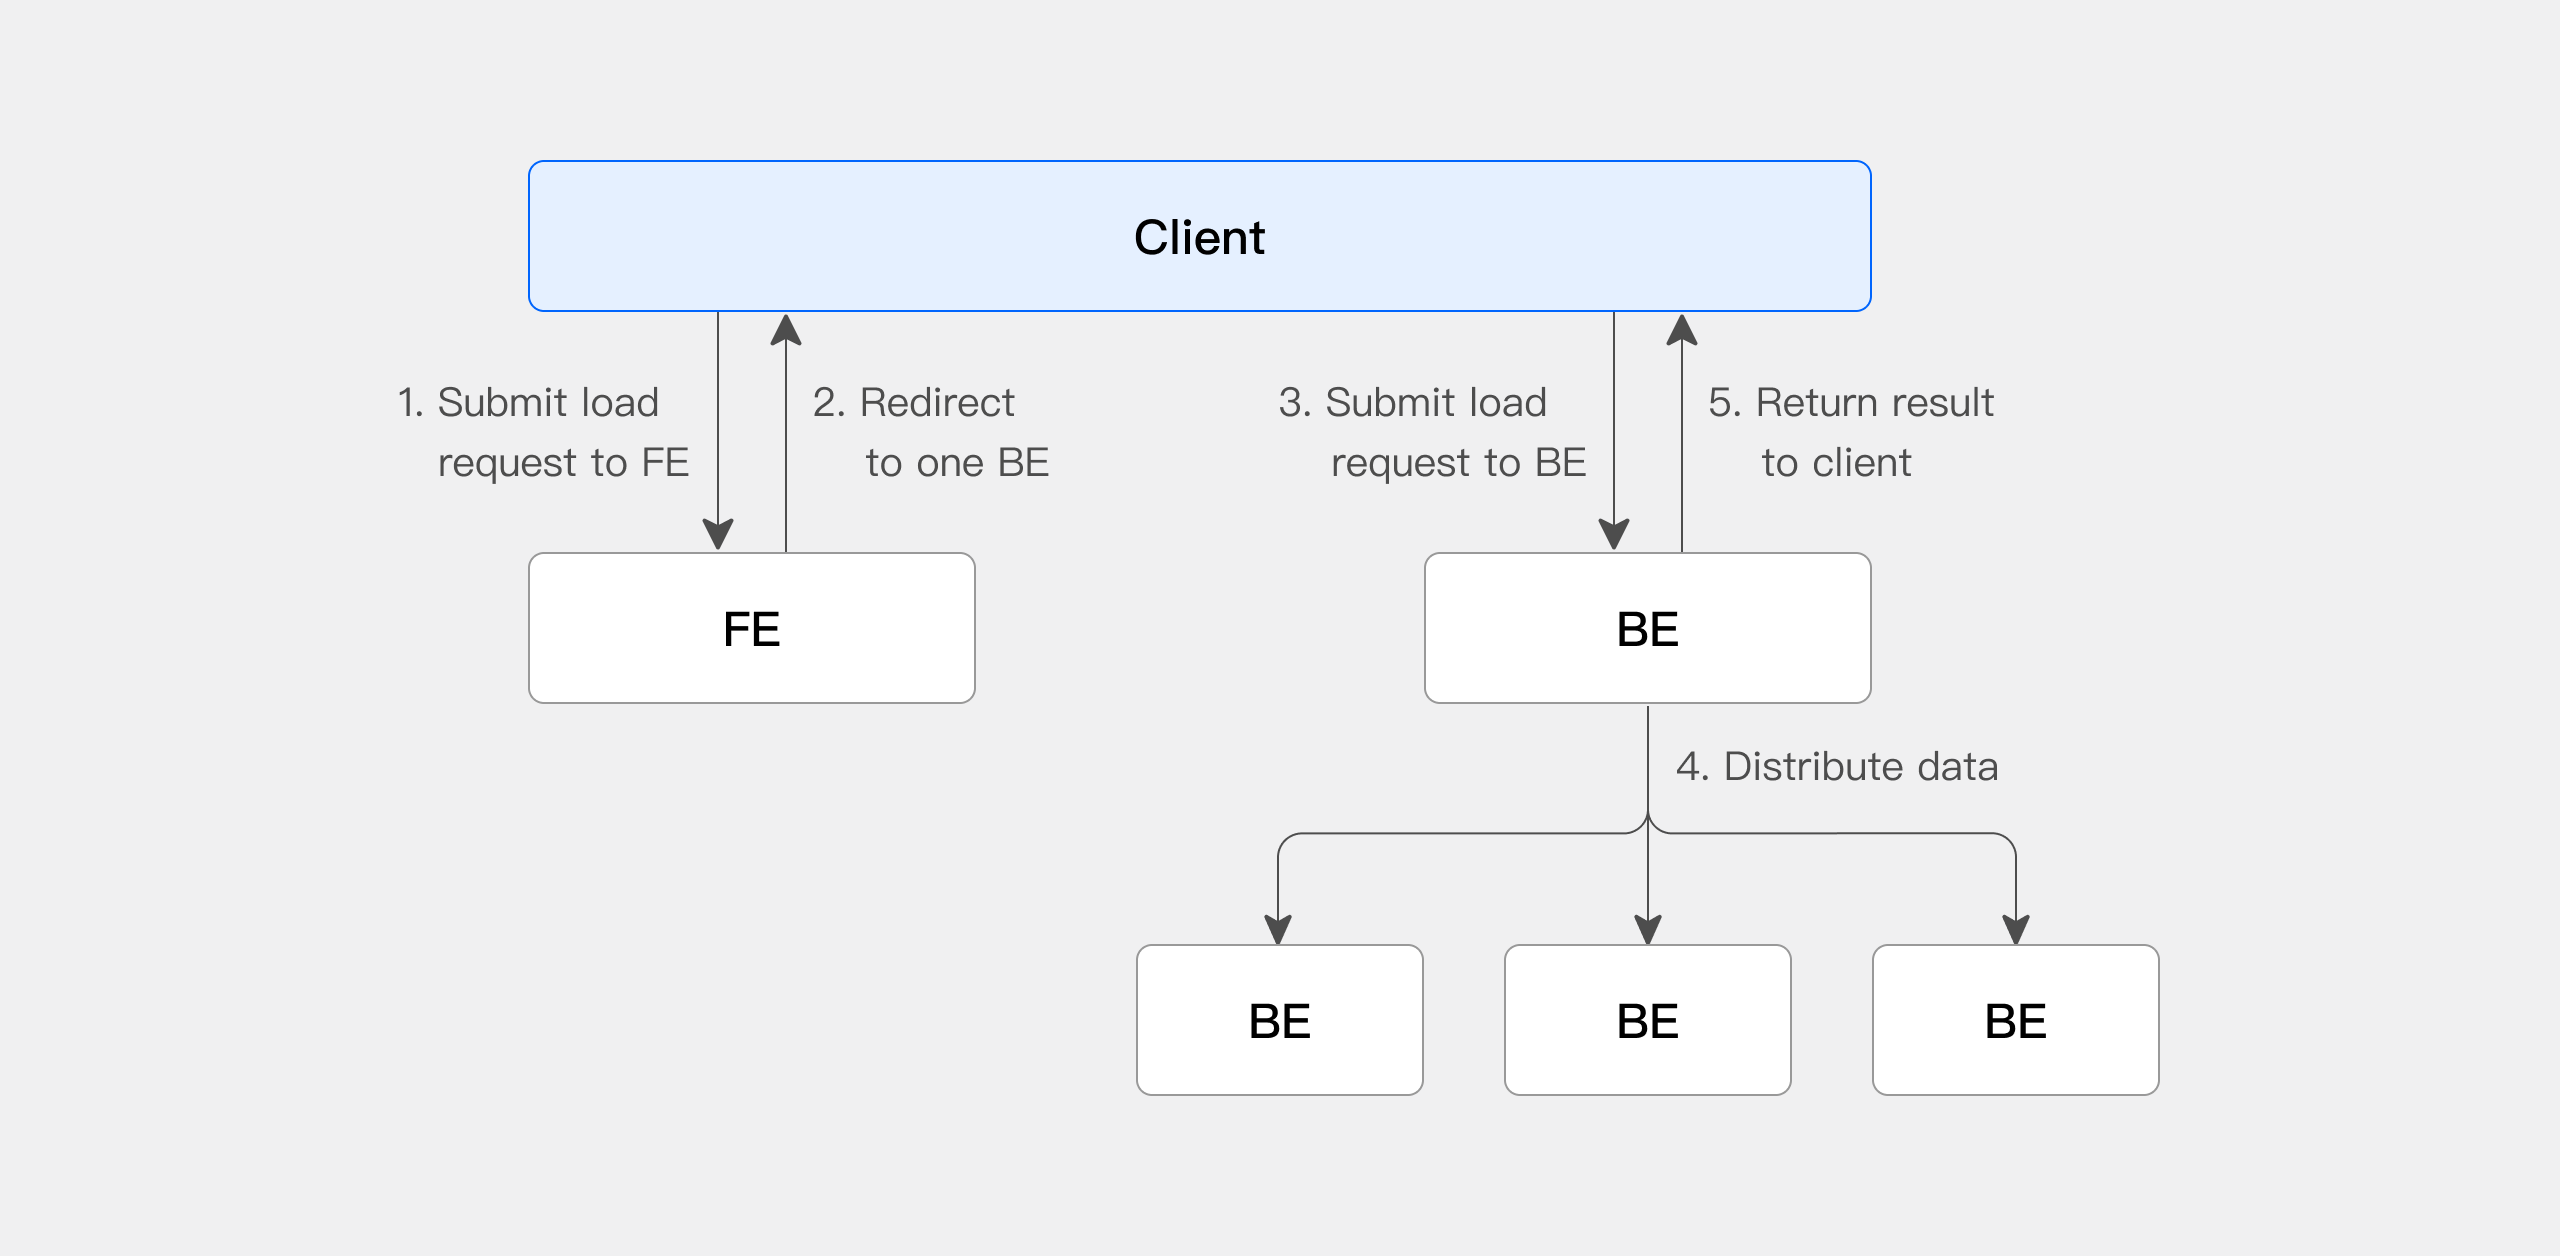
Выполнение происходит следующим образом:
- Клиент отправляет запрос на выполнение задания импорта Stream Load на FE.
- FE по круговому алгоритму выбирает BE в качестве узла Coordinator, отвечающего за планирование задания импорта, и возвращает клиенту перенаправление HTTP.
- Клиент подключается к узлу BE, назначенному Coordinator, и отправляет запрос на импорт.
- BE Coordinator распределяет данные между соответствующими узлами BE. После завершения импорта он возвращает клиенту результат.
- Клиент также может напрямую назначить узел BE координатором, чтобы тот распределил задание импорта.
Быстрый старт
Запросы Stream Load и данные передаются по HTTP. В следующих примерах с помощью инструмента curl показано, как отправить задание импорта через Stream Load.
Предварительные требования
Для Stream Load требуется привилегия INSERT на целевую таблицу. Если у пользователя нет привилегии INSERT, предоставьте её с помощью команды GRANT.
Создание задания импорта
Импорт данных CSV
-
Подготовьте данные для импорта
Создайте файл CSV
streamload_example.csvсо следующим содержимым:1,Emily,25
2,Benjamin,35
3,Olivia,28
4,Alexander,60
5,Ava,17
6,William,69
7,Sophia,32
8,James,64
9,Emma,37
10,Liam,64 -
Создайте целевую таблицу Doris
Создайте таблицу для импорта в Doris с помощью следующего оператора:
CREATE TABLE testdb.test_streamload(
    user_id            BIGINT       NOT NULL COMMENT "user id",
    name               VARCHAR(20)           COMMENT "name",
    age                INT                   COMMENT "age"
)
DUPLICATE KEY(user_id)
DISTRIBUTED BY HASH(user_id) BUCKETS 10; -
Запустите задание импорта
Задание импорта Stream Load можно отправить с помощью команды
curl.curl --location-trusted -u <doris_user>:<doris_password> \
-H "Expect:100-continue" \
-H "column_separator:," \
-H "columns:user_id,name,age" \
-T streamload_example.csv \
-XPUT http://<fe_ip>:<fe_http_port>/api/testdb/test_streamload/_stream_loadStream Load работает синхронно, поэтому результат импорта возвращается непосредственно пользователю.
{
    "TxnId": 3,
    "Label": "123",
    "Comment": "",
    "TwoPhaseCommit": "false",
    "Status": "Success",
    "Message": "OK",
    "NumberTotalRows": 10,
    "NumberLoadedRows": 10,
    "NumberFilteredRows": 0,
    "NumberUnselectedRows": 0,
    "LoadBytes": 118,
    "LoadTimeMs": 173,
    "BeginTxnTimeMs": 1,
    "StreamLoadPutTimeMs": 70,
    "ReadDataTimeMs": 2,
    "WriteDataTimeMs": 48,
    "CommitAndPublishTimeMs": 52
} -
Просмотрите импортированные данные
mysql> select count(*) from testdb.test_streamload;
+----------+
| count(*) |
+----------+
|       10 |
+----------+
Импорт данных JSON
-
Подготовьте данные для импорта
Создайте файл JSON
streamload_example.jsonсо следующим содержимым:[
{"userid":1,"username":"Emily","userage":25},
{"userid":2,"username":"Benjamin","userage":35},
{"userid":3,"username":"Olivia","userage":28},
{"userid":4,"username":"Alexander","userage":60},
{"userid":5,"username":"Ava","userage":17},
{"userid":6,"username":"William","userage":69},
{"userid":7,"username":"Sophia","userage":32},
{"userid":8,"username":"James","userage":64},
{"userid":9,"username":"Emma","userage":37},
{"userid":10,"username":"Liam","userage":64}
] -
Создайте целевую таблицу Doris
Создайте таблицу для импорта в Doris с помощью следующего оператора:
CREATE TABLE testdb.test_streamload(
    user_id            BIGINT       NOT NULL COMMENT "user id",
    name               VARCHAR(20)           COMMENT "name",
    age                INT                   COMMENT "age"
)
DUPLICATE KEY(user_id)
DISTRIBUTED BY HASH(user_id) BUCKETS 10; -
Запустите задание импорта
Задание импорта Stream Load можно отправить с помощью команды
curl.curl --location-trusted -u <doris_user>:<doris_password> \
-H "label:124" \
-H "Expect:100-continue" \
-H "format:json" -H "strip_outer_array:true" \
-H "jsonpaths:[\"$.userid\", \"$.username\", \"$.userage\"]" \
-H "columns:user_id,name,age" \
-T streamload_example.json \
-XPUT http://<fe_ip>:<fe_http_port>/api/testdb/test_streamload/_stream_loadПримечаниеЕсли файл JSON содержит не массив JSON, а по одному объекту JSON в каждой строке, добавьте заголовки
-H "strip_outer_array:false"и-H "read_json_by_line:true". Для импорта объекта JSON из корневого узла файла JSON задайте дляjsonpathsзначение$., например:-H "jsonpaths:[\"$.\"]".Stream Load работает синхронно, поэтому результат импорта возвращается непосредственно пользователю.
{
    "TxnId": 7,
    "Label": "125",
    "Comment": "",
    "TwoPhaseCommit": "false",
    "Status": "Success",
    "Message": "OK",
    "NumberTotalRows": 10,
    "NumberLoadedRows": 10,
    "NumberFilteredRows": 0,
    "NumberUnselectedRows": 0,
    "LoadBytes": 471,
    "LoadTimeMs": 52,
    "BeginTxnTimeMs": 0,
    "StreamLoadPutTimeMs": 11,
    "ReadDataTimeMs": 0,
    "WriteDataTimeMs": 23,
    "CommitAndPublishTimeMs": 16
}
Просмотр заданий импорта
По умолчанию Stream Load возвращает результат клиенту синхронно, поэтому система не сохраняет историю заданий Stream Load. Чтобы включить её сохранение, добавьте настройку enable_stream_load_record=true в be.conf. Подробнее см. в разделе Конфигурация BE.
После настройки завершённые задачи Stream Load можно просматривать с помощью команды show stream load.
mysql> show stream load from testdb;
+-------+--------+-----------------+---------------+---------+---------+------+-----------+------------+--------------+----------------+-----------+-------------------------+-------------------------+------+---------+
| Label | Db     | Table           | ClientIp      | Status  | Message | Url  | TotalRows | LoadedRows | FilteredRows | UnselectedRows | LoadBytes | StartTime               | FinishTime              | User | Comment |
+-------+--------+-----------------+---------------+---------+---------+------+-----------+------------+--------------+----------------+-----------+-------------------------+-------------------------+------+---------+
| 12356 | testdb | test_streamload | 192.168.88.31 | Success | OK      | N/A  | 10        | 10         | 0            | 0              | 118       | 2023-11-29 08:53:00.594 | 2023-11-29 08:53:00.650 | root |         |
+-------+--------+-----------------+---------------+---------+---------+------+-----------+------------+--------------+----------------+-----------+-------------------------+-------------------------+------+---------+
1 row in set (0.00 sec)
Отмена задания импорта
Пользователи не могут отменить Stream Load вручную. Система автоматически отменяет Stream Load при истечении времени ожидания или возникновении ошибки импорта.
Привязка Compute Group
Вы можете указать Compute Group, в которой выполняется Stream Load.
Режим разделения хранения и вычислений
В режиме разделения хранения и вычислений Compute Group можно указать следующими способами:
-
Через параметр заголовка HTTP.
-H "cloud_cluster:cluster1"Начиная с Doris 4.0.0 также можно использовать параметр
compute_group:-H "compute_group:cluster1"Если заданы и
compute_group, иcloud_cluster, приоритет имеетcompute_group. -
Указать Compute Group в свойствах пользователя, от имени которого выполняется Stream Load. Если Compute Group указана и в свойствах пользователя, и в заголовке HTTP, приоритет имеет значение из заголовка.
set property for user1 'default_compute_group'='cluster1'; -
Если Compute Group не указана ни в свойствах пользователя, ни в заголовке HTTP, она выбирается из Compute Group, доступных пользователю, от имени которого выполняется Stream Load. Если у пользователя нет доступных Compute Group, импорт завершается ошибкой.
В Doris 4.0.8 и более поздних версиях ветки 4.0, а также в Doris 4.1.4 и более поздних версиях ветки 4.1 устранено несоответствие между маршрутизацией Compute Group и планом выполнения Stream Load в режиме разделения хранения и вычислений:
- Заголовок
compute_groupимеет приоритет надcloud_cluster. Ранее FE распознавал толькоcloud_cluster. - При построении плана выполнения используется Compute Group узла BE, который фактически получает запрос, поэтому план больше не назначается другой Compute Group, отличной от той, где он выполняется.
- В этом процессе также проверяются права учётной записи, выполняющей загрузку, на доступ к целевой Compute Group, существование Compute Group и её состояние. Поэтому, если у учётной записи нет доступа к Compute Group, фактически обслуживающей запрос, после обновления загрузка завершится ошибкой прав доступа. Учётной записи необходимо предоставить соответствующие права.
Начиная с версии 4.1.4 конечные точки Stream Load на BE (PUT /api/{db}/{table}/_stream_load, PUT /api/_http_stream и PUT /api/{db}/_stream_load_2pc) больше не выполняют предварительную проверку глобальной привилегии LOAD. Проверка прав доступа выполняется единообразно на FE для базы данных и таблицы, в которые фактически записываются данные.
В результате учётная запись, имеющая только LOAD_PRIV на уровне базы данных или таблицы (без глобальной привилегии LOAD), теперь может выполнять Stream Load, а также фиксацию и отмену 2PC.
Режим совмещённого хранения и вычислений
В режиме совмещённого хранения и вычислений указать Compute Group можно только в свойствах пользователя, от имени которого выполняется Stream Load. Если Compute Group в свойствах пользователя не указана, выбирается Compute Group с именем default.
set property for user1 'resource_tags.location'='group_1';
Справочная информация
Команда импорта
Синтаксис импорта Stream Load:
curl --location-trusted -u <doris_user>:<doris_password> \
  -H "Expect:100-continue" [-H ""...] \
  -T <file_path> \
  -XPUT http://fe_host:http_port/api/{db}/{table}/_stream_load
Stream Load поддерживает импорт по HTTP как с передачей данных по частям (chunked), так и без неё. При импорте без передачи по частям необходимо указать Content-Length, задающий длину загружаемого содержимого, что обеспечивает целостность данных.
Параметры настройки импорта
Конфигурация FE
1. stream_load_default_timeout_second
| Параметр | Описание |
|---|---|
| Значение по умолчанию | 259200 (с) |
| Динамическая настройка | Да |
| Настройка только для FE Master | Да |
Описание: время ожидания Stream Load по умолчанию. Определяет время ожидания задачи импорта в секундах. Если задача импорта не завершится за время, заданное параметром timeout, система отменит её, и задача перейдёт в состояние CANCELLED. Если исходный файл не удаётся импортировать за указанное время, можно задать отдельное время ожидания в запросе Stream Load или изменить параметр FE stream_load_default_timeout_second, чтобы установить глобальное значение по умолчанию.
Конфигурация BE
1. streaming_load_max_mb
| Параметр | Описание |
|---|---|
| Значение по умолчанию | 10240 (MB) |
| Динамическая настройка | Да |
Описание: максимальный размер импорта Stream Load. Если размер исходного файла пользователя превышает это значение, измените параметр BE streaming_load_max_mb.
Параметры заголовка
Параметры импорта можно передавать через заголовки HTTP. Ниже приведено их описание:
| Параметр | Описание параметра |
|---|---|
| label | Задаёт метку для этого импорта. Данные с одной и той же меткой нельзя импортировать более одного раза. Если метка не указана, Doris создаёт её автоматически. Указание метки позволяет избежать повторного импорта одних и тех же данных. По умолчанию Doris хранит метки заданий импорта в течение трёх дней; срок хранения можно изменить с помощью label_keep_max_second. Например, чтобы задать для этого импорта метку 123, используйте команду -H "label:123". Метки предотвращают повторный импорт одних и тех же данных. Настоятельно рекомендуется использовать одну и ту же метку для одного пакета данных, чтобы повторные запросы для этого пакета принимались только один раз, обеспечивая семантику At-Most-Once. Если задание импорта с данной меткой находится в состоянии CANCELLED, метку можно использовать повторно. |
| column_separator | Задаёт разделитель столбцов в импортируемом файле. Значение по умолчанию: \t. Для непечатаемых символов используйте префикс \x и задавайте разделитель в шестнадцатеричном виде. В качестве разделителя столбцов также можно использовать сочетание нескольких символов. Например, разделитель файлов Hive \x01 задаётся командой -H "column_separator:\x01". |
| line_delimiter | Задаёт разделитель строк в импортируемом файле. Значение по умолчанию: \n. В качестве разделителя строк также можно использовать сочетание нескольких символов. Например, чтобы задать разделитель строк \n, используйте команду -H "line_delimiter:\n". |
| columns | Задаёт соответствие между столбцами импортируемого файла и столбцами таблицы. Если столбцы исходного файла полностью соответствуют столбцам таблицы, это поле можно не указывать. Если исходный файл не соответствует схеме таблицы, это поле необходимо для преобразования данных. Столбец можно задать двумя способами: напрямую указать имя поля импортируемого файла или определить вычисляемый столбец с помощью синтаксиса column_name = expression. Подробные примеры см. в разделе Преобразование данных при импорте. |
| where | Используется для извлечения части данных. Если нужно отфильтровать ненужные данные, используйте этот параметр. Например, чтобы импортировать только данные, у которых столбец k1 равен 20180601, укажите при импорте -H "where: k1 = 20180601". |
| max_filter_ratio | Максимально допустимая доля данных, которые могут быть отфильтрованы, например из-за некорректного формата. По умолчанию ошибки не допускаются. Диапазон значений: от 0 до 1. Если доля ошибок импорта превышает это значение, импорт завершается ошибкой. Строки, отфильтрованные условием where, не считаются некорректными данными. Например, чтобы импортировать все корректные данные с максимально возможным допуском ошибок (100%), укажите команду -H "max_filter_ratio:1". |
| partitions | Задаёт разделы, участвующие в этом импорте. Если можно определить, каким разделам соответствуют данные, рекомендуется указать этот параметр. Данные, не соответствующие указанным разделам, отфильтровываются. Например, для импорта в разделы p1 и p2 укажите команду -H "partitions: p1, p2". |
| timeout | Задаёт время ожидания импорта в секундах. Значение по умолчанию: 600 секунд. Допустимый диапазон: от 1 секунды до 259200 секунд. Например, чтобы установить время ожидания импорта 1200 с, укажите команду -H "timeout:1200". |
| strict_mode | Определяет, включён ли строгий режим для этого импорта. По умолчанию он отключён. Например, чтобы включить строгий режим, укажите команду -H "strict_mode:true". |
| timezone | Задаёт часовой пояс для этого импорта. По умолчанию используется текущий часовой пояс кластера. Этот параметр влияет на результаты всех функций, связанных с часовыми поясами и используемых при импорте. Например, чтобы задать часовой пояс импорта Africa/Abidjan, укажите команду -H "timezone:Africa/Abidjan". |
| exec_mem_limit | Ограничение памяти для импорта. Значение по умолчанию: 2 GB. Единица измерения: байты. |
| format | Задаёт формат данных для этого импорта. Значение по умолчанию: CSV. В настоящее время поддерживаются следующие форматы: CSV, JSON, arrow, csv_with_names (позволяет пропустить первую строку файла CSV), csv_with_names_and_types (позволяет пропустить первые две строки файла CSV), Parquet и ORC. Например, чтобы задать формат импортируемых данных JSON, используйте команду -H "format:json". |
| jsonpaths | Существует два способа импорта данных JSON: простой режим, который используется, когда jsonpaths не указан, и требует, чтобы данные JSON имели тип объекта; и режим сопоставления, который используется для более сложных данных JSON, когда соответствующие значения нужно сопоставить с помощью параметра jsonpaths. В простом режиме ключи JSON должны однозначно соответствовать именам столбцов таблицы. Например, для данных JSON {"k1":1, "k2":2, "k3":"hello"} ключи k1, k2 и k3 должны соответствовать столбцам таблицы. |
| strip_outer_array | Если для strip_outer_array задано значение true, данные JSON начинаются с массива, который разворачивается в отдельные записи. Значение по умолчанию: false. Если внешний уровень данных JSON представляет собой массив, обозначенный как [], установите strip_outer_array в true. Например, для данных [{"k1" : 1, "v1" : 2},{"k1" : 3, "v1" : 4}] после установки strip_outer_array в true при импорте в Doris будут созданы две строки. |
| json_root | json_root представляет собой допустимую строку jsonpath, задающую корневой узел документа JSON. Значение по умолчанию: "". |
| merge_type | Тип слияния данных. Поддерживаются три типа: - APPEND (по умолчанию): все данные этого пакета добавляются к существующим данным. - DELETE: удаляет все строки, ключи которых совпадают с ключами в этом пакете. - MERGE: должен использоваться вместе с условием delete. Данные, соответствующие условию delete, обрабатываются по семантике DELETE, остальные данные обрабатываются по семантике APPEND.Например, чтобы задать режим MERGE: -H "merge_type: MERGE" -H "delete: flag=1". |
| delete | Имеет смысл только при использовании MERGE; задаёт условие удаления данных. |
| function_column.sequence_col | Применяется только к модели UNIQUE KEYS. Для строк с одинаковыми значениями ключевых столбцов обеспечивает замену значений столбцов с помощью REPLACE в порядке, заданном столбцом source_sequence. source_sequence может быть столбцом источника данных или столбцом схемы таблицы. |
| fuzzy_parse | Логическое значение. Если задано true, JSON разбирается с использованием первой строки в качестве схемы. Включение этого параметра может повысить эффективность импорта JSON, но требует, чтобы порядок ключей во всех объектах JSON совпадал с порядком в первой строке. Значение по умолчанию: false. Используется только для формата JSON. |
| num_as_string | Логическое значение. Если задано true, при разборе данных JSON числовые типы преобразуются в строки, что обеспечивает импорт без потери точности. |
| read_json_by_line | Логическое значение. Если задано true, поддерживается чтение по одному объекту JSON в каждой строке. Значение по умолчанию: false. |
| send_batch_parallelism | Целое число. Задаёт степень параллелизма отправки пакетов данных. Если это значение превышает параметр конфигурации BE max_send_batch_parallelism_per_job, узел BE, выполняющий роль координатора, использует значение max_send_batch_parallelism_per_job. |
| hidden_columns | Задаёт скрытые столбцы, включённые в импортируемые данные. Действует, когда в заголовке не указан Columns. Несколько скрытых столбцов разделяются запятыми. Система импортирует данные с учётом указанных пользователем столбцов. В приведённом ниже примере последний столбец импортируемых данных: __DORIS_SEQUENCE_COL__. hidden_columns: __DORIS_DELETE_SIGN__,__DORIS_SEQUENCE_COL__ |
| load_to_single_tablet | Логическое значение. Если задано true, данные одной задачи можно загрузить только в один tablet соответствующего раздела. Значение по умолчанию: false. Этот параметр можно задать только при загрузке данных в таблицу OLAP со случайным распределением по бакетам. |
| compress_type | Задаёт формат сжатия файла. В настоящее время поддерживается только сжатие файлов CSV. Поддерживаемые форматы сжатия: gz, lzo, bz2, lz4, lzop и deflate. |
| trim_double_quotes | Логическое значение. Значение по умолчанию: false. Если задано true, удаляет внешние двойные кавычки у каждого поля файла CSV. |
| skip_lines | Целое число. Значение по умолчанию: 0. Пропускает несколько первых строк файла CSV. Этот параметр не действует, если для format задано значение csv_with_names или csv_with_names_and_types. |
| comment | Строка. По умолчанию значение пустое. Добавляет дополнительную информацию к задаче. |
| enclose | Задаёт символ обрамления. Если поля данных CSV содержат разделители строк или столбцов, можно указать однобайтовый символ обрамления, чтобы избежать непреднамеренного разбиения. Например, если разделитель столбцов ,, а символ обрамления ', то в данных "a,'b,c'" значение b,c будет распознано как одно поле. Примечание: если для enclose задано значение ", для trim_double_quotes необходимо установить true. |
| escape | Задаёт символ экранирования. Используется для экранирования символов в полях, совпадающих с символом обрамления. Например, для данных "a,'b,'c'" с символом обрамления ', чтобы распознать b,'c как одно поле, укажите однобайтовый символ экранирования, например \\, и измените данные на "a,'b,\\'c'". |
| memtable_on_sink_node | Определяет, включена ли функция MemTable forward при импорте данных. Значение по умолчанию: false. |
| unique_key_update_mode | Режим обновления таблицы Unique. В настоящее время действует только для таблиц Unique с Merge-On-Write. Поддерживаются три типа: UPSERT, UPDATE_FIXED_COLUMNS и UPDATE_FLEXIBLE_COLUMNS. UPSERT: импортирует данные с семантикой upsert. UPDATE_FIXED_COLUMNS: импортирует данные с помощью частичного обновления столбцов. UPDATE_FLEXIBLE_COLUMNS: импортирует данные с помощью гибкого частичного обновления столбцов. |
| partial_update_new_key_behavior | Способ обработки новых строк при частичном или гибком обновлении столбцов таблицы Unique. Доступны два типа: APPEND и ERROR.- APPEND: разрешает вставку новых строк.- ERROR: при вставке новой строки импорт завершается ошибкой с соответствующим сообщением. |
Результат импорта
Stream Load работает синхронно, и результат импорта возвращается пользователю в ответе на запрос импорта, как показано ниже:
{
    "TxnId": 1003,
    "Label": "b6f3bc78-0d2c-45d9-9e4c-faa0a0149bee",
    "Status": "Success",
    "ExistingJobStatus": "FINISHED", // optional
    "Message": "OK",
    "NumberTotalRows": 1000000,
    "NumberLoadedRows": 1000000,
    "NumberFilteredRows": 1,
    "NumberUnselectedRows": 0,
    "LoadBytes": 40888898,
    "LoadTimeMs": 2144,
    "BeginTxnTimeMs": 1,
    "StreamLoadPutTimeMs": 2,
    "ReadDataTimeMs": 325,
    "WriteDataTimeMs": 1933,
    "CommitAndPublishTimeMs": 106,
    "ErrorURL": "http://192.168.1.1:8042/api/_load_error_log?file=__shard_0/error_log_insert_stmt_db18266d4d9b4ee5-abb00ddd64bdf005_db18266d4d9b4ee5_abb00ddd64bdf005"
}
Параметры возвращаемого результата описаны в следующей таблице:
| Имя параметра | Описание |
|---|---|
| TxnId | Идентификатор транзакции импорта. |
| Label | Метка задания импорта, заданная с помощью -H "label:<label_id>". |
| Status | Итоговое состояние импорта: - Success: импорт завершён успешно. - Publish Timeout: импорт завершён, но данные могут стать видимыми с задержкой; повторять импорт не требуется. - Label Already Exists: метка уже существует; нужна новая метка. - Fail: импорт завершился ошибкой. |
| ExistingJobStatus | Состояние существующего задания импорта с этой меткой. Это поле отображается, только когда Status имеет значение Label Already Exists. По нему можно определить состояние задания импорта с уже существующей меткой. RUNNING означает, что задание ещё выполняется; FINISHED означает, что задание завершилось успешно. |
| Message | Сообщение об ошибке импорта. |
| NumberTotalRows | Общее число строк, обработанных при импорте. |
| NumberLoadedRows | Число успешно импортированных строк. |
| NumberFilteredRows | Число строк, не прошедших проверку качества данных. |
| NumberUnselectedRows | Число строк, отфильтрованных условием where. |
| LoadBytes | Число импортированных байтов. |
| LoadTimeMs | Длительность импорта в миллисекундах. |
| BeginTxnTimeMs | Время запроса к FE на начало транзакции в миллисекундах. |
| StreamLoadPutTimeMs | Время запроса к FE на получение плана выполнения импорта данных в миллисекундах. |
| ReadDataTimeMs | Время чтения данных в миллисекундах. |
| WriteDataTimeMs | Время записи данных в миллисекундах. |
| CommitAndPublishTimeMs | Время запроса к FE на фиксацию и публикацию транзакции в миллисекундах. |
| ErrorURL | При наличии проблем с качеством данных по этому URL можно просмотреть конкретные строки с ошибками. |
С помощью ErrorURL можно просмотреть импортируемые данные, которые не прошли проверку качества. Используйте команду curl "<ErrorURL>", чтобы напрямую просмотреть информацию об ошибочных данных.
Примеры импорта
Настройка времени ожидания и максимального размера импорта
Время ожидания задачи импорта задаётся в секундах. Если задача импорта не завершится за время, заданное параметром timeout, система отменит её, и задача перейдёт в состояние CANCELLED. Изменить время ожидания импорта Stream Load можно с помощью параметра timeout или путём добавления параметра stream_load_default_timeout_second в fe.conf.
Перед импортом рассчитайте время ожидания исходя из размера файла. Например, для файла размером 100 GB при предполагаемой скорости импорта 50 MB/s:
Import time ~= 100GB / 50MB/s ~= 2048s
Следующая команда создаёт задачу импорта Stream Load, в которой для timeout задано значение 3000 с:
curl --location-trusted -u <doris_user>:<doris_password> \
    -H "Expect:100-continue" \
    -H "timeout:3000" \
    -H "column_separator:," \
    -H "columns:user_id,name,age" \
    -T streamload_example.csv \
    -XPUT http://<fe_ip>:<fe_http_port>/api/testdb/test_streamload/_stream_load
Настройка максимально допустимой доли ошибок
Задачи импорта Doris могут допускать некоторую долю некорректных данных. Допустимая доля задаётся параметром max_filter_ratio. Значение по умолчанию: 0, то есть даже одна строка с некорректными данными приводит к ошибке всей задачи импорта. Чтобы пропустить часть проблемных строк, задайте для этого параметра значение от 0 до 1, и Doris автоматически пропустит строки с некорректным форматом данных. Подробнее о расчёте допустимой доли см. в документации Преобразование данных.
Следующая команда создаёт задачу импорта Stream Load, в которой для max_filter_ratio задано значение 0.4:
curl --location-trusted -u <doris_user>:<doris_password> \
    -H "Expect:100-continue" \
    -H "max_filter_ratio:0.4" \
    -H "column_separator:," \
    -H "columns:user_id,name,age" \
    -T streamload_example.csv \
    -XPUT http://<fe_ip>:<fe_http_port>/api/testdb/test_streamload/_stream_load
Настройка условий фильтрации при импорте
Во время импорта можно использовать параметр WHERE для фильтрации импортируемых данных по условию. Отфильтрованные данные не учитываются при расчёте доли ошибок и не влияют на настройку max_filter_ratio. После завершения импорта число отфильтрованных строк можно узнать из num_rows_unselected.
Следующая команда создаёт задачу импорта Stream Load с условием фильтрации WHERE:
curl --location-trusted -u <doris_user>:<doris_password> \
    -H "Expect:100-continue" \
    -H "where:age>=35" \
    -H "column_separator:," \
    -H "columns:user_id,name,age" \
    -T streamload_example.csv \
    -XPUT http://<fe_ip>:<fe_http_port>/api/testdb/test_streamload/_stream_load
Импорт данных в указанные разделы
Импорт данных из локального файла в разделы p1 и p2 таблицы с допустимой долей ошибок 20%.
curl --location-trusted -u <doris_user>:<doris_password> \
    -H "label:123" \
    -H "Expect:100-continue" \
    -H "max_filter_ratio:0.2" \
    -H "column_separator:," \
    -H "columns:user_id,name,age" \
    -H "partitions: p1, p2" \
    -T streamload_example.csv \
    -XPUT http://<fe_ip>:<fe_http_port>/api/testdb/test_streamload/_stream_load
Указание часового пояса импорта
Типы без часового пояса, такие как DATETIME и TIMESTAMP_NS, не содержат сведений о часовом поясе, и хранимые в них значения не меняются при изменении системного часового пояса Doris. Поэтому входные данные с часовым поясом при импорте преобразуются в указанный целевой часовой пояс, а затем сохраняются без часового пояса. В Doris целевой часовой пояс задаётся переменной сеанса time_zone.
При импорте целевой часовой пояс задаётся параметром timezone. Эта переменная заменяет переменную сеанса time_zone при преобразованиях часовых поясов и вычислении функций, зависящих от часового пояса. Поэтому, если нет особых требований, настройка timezone в транзакции импорта должна соответствовать текущему значению time_zone кластера Doris. Это означает, что все временные данные с часовыми поясами преобразуются в этот часовой пояс.
Например, если системный часовой пояс Doris равен +08:00, а столбец времени в импортируемых данных содержит две строки, 2012-01-01 01:00:00+00:00 и 2015-12-12 12:12:12-08:00, то указание -H "timezone: +08:00" для транзакции импорта преобразует обе строки в этот часовой пояс, и результатом будут 2012-01-01 09:00:00 и 2015-12-13 04:12:12.
Подробнее о часовых поясах см. в документации Часовой пояс.
Потоковый импорт
Stream Load работает по протоколу HTTP, поэтому программы на Java, Go и Python могут записывать в него данные в виде потока. Именно поэтому он называется Stream Load.
В следующем примере этот способ показан с помощью конвейера команд bash; импортируемые данные генерируются программой, а не читаются из локального файла.
seq 1 10 | awk '{OFS="\t"}{print $1, $1 * 10}' | curl --location-trusted -u root -T - http://host:port/api/testDb/testTbl/_stream_load
Пропуск первой строки CSV при импорте
Данные файла:
 id,name,age
 1,doris,20
 2,flink,10
Чтобы пропустить первую строку при импорте, укажите format=csv_with_names:
curl --location-trusted -u root -T test.csv -H "label:1" -H "format:csv_with_names" -H "column_separator:," http://host:port/api/testDb/testTbl/_stream_load
Использование merge_type для операции Delete
В Stream Load есть три типа импорта: APPEND, DELETE и MERGE. Их можно выбирать с помощью параметра merge_type. Чтобы удалить все строки, ключи которых совпадают с ключами импортируемых данных, используйте следующую команду:
curl --location-trusted -u <doris_user>:<doris_password> \
    -H "Expect:100-continue" \
    -H "merge_type: DELETE" \
    -H "column_separator:," \
    -H "columns:user_id,name,age" \
    -T streamload_example.csv \
    -XPUT http://<fe_ip>:<fe_http_port>/api/testdb/test_streamload/_stream_load
Если до импорта таблица содержит следующие данные:
+--------+----------+----------+------+
| siteid | citycode | username | pv   |
+--------+----------+----------+------+
|      3 |        2 | tom      |    2 |
|      4 |        3 | bush     |    3 |
|      5 |        3 | helen    |    3 |
+--------+----------+----------+------+
Импортируемые данные:
3,2,tom,0
После импорта соответствующая строка удаляется из таблицы, и набор результатов принимает следующий вид:
+--------+----------+----------+------+
| siteid | citycode | username | pv   |
+--------+----------+----------+------+
|      4 |        3 | bush     |    3 |
|      5 |        3 | helen    |    3 |
+--------+----------+----------+------+
Использование merge_type для операции Merge
Установка merge_type в MERGE объединяет импортируемые данные с данными таблицы. Семантика MERGE должна использоваться вместе с условием DELETE. Строки, соответствующие условию DELETE, обрабатываются по семантике DELETE, а остальные добавляются в таблицу по семантике APPEND. Например, следующая операция удаляет строку, у которой siteid равен 1, и добавляет остальные данные в таблицу:
curl --location-trusted -u <doris_user>:<doris_password> \
    -H "Expect:100-continue" \
    -H "merge_type: MERGE" \
    -H "delete: siteid=1" \
    -H "column_separator:," \
    -H "columns:user_id,name,age" \
    -T streamload_example.csv \
    -XPUT http://<fe_ip>:<fe_http_port>/api/testdb/test_streamload/_stream_load
Если до импорта данные выглядят так:
+--------+----------+----------+------+
| siteid | citycode | username | pv   |
+--------+----------+----------+------+
|      4 |        3 | bush     |    3 |
|      5 |        3 | helen    |    3 |
|      1 |        1 | jim      |    2 |
+--------+----------+----------+------+
Импортируемые данные:
2,1,grace,2
3,2,tom,2
1,1,jim,2
После импорта строка с siteid = 1 удаляется, а строки со значениями siteid 2 и 3 добавляются в таблицу:
+--------+----------+----------+------+
| siteid | citycode | username | pv   |
+--------+----------+----------+------+
|      4 |        3 | bush     |    3 |
|      2 |        1 | grace    |    2 |
|      3 |        2 | tom      |    2 |
|      5 |        3 | helen    |    3 |
+--------+----------+----------+------+
Указание столбца Sequence для Merge при импорте
Если в таблице Unique Key задан столбец Sequence, то для строк с одинаковыми значениями ключевых столбцов значение Sequence определяет порядок замены, выполняемой агрегатной функцией REPLACE: большее значение может заменить меньшее. При пометке строк для удаления в такой таблице с помощью DORIS_DELETE_SIGN необходимо обеспечить совпадение ключа и значение столбца Sequence, большее или равное текущему. Указав параметр function_column.sequence_col вместе с merge_type: DELETE, можно выполнить операцию удаления:
curl --location-trusted -u <doris_user>:<doris_password> \
    -H "Expect:100-continue" \
    -H "merge_type: DELETE" \
    -H "function_column.sequence_col: age" \
    -H "column_separator:," \
    -H "columns: name, gender, age" \
    -T streamload_example.csv \
    -XPUT http://<fe_ip>:<fe_http_port>/api/testdb/test_streamload/_stream_load
Предположим, таблица имеет следующую структуру:
mysql> SET show_hidden_columns=true;
Query OK, 0 rows affected (0.00 sec)

mysql> DESC table1;
+------------------------+--------------+------+-------+---------+---------+
| Field                  | Type         | Null | Key   | Default | Extra   |
+------------------------+--------------+------+-------+---------+---------+
| name                   | VARCHAR(100) | No   | true  | NULL    |         |
| gender                 | VARCHAR(10)  | Yes  | false | NULL    | REPLACE |
| age                    | INT          | Yes  | false | NULL    | REPLACE |
| __DORIS_DELETE_SIGN__  | TINYINT      | No   | false | 0       | REPLACE |
| __DORIS_SEQUENCE_COL__ | INT          | Yes  | false | NULL    | REPLACE |
+------------------------+--------------+------+-------+---------+---------+
4 rows in set (0.00 sec)
Предположим, исходная таблица содержит следующие данные:
+-------+--------+------+
| name  | gender | age  |
+-------+--------+------+
| li    | male   |   10 |
| wang  | male   |   14 |
| zhang | male   |   12 |
+-------+--------+------+
1. Параметр Sequence действует: импортируемое значение столбца Sequence больше или равно существующему значению в таблице
Импортируемые данные:
li,male,10
Поскольку указан function_column.sequence_col: age и значение age больше или равно существующему значению столбца в таблице, исходная строка удаляется, и данные в таблице принимают следующий вид:
+-------+--------+------+
| name  | gender | age  |
+-------+--------+------+
| wang  | male   |   14 |
| zhang | male   |   12 |
+-------+--------+------+
2. Параметр Sequence не действует: импортируемое значение столбца Sequence меньше или равно существующему значению в таблице
Импортируемые данные:
li,male,9
Поскольку указан function_column.sequence_col: age, но значение age меньше существующего значения столбца в таблице, операция DELETE не действует; данные в таблице не меняются, и строка с первичным ключом li остаётся видимой:
+-------+--------+------+
| name  | gender | age  |
+-------+--------+------+
| li    | male   |   10 |
| wang  | male   |   14 |
| zhang | male   |   12 |
+-------+--------+------+
Строка не удаляется, потому что во внутреннем порядке обработки система сначала проверяет строки с одинаковым ключом, выбирает для внешнего доступа строку с наибольшим значением столбца Sequence, а затем проверяет, равно ли значение DORIS_DELETE_SIGN этой строки 1. Если оно равно 1, строка скрывается от внешнего доступа; если оно равно 0, строка остаётся доступной для чтения.
Импорт данных с символами обрамления
Если данные CSV содержат разделители или разделители столбцов, можно указать однобайтовый символ обрамления, чтобы избежать разбиения данных.
В следующих данных столбец содержит разделитель ,:
Zhang San,30,'Shanghai City, Huangpu District, Dagu Road'
Указав символ обрамления ', можно задать "Shanghai City, Huangpu District, Dagu Road" как одно поле:
curl --location-trusted -u <doris_user>:<doris_password> \
    -H "Expect:100-continue" \
    -H "column_separator:," \
    -H "enclose:'" \
    -H "columns:username,age,address" \
    -T streamload_example.csv \
    -XPUT http://<fe_ip>:<fe_http_port>/api/testdb/test_streamload/_stream_load
Если символ обрамления встречается и внутри поля, например если нужно обработать "Shanghai City, Huangpu District, 'Dagu Road" как одно поле, сначала экранируйте этот символ в столбце:
Zhang San,30,'Shanghai City, Huangpu District, \'Dagu Road'
С помощью параметра escape можно задать однобайтовый символ экранирования, например \, как в следующем примере:
curl --location-trusted -u <doris_user>:<doris_password> \
    -H "Expect:100-continue" \
    -H "column_separator:," \
    -H "enclose:'" \
    -H "escape:\\" \
    -H "columns:username,age,address" \
    -T streamload_example.csv \
    -XPUT http://<fe_ip>:<fe_http_port>/api/testdb/test_streamload/_stream_load
Импорт данных в таблицу с полями DEFAULT CURRENT_TIMESTAMP
В следующем примере данные импортируются в таблицу, поля которой содержат DEFAULT CURRENT_TIMESTAMP.
Схема таблицы:
CREATE TABLE testDb.testTbl (
    `id` BIGINT(30) NOT NULL,
    `order_code` VARCHAR(30) DEFAULT NULL COMMENT '',
    `create_time` DATETIMEv2(3) DEFAULT CURRENT_TIMESTAMP
)
DUPLICATE KEY(id)
DISTRIBUTED BY HASH(id) BUCKETS 10;
Формат данных JSON:
{"id":1,"order_Code":"avc"}
Команда импорта:
curl --location-trusted -u root -T test.json -H "label:1" -H "format:json" -H 'columns: id, order_code, create_time=CURRENT_TIMESTAMP()' http://host:port/api/testDb/testTbl/_stream_load
Импорт данных JSON в простом режиме
Если поля JSON однозначно соответствуют именам столбцов таблицы, можно импортировать данные JSON в таблицу, указав "strip_outer_array:true" и "format:json".
Например, таблица определена следующим образом:
CREATE TABLE testdb.test_streamload(
    user_id            BIGINT       NOT NULL COMMENT "user id",
    name               VARCHAR(20)           COMMENT "name",
    age                INT                   COMMENT "age"
)
DUPLICATE KEY(user_id)
DISTRIBUTED BY HASH(user_id) BUCKETS 10;
Имена полей импортируемых данных однозначно соответствуют именам полей таблицы:
[
{"user_id":1,"name":"Emily","age":25},
{"user_id":2,"name":"Benjamin","age":35},
{"user_id":3,"name":"Olivia","age":28},
{"user_id":4,"name":"Alexander","age":60},
{"user_id":5,"name":"Ava","age":17},
{"user_id":6,"name":"William","age":69},
{"user_id":7,"name":"Sophia","age":32},
{"user_id":8,"name":"James","age":64},
{"user_id":9,"name":"Emma","age":37},
{"user_id":10,"name":"Liam","age":64}
]
Импортировать данные JSON в таблицу можно с помощью следующей команды:
curl --location-trusted -u <doris_user>:<doris_password> \
    -H "Expect:100-continue" \
    -H "format:json" \
    -H "strip_outer_array:true" \
    -T streamload_example.json \
    -XPUT http://<fe_ip>:<fe_http_port>/api/testdb/test_streamload/_stream_load
Импорт сложных данных JSON в режиме сопоставления
Если данные JSON имеют сложную структуру и не могут однозначно соответствовать именам столбцов таблицы или содержат дополнительные столбцы, можно указать параметр jsonpaths, чтобы задать соответствие имён столбцов для импорта в режиме сопоставления. Например, для следующих данных:
[
{"userid":1,"hudi":"lala","username":"Emily","userage":25,"userhp":101},
{"userid":2,"hudi":"kpkp","username":"Benjamin","userage":35,"userhp":102},
{"userid":3,"hudi":"ji","username":"Olivia","userage":28,"userhp":103},
{"userid":4,"hudi":"popo","username":"Alexander","userage":60,"userhp":103},
{"userid":5,"hudi":"uio","username":"Ava","userage":17,"userhp":104},
{"userid":6,"hudi":"lkj","username":"William","userage":69,"userhp":105},
{"userid":7,"hudi":"komf","username":"Sophia","userage":32,"userhp":106},
{"userid":8,"hudi":"mki","username":"James","userage":64,"userhp":107},
{"userid":9,"hudi":"hjk","username":"Emma","userage":37,"userhp":108},
{"userid":10,"hudi":"hua","username":"Liam","userage":64,"userhp":109}
]
С помощью параметра jsonpaths можно сопоставить указанные столбцы:
curl --location-trusted -u <doris_user>:<doris_password> \
    -H "Expect:100-continue" \
    -H "format:json" \
    -H "strip_outer_array:true" \
    -H "jsonpaths:[\"$.userid\", \"$.username\", \"$.userage\"]" \
    -H "columns:user_id,name,age" \
    -T streamload_example.json \
    -XPUT http://<fe_ip>:<fe_http_port>/api/testdb/test_streamload/_stream_load
Указание корневого узла JSON для импорта
Если данные JSON содержат вложенные поля JSON, необходимо указать корневой узел JSON для импорта. Значение по умолчанию: "".
Для следующих данных требуется импортировать в таблицу данные внутри столбца comment:
[
    {"user":1,"comment":{"userid":101,"username":"Emily","userage":25}},
    {"user":2,"comment":{"userid":102,"username":"Benjamin","userage":35}},
    {"user":3,"comment":{"userid":103,"username":"Olivia","userage":28}},
    {"user":4,"comment":{"userid":104,"username":"Alexander","userage":60}},
    {"user":5,"comment":{"userid":105,"username":"Ava","userage":17}},
    {"user":6,"comment":{"userid":106,"username":"William","userage":69}},
    {"user":7,"comment":{"userid":107,"username":"Sophia","userage":32}},
    {"user":8,"comment":{"userid":108,"username":"James","userage":64}},
    {"user":9,"comment":{"userid":109,"username":"Emma","userage":37}},
    {"user":10,"comment":{"userid":110,"username":"Liam","userage":64}}
    ]
Сначала с помощью параметра json_root задайте корневой узел comment, а затем с помощью параметра jsonpaths задайте соответствие имён столбцов:
curl --location-trusted -u <doris_user>:<doris_password> \
    -H "Expect:100-continue" \
    -H "format:json" \
    -H "strip_outer_array:true" \
    -H "json_root: $.comment" \
    -H "jsonpaths:[\"$.userid\", \"$.username\", \"$.userage\"]" \
    -H "columns:user_id,name,age" \
    -T streamload_example.json \
    -XPUT http://<fe_ip>:<fe_http_port>/api/testdb/test_streamload/_stream_load
Импорт данных типа Array
Следующие данные содержат значения типа массива:
1|Emily|[1,2,3,4]
2|Benjamin|[22,45,90,12]
3|Olivia|[23,16,19,16]
4|Alexander|[123,234,456]
5|Ava|[12,15,789]
6|William|[57,68,97]
7|Sophia|[46,47,49]
8|James|[110,127,128]
9|Emma|[19,18,123,446]
10|Liam|[89,87,96,12]
Импортируйте данные в таблицу со следующей схемой:
CREATE TABLE testdb.test_streamload(
    typ_id     BIGINT          NOT NULL COMMENT "ID",
    name       VARCHAR(20)     NULL     COMMENT "name",
    arr        ARRAY<int(10)>  NULL     COMMENT "array"
)
DUPLICATE KEY(typ_id)
DISTRIBUTED BY HASH(typ_id) BUCKETS 10;
С помощью задачи Stream Load можно импортировать данные типа ARRAY из текстового файла непосредственно в таблицу:
curl --location-trusted -u <doris_user>:<doris_password> \
    -H "Expect:100-continue" \
    -H "column_separator:|" \
    -H "columns:typ_id,name,arr" \
    -T streamload_example.csv \
    -XPUT http://<fe_ip>:<fe_http_port>/api/testdb/test_streamload/_stream_load
Импорт данных типа Map
Если импортируемые данные содержат тип Map, как в следующем примере:
[
{"user_id":1,"namemap":{"Emily":101,"age":25}},
{"user_id":2,"namemap":{"Benjamin":102,"age":35}},
{"user_id":3,"namemap":{"Olivia":103,"age":28}},
{"user_id":4,"namemap":{"Alexander":104,"age":60}},
{"user_id":5,"namemap":{"Ava":105,"age":17}},
{"user_id":6,"namemap":{"William":106,"age":69}},
{"user_id":7,"namemap":{"Sophia":107,"age":32}},
{"user_id":8,"namemap":{"James":108,"age":64}},
{"user_id":9,"namemap":{"Emma":109,"age":37}},
{"user_id":10,"namemap":{"Liam":110,"age":64}}
]
Импортируйте данные в таблицу со следующей схемой:
CREATE TABLE testdb.test_streamload(
    user_id            BIGINT       NOT NULL COMMENT "ID",
    namemap            Map<STRING, INT>  NULL     COMMENT "namemap"
)
DUPLICATE KEY(user_id)
DISTRIBUTED BY HASH(user_id) BUCKETS 10;
С помощью задачи Stream Load можно импортировать данные типа Map из текстового файла непосредственно в таблицу:
curl --location-trusted -u <doris_user>:<doris_password> \
    -H "Expect:100-continue" \
    -H "format: json" \
    -H "strip_outer_array:true" \
    -T streamload_example.json \
    -XPUT http://<fe_ip>:<fe_http_port>/api/testdb/test_streamload/_stream_load
Импорт данных типа Bitmap
Если при импорте встречаются данные типа Bitmap, можно использовать to_bitmap для преобразования данных в Bitmap или функцию bitmap_empty для заполнения Bitmap.
Например, импортируемые данные:
1|koga|17723
2|nijg|146285
3|lojn|347890
4|lofn|489871
5|jfin|545679
6|kon|676724
7|nhga|767689
8|nfubg|879878
9|huang|969798
10|buag|97997
Импортируйте данные в следующую таблицу, содержащую тип Bitmap:
CREATE TABLE testdb.test_streamload(
    typ_id     BIGINT                NULL   COMMENT "ID",
    hou        VARCHAR(10)           NULL   COMMENT "one",
    arr        BITMAP  BITMAP_UNION  NOT NULL   COMMENT "two"
)
AGGREGATE KEY(typ_id,hou)
DISTRIBUTED BY HASH(typ_id,hou) BUCKETS 10;
С помощью to_bitmap можно преобразовать данные в тип Bitmap:
curl --location-trusted -u <doris_user>:<doris_password> \
    -H "Expect:100-continue" \
    -H "columns:typ_id,hou,arr,arr=to_bitmap(arr)" \
    -T streamload_example.csv \
    -XPUT http://<fe_ip>:<fe_http_port>/api/testdb/test_streamload/_stream_load
Импорт данных типа HLL
С помощью функции hll_hash можно преобразовать данные в тип HLL. Для следующих данных:
1001|koga
1002|nijg
1003|lojn
1004|lofn
1005|jfin
1006|kon
1007|nhga
1008|nfubg
1009|huang
1010|buag
Выполните импорт в следующую таблицу:
CREATE TABLE testdb.test_streamload(
    typ_id           BIGINT          NULL   COMMENT "ID",
    typ_name         VARCHAR(10)     NULL   COMMENT "NAME",
    pv               hll hll_union   NOT NULL   COMMENT "hll"
)
AGGREGATE KEY(typ_id,typ_name)
DISTRIBUTED BY HASH(typ_id) BUCKETS 10;
Импорт с использованием функции hll_hash:
curl --location-trusted -u <doris_user>:<doris_password> \
    -H "column_separator:|" \
    -H "columns:typ_id,typ_name,pv=hll_hash(typ_id)" \
    -T streamload_example.csv \
    -XPUT http://<fe_ip>:<fe_http_port>/api/testdb/test_streamload/_stream_load
Сопоставление столбцов, вычисляемые столбцы и фильтрация
Doris поддерживает широкий набор операций преобразования столбцов и фильтрации в операторах импорта, а также большинство встроенных функций. Подробнее об использовании этой возможности см. в документации Преобразование данных.
Включение строгого режима импорта
Свойство strict_mode определяет, выполняется ли задача импорта в строгом режиме. Это свойство влияет на результаты сопоставления, преобразования и фильтрации столбцов. Подробнее см. в документации Строгий режим.
Частичное или гибкое частичное обновление столбцов при импорте
О том, как задать частичное обновление столбцов при импорте, см. в документации Обновление столбцов.
Часто задаваемые вопросы
Поддерживает ли Stream Load отмену вручную?
Нет. Система автоматически отменяет Stream Load при истечении времени ожидания или возникновении ошибки импорта; пользователи не могут вручную отменить выполняющееся задание Stream Load.
Есть ли ограничение на размер отдельного файла Stream Load?
Рекомендуется, чтобы размер отдельного импортируемого файла не превышал 10 GB. Более крупные файлы разделите перед импортом. Чтобы увеличить ограничение размера отдельного импорта, также можно изменить параметр конфигурации BE streaming_load_max_mb или использовать Doris Streamloader для параллельного импорта с целью повышения производительности.
Как просмотреть историю заданий Stream Load?
По умолчанию система не сохраняет историю заданий Stream Load. Установите enable_stream_load_record=true в be.conf, выполните перезапуск, а затем используйте show stream load from <db> для просмотра истории.
Как обработать ошибку "Label Already Exists"?
Эта ошибка означает, что та же метка уже использовалась. Состояние существующего задания можно определить по полю ExistingJobStatus в ответе:
RUNNING: задание ещё выполняется; дождитесь его завершения.FINISHED: задание завершилось успешно; повторять импорт не требуется.- Если состояние CANCELLED, ту же метку можно использовать для запуска нового импорта.
Рекомендуется всегда использовать одну и ту же метку для одного пакета данных, чтобы обеспечить семантику At-Most-Once и избежать повторного импорта.
Что делать, если импорт завершается неудачно из-за ошибок формата данных?
Выявить и устранить проблему можно следующим образом:
- Просмотрите конкретные строки с ошибками через поле
ErrorURLв ответе:curl "<ErrorURL>". - При необходимости увеличьте
max_filter_ratio(диапазон от 0 до 1), чтобы допустить некоторую долю некорректных данных. - Проверьте правильность использования значений null (
\N) и пустых строк (отсутствие символов между двумя разделителями) в CSV. - Проверьте, соответствуют ли настройки разделителя столбцов, разделителя строк, символа обрамления (
enclose) и символа экранирования (escape) фактическому содержимому файла.
Что делать при истечении времени ожидания импорта (CANCELLED)?
Оцените подходящее время ожидания исходя из объёма данных:
Import time ~= File size / Estimated import speed (for example, 50MB/s)
Изменить время ожидания можно двумя способами:
- Для отдельного импорта: используйте параметр заголовка
-H "timeout:3000". - Глобально: измените параметр FE
stream_load_default_timeout_second.
Как отличить значения null от пустых строк в CSV?
| Тип | Представление | Пример | Значение среднего столбца |
|---|---|---|---|
| Значение null | Используйте \N | a,\N,b | Средний столбец содержит null |
| Пустая строка | Нет символов между двумя разделителями | a,,b | Средний столбец содержит пустую строку |