Преобразование данных при загрузке
Doris предоставляет широкие возможности преобразования данных при загрузке, которые позволяют упростить часть конвейера обработки данных и снизить зависимость от дополнительных инструментов ETL. Эти встроенные функции преобразования помогают повысить эффективность загрузки и обеспечить единообразие логики обработки данных.
Обзор возможностей преобразования
Doris поддерживает следующие четыре способа преобразования данных при загрузке:
| Способ преобразования | Назначение | Момент выполнения |
|---|---|---|
| Сопоставление столбцов | Сопоставляет столбцы исходных данных с различными столбцами целевой таблицы | После разбора данных |
| Преобразование столбцов | Преобразует исходные данные в реальном времени с помощью функций и выражений | После сопоставления столбцов |
| Предварительная фильтрация | Отфильтровывает ненужные исходные данные до сопоставления и преобразования столбцов | После разбора данных, до сопоставления столбцов |
| Последующая фильтрация | Фильтрует конечный результат после сопоставления и преобразования столбцов | После преобразования столбцов |
Поддержка четырёх возможностей преобразования для каждого способа загрузки приведена ниже:
| Способ загрузки | Сопоставление столбцов | Преобразование столбцов | Предварительная фильтрация | Последующая фильтрация |
|---|---|---|---|---|
| Stream Load | Поддерживается | Поддерживается | Не поддерживается | Поддерживается |
| Broker Load | Поддерживается | Поддерживается | Поддерживается | Поддерживается |
| Routine Load | Поддерживается | Поддерживается | Поддерживается | Поддерживается |
| Insert Into | Реализуется через SELECT | Реализуется через SELECT | Реализуется через WHERE | Реализуется через WHERE |
Синтаксис загрузки
В разных способах загрузки для задания логики преобразования данных используются разные параметры или предложения. Ниже приведено их соответствие.
Stream Load
Преобразование данных задаётся следующими параметрами в заголовке HTTP:
| Параметр | Описание |
|---|---|
columns | Задаёт сопоставление и преобразование столбцов |
where | Задаёт последующую фильтрацию |
Примечание: Stream Load не поддерживает предварительную фильтрацию.
Пример:
curl --location-trusted -u user:passwd \
    -H "columns: k1, k2, tmp_k3, k3 = tmp_k3 + 1" \
    -H "where: k1 > 1" \
    -T data.csv \
    http://<fe_ip>:<fe_http_port>/api/example_db/example_table/_stream_load
Broker Load
Преобразование данных задаётся в SQL с помощью следующих предложений:
| Предложение | Описание |
|---|---|
column list | Задаёт сопоставление столбцов в формате (k1, k2, tmp_k3) |
SET | Задаёт преобразование столбцов |
PRECEDING FILTER | Задаёт предварительную фильтрацию |
WHERE | Задаёт последующую фильтрацию |
Пример:
LOAD LABEL test_db.label1
(
    DATA INFILE("s3://bucket_name/data.csv")
    INTO TABLE `test_tbl`
    (k1, k2, tmp_k3)
    PRECEDING FILTER k1 = 1
    SET (
        k3 = tmp_k3 + 1
    )
    WHERE k1 > 1
)
WITH S3 (...);
Routine Load
Преобразование данных задаётся в SQL с помощью следующих предложений:
| Предложение | Описание |
|---|---|
COLUMNS | Задаёт сопоставление и преобразование столбцов |
PRECEDING FILTER | Задаёт предварительную фильтрацию |
WHERE | Задаёт последующую фильтрацию |
Пример:
CREATE ROUTINE LOAD test_db.label1 ON test_tbl
    COLUMNS(k1, k2, tmp_k3, k3 = tmp_k3 + 1),
    PRECEDING FILTER k1 = 1,
    WHERE k1 > 1
    ...
Insert Into
Insert Into позволяет преобразовывать данные непосредственно в запросе SELECT и использует предложение WHERE для фильтрации данных.
Сопоставление столбцов
Сопоставление столбцов определяет соответствие между столбцами исходных данных и столбцами целевой таблицы. Оно позволяет обрабатывать следующие ситуации:
- Порядок столбцов в исходных данных не совпадает с порядком столбцов в целевой таблице
- Количество столбцов в исходных данных не совпадает с количеством столбцов в целевой таблице
Принцип работы
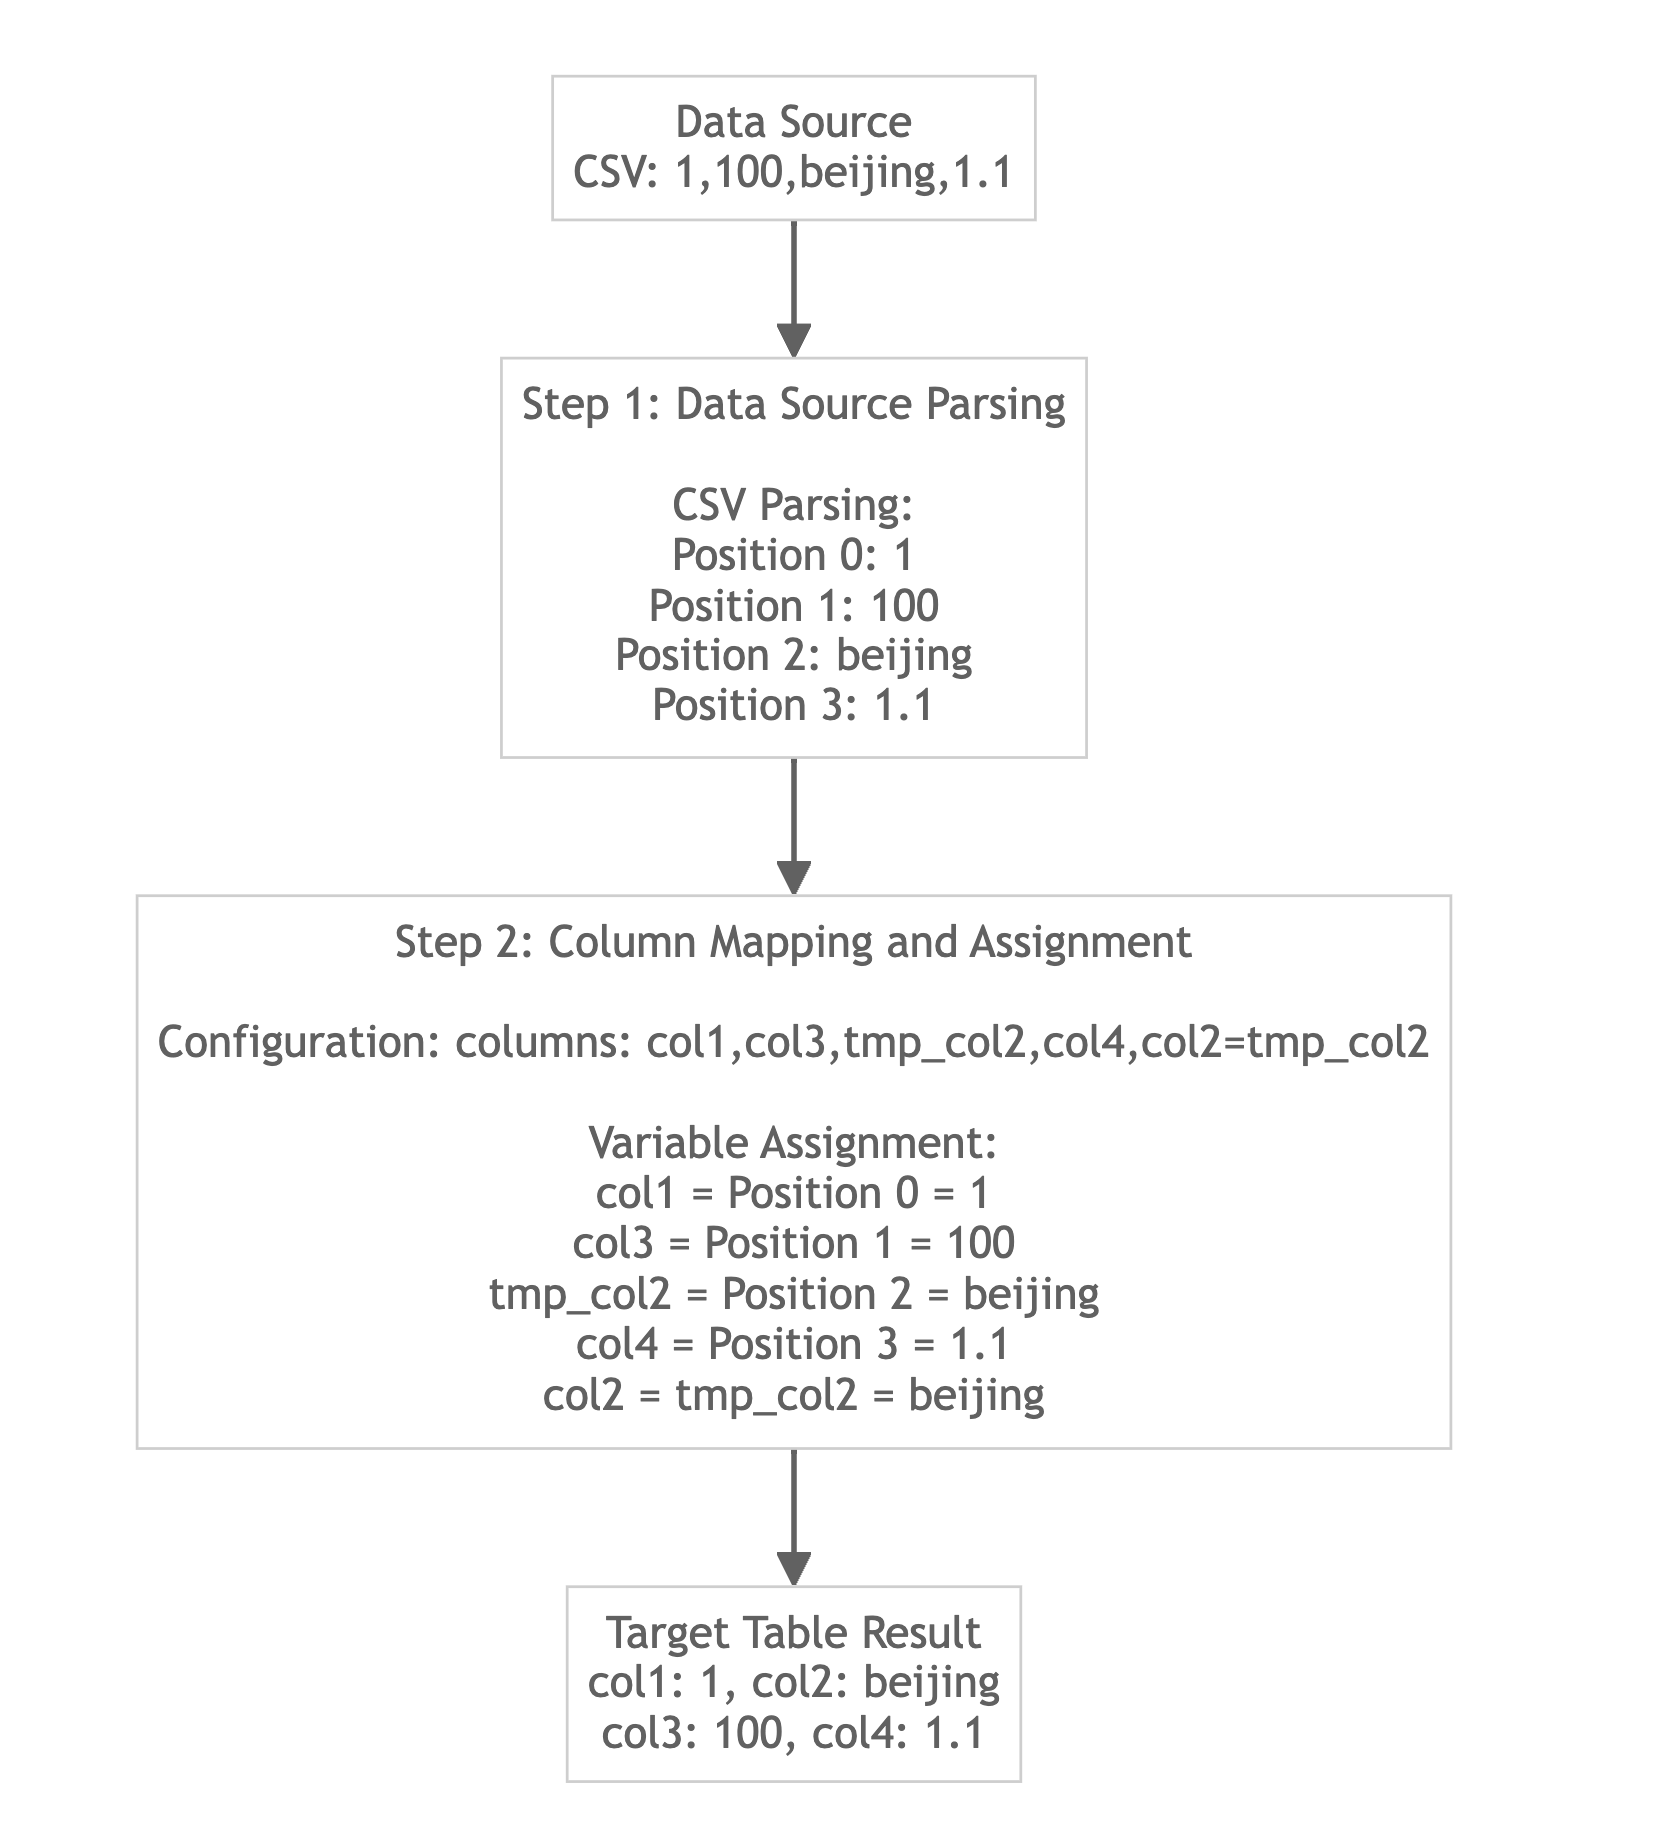
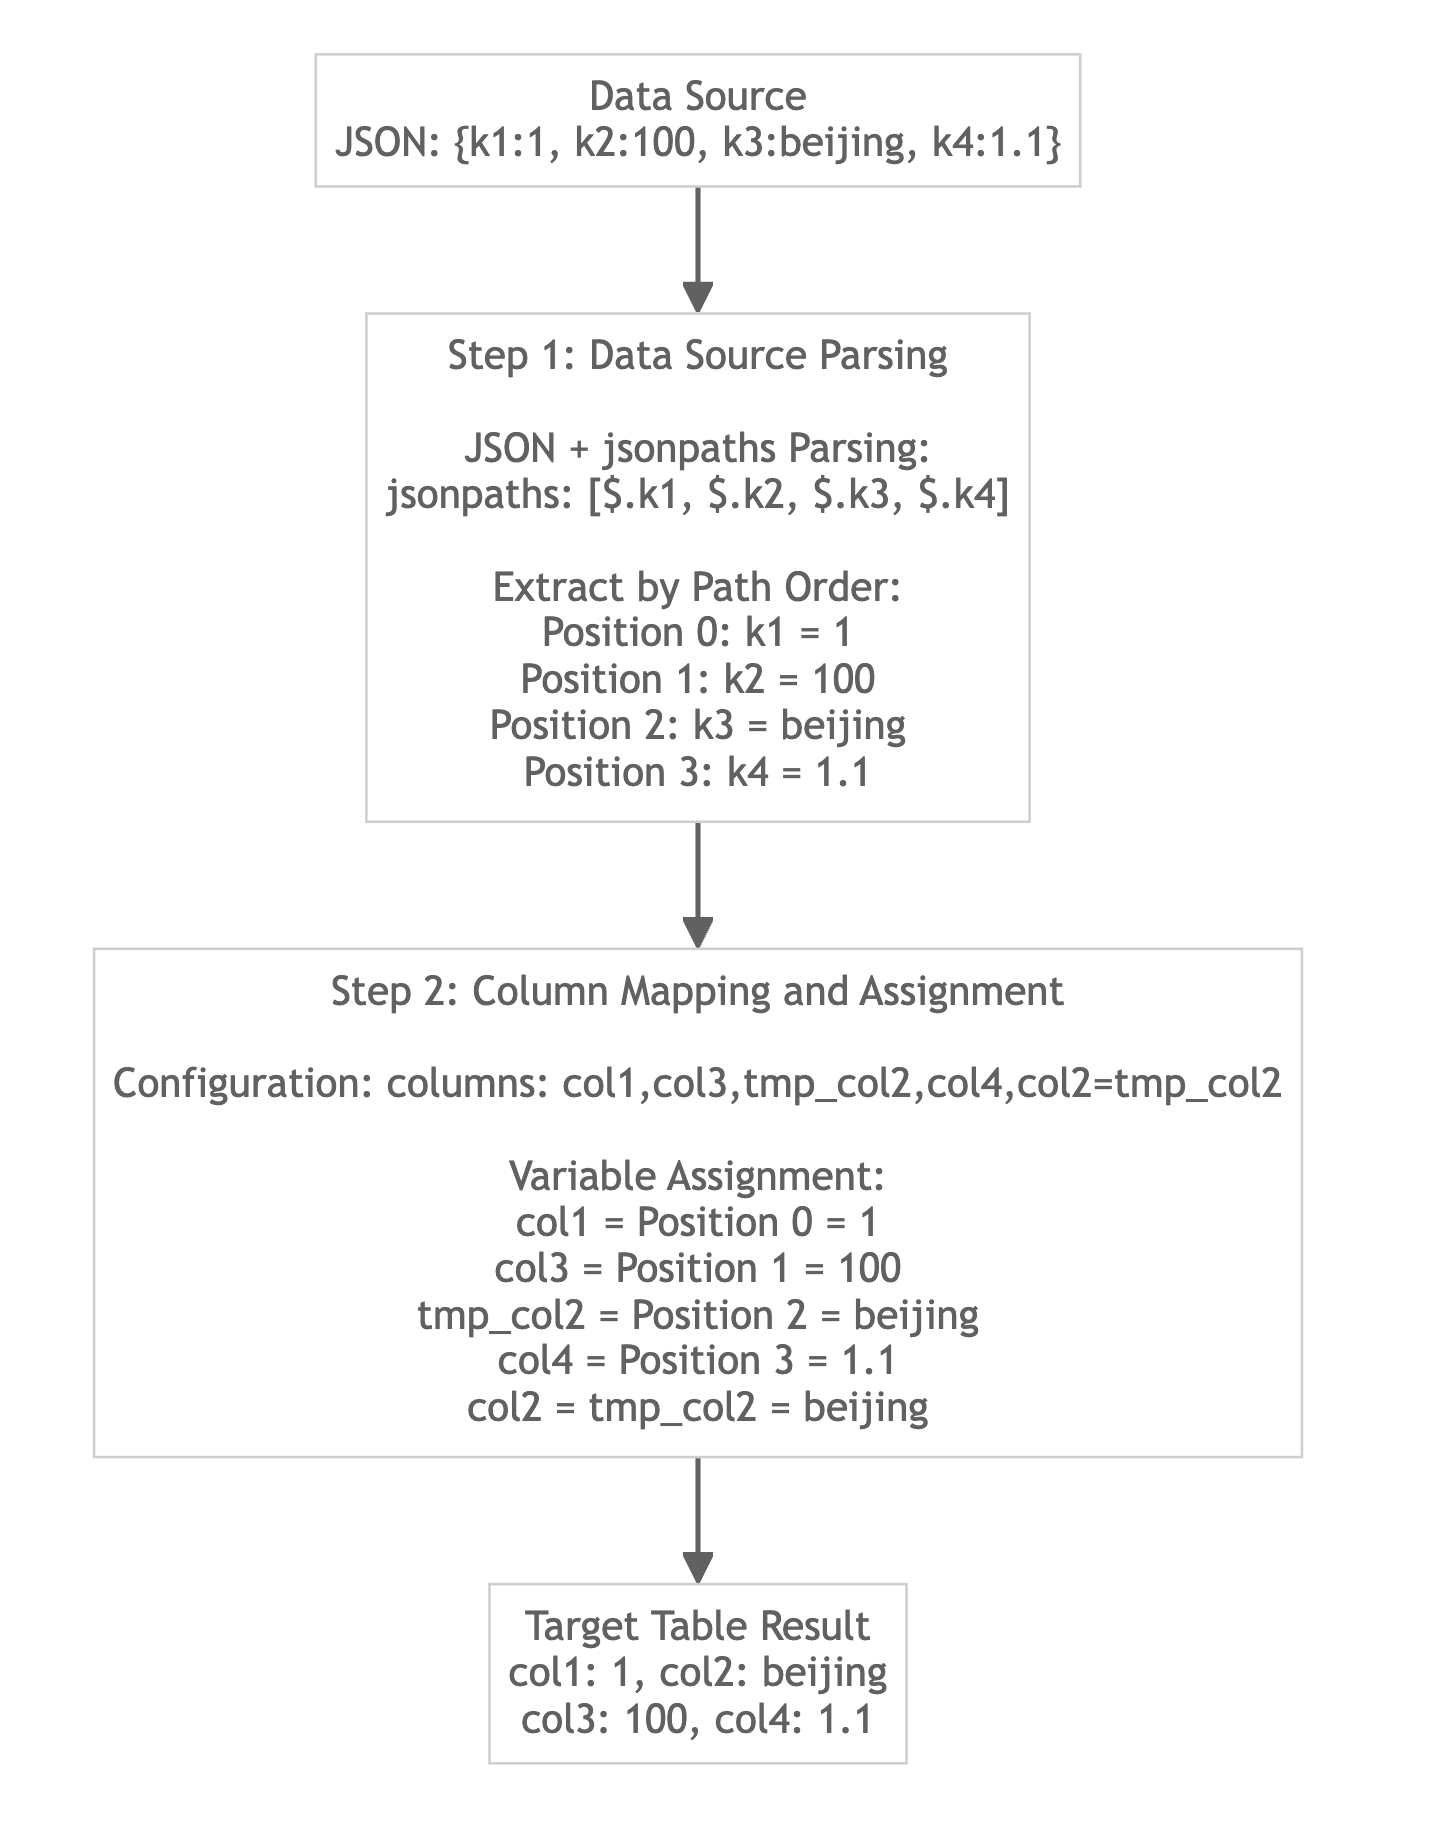
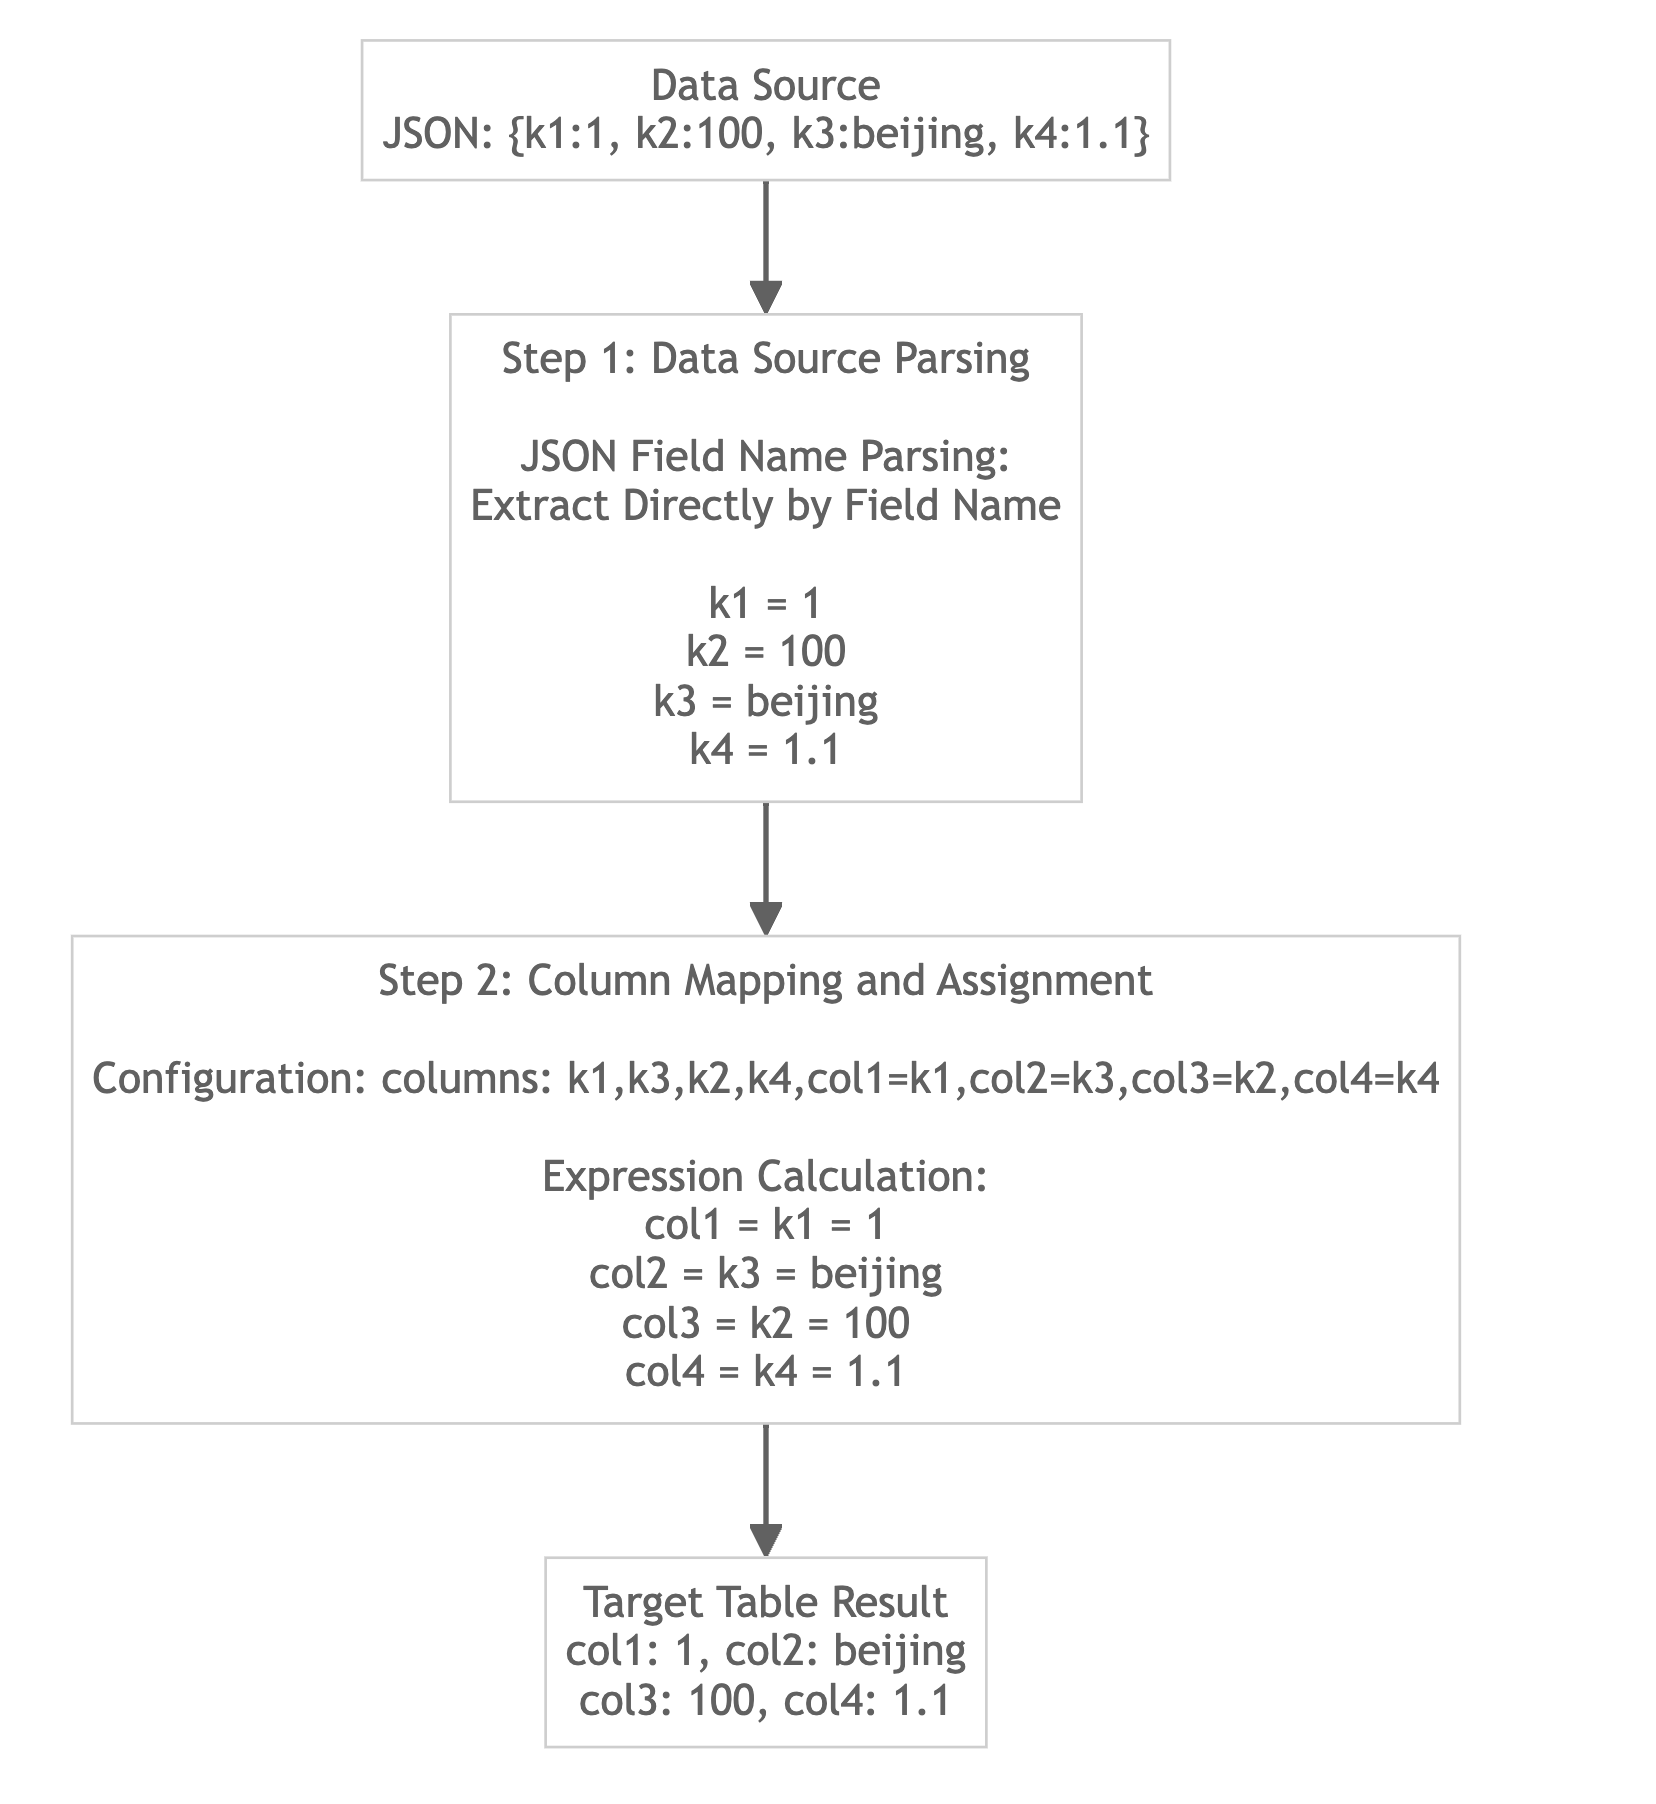
Сопоставление столбцов можно разделить на два основных этапа:
- Разбор исходных данных: исходные данные разбираются в промежуточные переменные в соответствии с форматом данных.
- Присваивание через сопоставление столбцов: промежуточные переменные сопоставляются с полями целевой таблицы по именам столбцов.
Ниже показаны схемы обработки для трёх разных форматов данных:
Загрузка данных в формате CSV
Загрузка данных в формате JSON с указанием jsonpaths
Загрузка данных в формате JSON без указания jsonpaths
Сценарий 1: загрузка данных JSON с указанием jsonpaths
Предположим, что исходные данные имеют следующий вид (имена столбцов в заголовке приведены только для наглядности; в самих данных заголовка нет):
{"k1":1,"k2":"100","k3":"beijing","k4":1.1}
{"k1":2,"k2":"200","k3":"shanghai","k4":1.2}
{"k1":3,"k2":"300","k3":"guangzhou","k4":1.3}
{"k1":4,"k2":"\\N","k3":"chongqing","k4":1.4}
Создание целевой таблицы
CREATE TABLE example_table
(
    col1 INT,
    col2 STRING,
    col3 INT,
    col4 DOUBLE
) ENGINE = OLAP
DUPLICATE KEY(col1)
DISTRIBUTED BY HASH(col1) BUCKETS 1;
Загрузка данных
- Stream Load
curl --location-trusted -u user:passwd \
    -H "columns:col1, col3, col2, col4" \
    -H "jsonpaths:[\"$.k1\", \"$.k2\", \"$.k3\", \"$.k4\"]" \
    -H "format:json" \
    -H "read_json_by_line:true" \
    -T data.json \
    -X PUT \
    http://<fe_ip>:<fe_http_port>/api/example_db/example_table/_stream_load
- Broker Load
LOAD LABEL example_db.label_broker
(
    DATA INFILE("s3://bucket_name/data.json")
    INTO TABLE example_table
    FORMAT AS "json"
    (col1, col3, col2, col4)
    PROPERTIES
    (
        "jsonpaths" = "[\"$.k1\", \"$.k2\", \"$.k3\", \"$.k4\"]"
    )
)
WITH s3 (...);
- Routine Load
CREATE ROUTINE LOAD example_db.example_routine_load ON example_table
COLUMNS(col1, col3, col2, col4)
PROPERTIES
(
    "format" = "json",
    "jsonpaths" = "[\"$.k1\", \"$.k2\", \"$.k3\", \"$.k4\"]",
    "read_json_by_line" = "true"
)
FROM KAFKA (...);
Результат запроса
mysql> SELECT * FROM example_table;
+------+-----------+------+------+
| col1 | col2      | col3 | col4 |
+------+-----------+------+------+
|    1 | beijing   |  100 |  1.1 |
|    2 | shanghai  |  200 |  1.2 |
|    3 | guangzhou |  300 |  1.3 |
|    4 | chongqing | NULL |  1.4 |
+------+-----------+------+------+
Сценарий 2: загрузка данных JSON без указания jsonpaths
Предположим, что исходные данные имеют следующий вид (имена столбцов в заголовке приведены только для наглядности; в самих данных заголовка нет):
{"k1":1,"k2":"100","k3":"beijing","k4":1.1}
{"k1":2,"k2":"200","k3":"shanghai","k4":1.2}
{"k1":3,"k2":"300","k3":"guangzhou","k4":1.3}
{"k1":4,"k2":"\\N","k3":"chongqing","k4":1.4}
Создание целевой таблицы
CREATE TABLE example_table
(
    col1 INT,
    col2 STRING,
    col3 INT,
    col4 DOUBLE
) ENGINE = OLAP
DUPLICATE KEY(col1)
DISTRIBUTED BY HASH(col1) BUCKETS 1;
Загрузка данных
- Stream Load
curl --location-trusted -u user:passwd \
    -H "columns:k1, k3, k2, k4,col1 = k1, col2 = k3, col3 = k2, col4 = k4" \
    -H "format:json" \
    -H "read_json_by_line:true" \
    -T data.json \
    -X PUT \
    http://<fe_ip>:<fe_http_port>/api/example_db/example_table/_stream_load
- Broker Load
LOAD LABEL example_db.label_broker
(
    DATA INFILE("s3://bucket_name/data.json")
    INTO TABLE example_table
    FORMAT AS "json"
    (k1, k3, k2, k4)
    SET (
        col1 = k1,
        col2 = k3,
        col3 = k2,
        col4 = k4
    )
)
WITH s3 (...);
- Routine Load
CREATE ROUTINE LOAD example_db.example_routine_load ON example_table
COLUMNS(k1, k3, k2, k4, col1 = k1, col2 = k3, col3 = k2, col4 = k4),
PROPERTIES
(
    "format" = "json",
    "read_json_by_line" = "true"
)
FROM KAFKA (...);
Результат запроса
mysql> SELECT * FROM example_table;
+------+-----------+------+------+
| col1 | col2      | col3 | col4 |
+------+-----------+------+------+
|    1 | beijing   |  100 |  1.1 |
|    2 | shanghai  |  200 |  1.2 |
|    3 | guangzhou |  300 |  1.3 |
|    4 | chongqing | NULL |  1.4 |
+------+-----------+------+------+
Сценарий 3: изменение порядка столбцов
Предположим, что исходные данные имеют следующий вид (имена столбцов в заголовке приведены только для наглядности; в самих данных заголовка нет):
column 1, column 2, column 3, column 4
1,100,beijing,1.1
2,200,shanghai,1.2
3,300,guangzhou,1.3
4,\N,chongqing,1.4
В целевой таблице четыре столбца: k1, k2, k3 и k4. Сопоставление должно быть следующим:
column 1 -> k1
column 2 -> k3
column 3 -> k2
column 4 -> k4
Создание целевой таблицы
CREATE TABLE example_table
(
    k1 INT,
    k2 STRING,
    k3 INT,
    k4 DOUBLE
) ENGINE = OLAP
DUPLICATE KEY(k1)
DISTRIBUTED BY HASH(k1) BUCKETS 1;
Загрузка данных
- Stream Load
curl --location-trusted -u user:passwd \
    -H "column_separator:," \
    -H "columns: k1,k3,k2,k4" \
    -T data.csv \
    -X PUT \
    http://<fe_ip>:<fe_http_port>/api/example_db/example_table/_stream_load
- Broker Load
LOAD LABEL example_db.label_broker
(
    DATA INFILE("s3://bucket_name/data.csv")
    INTO TABLE example_table
    COLUMNS TERMINATED BY ","
    (k1, k3, k2, k4)
)
WITH s3 (...);
- Routine Load
CREATE ROUTINE LOAD example_db.example_routine_load ON example_table
COLUMNS(k1, k3, k2, k4),
COLUMNS TERMINATED BY ","
FROM KAFKA (...);
Результат запроса
mysql> select * from example_table;
+------+-----------+------+------+
| k1   | k2        | k3   | k4   |
+------+-----------+------+------+
|    2 | shanghai  |  200 |  1.2 |
|    4 | chongqing | NULL |  1.4 |
|    3 | guangzhou |  300 |  1.3 |
|    1 | beijing   |  100 |  1.1 |
+------+-----------+------+------+
Сценарий 4: в исходном файле больше столбцов, чем в таблице
Предположим, что исходные данные имеют следующий вид (имена столбцов в заголовке приведены только для наглядности; в самих данных заголовка нет):
column 1, column 2, column 3, column 4
1,100,beijing,1.1
2,200,shanghai,1.2
3,300,guangzhou,1.3
4,\N,chongqing,1.4
В целевой таблице три столбца k1, k2 и k3, а в исходном файле четыре. Нужны только 1-й, 2-й и 4-й столбцы исходного файла со следующим сопоставлением:
column 1 -> k1
column 2 -> k2
column 4 -> k3
Чтобы пропустить определённые столбцы исходного файла, достаточно при сопоставлении указать для них любые имена столбцов, которых нет в целевой таблице. Эти имена можно выбирать без ограничений, а данные таких столбцов будут автоматически игнорироваться при загрузке.
Создание таблицы для примера
CREATE TABLE example_table
(
    k1 INT,
    k2 STRING,
    k3 DOUBLE
) ENGINE = OLAP
DUPLICATE KEY(k1)
DISTRIBUTED BY HASH(k1) BUCKETS 1;
Загрузка данных
- Stream Load
curl --location-trusted -u user:password \
    -H "column_separator:," \
    -H "columns: k1,k2,tmp_skip,k3" \
    -T data.csv \
    http://<fe_ip>:<fe_http_port>/api/example_db/example_table/_stream_load
- Broker Load
LOAD LABEL example_db.label_broker
(
    DATA INFILE("s3://bucket_name/data.csv")
    INTO TABLE example_table
    COLUMNS TERMINATED BY ","
    (tmp_k1, tmp_k2, tmp_skip, tmp_k3)
    SET (
        k1 = tmp_k1,
        k2 = tmp_k2,
        k3 = tmp_k3
    )
)
WITH s3 (...);
- Routine Load
CREATE ROUTINE LOAD example_db.example_routine_load ON example_table
COLUMNS(k1, k2, tmp_skip, k3),
PROPERTIES
(
    "format" = "csv",
    "column_separator" = ","
)
FROM KAFKA (...);
Примечание:
tmp_skipв примере можно заменить любым именем, если его нет в определении столбцов целевой таблицы.
Результат запроса
mysql> select * from example_table;
+------+------+------+
| k1   | k2   | k3   |
+------+------+------+
|    1 | 100  |  1.1 |
|    2 | 200  |  1.2 |
|    3 | 300  |  1.3 |
|    4 | NULL |  1.4 |
+------+------+------+
Сценарий 5: в исходном файле меньше столбцов, чем в таблице
Предположим, что исходные данные имеют следующий вид (имена столбцов в заголовке приведены только для наглядности; в самих данных заголовка нет):
column 1, column 2, column 3, column 4
1,100,beijing,1.1
2,200,shanghai,1.2
3,300,guangzhou,1.3
4,\N,chongqing,1.4
В целевой таблице пять столбцов k1, k2, k3, k4 и k5, а в исходном файле четыре. Нужны только 1-й, 2-й, 3-й и 4-й столбцы исходного файла со следующим сопоставлением:
column 1 -> k1
column 2 -> k3
column 3 -> k2
column 4 -> k4
k5 uses the default value
Столбцы целевой таблицы, для которых нет исходных данных, обрабатываются по следующим правилам:
- Если у столбца есть значение по умолчанию, используется это значение.
- Если столбец допускает NULL, но не имеет значения по умолчанию, используется NULL.
- Если столбец не допускает NULL и не имеет значения по умолчанию, загрузка завершается ошибкой.
Создание таблицы для примера
CREATE TABLE example_table
(
    k1 INT,
    k2 STRING,
    k3 INT,
    k4 DOUBLE,
    k5 INT DEFAULT 2
) ENGINE = OLAP
DUPLICATE KEY(k1)
DISTRIBUTED BY HASH(k1) BUCKETS 1;
Загрузка данных
- Stream Load
curl --location-trusted -u user:passwd \
    -H "column_separator:," \
    -H "columns: k1,k3,k2,k4" \
    -T data.csv \
    http://<fe_ip>:<fe_http_port>/api/example_db/example_table/_stream_load
- Broker Load
LOAD LABEL example_db.label_broker
(
    DATA INFILE("s3://bucket_name/data.csv")
    INTO TABLE example_table
    COLUMNS TERMINATED BY ","
    (tmp_k1, tmp_k3, tmp_k2, tmp_k4)
    SET (
        k1 = tmp_k1,
        k3 = tmp_k3,
        k2 = tmp_k2,
        k4 = tmp_k4
    )
)
WITH s3 (...);
- Routine Load
CREATE ROUTINE LOAD example_db.example_routine_load ON example_table
COLUMNS(k1, k3, k2, k4),
COLUMNS TERMINATED BY ","
FROM KAFKA (...);
Результат запроса
mysql> select * from example_table;
+------+-----------+------+------+------+
| k1   | k2        | k3   | k4   | k5   |
+------+-----------+------+------+------+
|    1 | beijing   |  100 |  1.1 |    2 |
|    2 | shanghai  |  200 |  1.2 |    2 |
|    3 | guangzhou |  300 |  1.3 |    2 |
|    4 | chongqing | NULL |  1.4 |    2 |
+------+-----------+------+------+------+
Преобразование столбцов
Преобразование столбцов позволяет изменять значения столбцов из исходного файла. Поддерживается большинство встроенных функций. Преобразование столбцов обычно задаётся вместе с их сопоставлением: сначала столбцы сопоставляются, а затем преобразуются.
Сценарий 1: арифметическое преобразование значений исходных столбцов
Предположим, что исходные данные имеют следующий вид (имена столбцов в заголовке приведены только для наглядности; в самих данных заголовка нет):
column 1, column 2, column 3, column 4
1,100,beijing,1.1
2,200,shanghai,1.2
3,300,guangzhou,1.3
4,\N,chongqing,1.4
В таблице четыре столбца k1, k2, k3 и k4. Сопоставление и преобразование при загрузке выглядят следующим образом:
column 1       -> k1
column 2 * 100 -> k3
column 3       -> k2
column 4       -> k4
Создание таблицы для примера
CREATE TABLE example_table
(
    k1 INT,
    k2 STRING,
    k3 INT,
    k4 DOUBLE
)
ENGINE = OLAP
DUPLICATE KEY(k1)
DISTRIBUTED BY HASH(k1) BUCKETS 1;
Загрузка данных
- Stream Load
curl --location-trusted -u user:passwd \
    -H "column_separator:," \
    -H "columns: k1, tmp_k3, k2, k4, k3 = tmp_k3 * 100" \
    -T data.csv \
    http://host:port/api/example_db/example_table/_stream_load
- Broker Load
LOAD LABEL example_db.label1
(
    DATA INFILE("s3://bucket_name/data.csv")
    INTO TABLE example_table
    COLUMNS TERMINATED BY ","
    (k1, tmp_k3, k2, k4)
    SET (
        k3 = tmp_k3 * 100
    )
)
WITH s3 (...);
- Routine Load
CREATE ROUTINE LOAD example_db.example_routine_load ON example_table
COLUMNS(k1, tmp_k3, k2, k4, k3 = tmp_k3 * 100),
COLUMNS TERMINATED BY ","
FROM KAFKA (...);
Результат запроса
mysql> select * from example_table;
+------+-----------+-------+------+
| k1   | k2        | k3    | k4   |
+------+-----------+-------+------+
|    1 | beijing   | 10000 |  1.1 |
|    2 | shanghai  | 20000 |  1.2 |
|    3 | guangzhou | 30000 |  1.3 |
|    4 | chongqing |  NULL |  1.4 |
+------+-----------+-------+------+
Сценарий 2: условное преобразование столбцов с помощью функции CASE WHEN
Предположим, что исходные данные имеют следующий вид (имена столбцов в заголовке приведены только для наглядности; в самих данных заголовка нет):
column 1, column 2, column 3, column 4
1,100,beijing,1.1
2,200,shanghai,1.2
3,300,guangzhou,1.3
4,\N,chongqing,1.4
В таблице четыре столбца k1, k2, k3 и k4. Значения beijing, shanghai, guangzhou и chongqing в исходных данных перед загрузкой преобразуются в соответствующие идентификаторы регионов:
column 1                                 -> k1
column 2                                 -> k2
column 3 (after region ID conversion)    -> k3
column 4                                 -> k4
Создание таблицы для примера
CREATE TABLE example_table
(
    k1 INT,
    k2 INT,
    k3 INT,
    k4 DOUBLE
)
ENGINE = OLAP
DUPLICATE KEY(k1)
DISTRIBUTED BY HASH(k1) BUCKETS 1;
Загрузка данных
- Stream Load
curl --location-trusted -u user:passwd \
    -H "column_separator:," \
    -H "columns: k1, k2, tmp_k3, k4, k3 = CASE tmp_k3 WHEN 'beijing' THEN 1 WHEN 'shanghai' THEN 2 WHEN 'guangzhou' THEN 3 WHEN 'chongqing' THEN 4 ELSE NULL END" \
    -T data.csv \
    http://host:port/api/example_db/example_table/_stream_load
- Broker Load
LOAD LABEL example_db.label1
(
    DATA INFILE("s3://bucket_name/data.csv")
    INTO TABLE example_table
    COLUMNS TERMINATED BY ","
    (k1, k2, tmp_k3, k4)
    SET (
        k3 = CASE tmp_k3 WHEN 'beijing' THEN 1 WHEN 'shanghai' THEN 2 WHEN 'guangzhou' THEN 3 WHEN 'chongqing' THEN 4 ELSE NULL END
    )
)
WITH s3 (...);
- Routine Load
CREATE ROUTINE LOAD example_db.example_routine_load ON example_table
COLUMNS(k1, k2, tmp_k3, k4, k3 = CASE tmp_k3 WHEN 'beijing' THEN 1 WHEN 'shanghai' THEN 2 WHEN 'guangzhou' THEN 3 WHEN 'chongqing' THEN 4 ELSE NULL END),
COLUMNS TERMINATED BY ","
FROM KAFKA (...);
Результат запроса
mysql> select * from example_table;
+------+------+------+------+
| k1   | k2   | k3   | k4   |
+------+------+------+------+
|    1 |  100 |    1 |  1.1 |
|    2 |  200 |    2 |  1.2 |
|    3 |  300 |    3 |  1.3 |
|    4 | NULL |    4 |  1.4 |
+------+------+------+------+
Сценарий 3: обработка значений NULL в исходном файле
Предположим, что исходные данные имеют следующий вид (имена столбцов в заголовке приведены только для наглядности; в самих данных заголовка нет):
column 1, column 2, column 3, column 4
1,100,beijing,1.1
2,200,shanghai,1.2
3,300,guangzhou,1.3
4,\N,chongqing,1.4
В таблице четыре столбца k1, k2, k3 и k4. При загрузке наряду с преобразованием идентификатора региона значение NULL в столбце k2 исходных данных заменяется на 0:
column 1                                  -> k1
column 2 (convert null to 0 if null)      -> k2
column 3                                  -> k3
column 4                                  -> k4
Создание таблицы для примера
CREATE TABLE example_table
(
    k1 INT,
    k2 INT,
    k3 INT,
    k4 DOUBLE
)
ENGINE = OLAP
DUPLICATE KEY(k1)
DISTRIBUTED BY HASH(k1) BUCKETS 1;
Загрузка данных
- Stream Load
curl --location-trusted -u user:passwd \
    -H "column_separator:," \
    -H "columns: k1, tmp_k2, tmp_k3, k4, k2 = ifnull(tmp_k2, 0), k3 = CASE tmp_k3 WHEN 'beijing' THEN 1 WHEN 'shanghai' THEN 2 WHEN 'guangzhou' THEN 3 WHEN 'chongqing' THEN 4 ELSE NULL END" \
    -T data.csv \
    http://host:port/api/example_db/example_table/_stream_load
- Broker Load
LOAD LABEL example_db.label1
(
    DATA INFILE("s3://bucket_name/data.csv")
    INTO TABLE example_table
    COLUMNS TERMINATED BY ","
    (k1, tmp_k2, tmp_k3, k4)
    SET (
        k2 = ifnull(tmp_k2, 0),
        k3 = CASE tmp_k3 WHEN 'beijing' THEN 1 WHEN 'shanghai' THEN 2 WHEN 'guangzhou' THEN 3 WHEN 'chongqing' THEN 4 ELSE NULL END
    )
)
WITH s3 (...);
- Routine Load
CREATE ROUTINE LOAD example_db.example_routine_load ON example_table
COLUMNS(k1, tmp_k2, tmp_k3, k4, k2 = ifnull(tmp_k2, 0), k3 = CASE tmp_k3 WHEN 'beijing' THEN 1 WHEN 'shanghai' THEN 2 WHEN 'guangzhou' THEN 3 WHEN 'chongqing' THEN 4 ELSE NULL END),
COLUMNS TERMINATED BY ","
FROM KAFKA (...);
Результат запроса
mysql> select * from example_table;
+------+------+------+------+
| k1   | k2   | k3   | k4   |
+------+------+------+------+
|    1 |  100 |    1 |  1.1 |
|    2 |  200 |    2 |  1.2 |
|    3 |  300 |    3 |  1.3 |
|    4 |    0 |    4 |  1.4 |
+------+------+------+------+
Предварительная фильтрация
Предварительная фильтрация отбирает исходные данные до преобразования. Она позволяет заранее исключить данные, которые не нужно обрабатывать, сократить объём последующей обработки и повысить эффективность загрузки. Эта возможность поддерживается только в Broker Load и Routine Load.
Сценарии использования
- Фильтрация до преобразования: фильтрация до сопоставления и преобразования столбцов позволяет заранее удалить часть ненужных данных.
- Столбцы фильтрации отсутствуют в таблице и используются только как признаки для отбора: например, исходные данные содержат строки из нескольких таблиц (или строки из нескольких таблиц записываются в одну очередь сообщений Kafka), и в каждой строке есть столбец с именем таблицы, указывающий, к какой таблице относится строка. С помощью условия предварительной фильтрации можно выбрать для загрузки данные соответствующей таблицы.
Ограничения
| Ограничение | Описание |
|---|---|
| Ограничение на столбцы фильтрации | Предварительная фильтрация может использовать только самостоятельные простые столбцы из списка столбцов и не может использовать столбцы, полученные из выражений. Например, если сопоставление столбцов задано как (a, tmp, b = tmp + 1), столбец b нельзя использовать в условии фильтрации. |
| Ограничение на обработку данных | Предварительная фильтрация выполняется до преобразования данных и использует для сравнения исходные значения. Исходные данные рассматриваются как строки. Например, данные вида \N сравниваются непосредственно как строка \N, без предварительного преобразования в NULL. |
Пример 1: предварительная фильтрация с числовым условием
В этом примере показано, как фильтровать исходные данные с помощью простого условия числового сравнения. Условие фильтрации k1 > 1 позволяет исключить ненужные записи до преобразования данных.
Предположим, что исходные данные имеют следующий вид (имена столбцов в заголовке приведены только для наглядности; в самих данных заголовка нет):
column 1, column 2, column 3, column 4
1,100,beijing,1.1
2,200,shanghai,1.2
3,300,guangzhou,1.3
4,\N,chongqing,1.4
Условие предварительной фильтрации:
column 1 > 1, that is, only data with column 1 > 1 is imported, and the rest is filtered out.
Создание таблицы для примера
CREATE TABLE example_table
(
    k1 INT,
    k2 INT,
    k3 STRING,
    k4 DOUBLE
)
ENGINE = OLAP
DUPLICATE KEY(k1)
DISTRIBUTED BY HASH(k1) BUCKETS 1;
Загрузка данных
- Broker Load
LOAD LABEL example_db.label1
(
    DATA INFILE("s3://bucket_name/data.csv")
    INTO TABLE example_table
    COLUMNS TERMINATED BY ","
    (k1, k2, k3, k4)
    PRECEDING FILTER k1 > 1
)
WITH s3 (...);
- Routine Load
CREATE ROUTINE LOAD example_db.example_routine_load ON example_table
COLUMNS(k1, k2, k3, k4),
COLUMNS TERMINATED BY ","
PRECEDING FILTER k1 > 1
FROM KAFKA (...)
Результат запроса
mysql> select * from example_table;
+------+------+-----------+------+
| k1   | k2   | k3        | k4   |
+------+------+-----------+------+
|    2 |  200 | shanghai  |  1.2 |
|    3 |  300 | guangzhou |  1.3 |
|    4 | NULL | chongqing |  1.4 |
+------+------+-----------+------+
Пример 2: фильтрация некорректных данных с помощью промежуточного столбца
В этом примере показано, как выполнять загрузку, если в исходных данных есть некорректные значения.
Исходные данные:
1,1
2,abc
3,3
Оператор создания таблицы
CREATE TABLE example_table
(
    k1 INT,
    k2 INT NOT NULL
)
ENGINE = OLAP
DUPLICATE KEY(k1)
DISTRIBUTED BY HASH(k1) BUCKETS 1;
Для столбца k2 с типом int значение abc является некорректным. Чтобы отфильтровать такие данные, можно ввести промежуточный столбец для фильтрации.
Оператор загрузки
- Broker Load
LOAD LABEL example_db.label1
(
    DATA INFILE("s3://bucket_name/data.csv")
    INTO TABLE example_table
    COLUMNS TERMINATED BY ","
    (k1, tmp, k2 = tmp)
    PRECEDING FILTER tmp != "abc"
)
WITH s3 (...);
- Routine Load
CREATE ROUTINE LOAD example_db.example_routine_load ON example_table
COLUMNS(k1, tmp, k2 = tmp),
COLUMNS TERMINATED BY ","
PRECEDING FILTER tmp != "abc"
FROM KAFKA (...);
Результат загрузки
mysql> select * from example_table;
+------+----+
| k1   | k2 |
+------+----+
|    1 |  1 |
|    3 |  3 |
+------+----+
Последующая фильтрация
Последующая фильтрация выполняется после преобразования данных и позволяет отбирать данные на основе результата преобразования.
Сценарий 1: прямая фильтрация без сопоставления и преобразования столбцов
Предположим, что исходные данные имеют следующий вид (имена столбцов в заголовке приведены только для наглядности; в самих данных заголовка нет):
column 1, column 2, column 3, column 4
1,100,beijing,1.1
2,200,shanghai,1.2
3,300,guangzhou,1.3
4,\N,chongqing,1.4
В таблице четыре столбца k1, k2, k3 и k4. Без сопоставления и преобразования столбцов загружаются только строки, в которых значение 4-го столбца исходного файла больше 1.2.
Создание таблицы для примера
CREATE TABLE example_table
(
    k1 INT,
    k2 INT,
    k3 STRING,
    k4 DOUBLE
)
ENGINE = OLAP
DUPLICATE KEY(k1)
DISTRIBUTED BY HASH(k1) BUCKETS 1;
Загрузка данных
- Stream Load
curl --location-trusted -u user:passwd \
    -H "column_separator:," \
    -H "columns: k1, k2, k3, k4" \
    -H "where: k4 > 1.2" \
    -T data.csv \
    http://host:port/api/example_db/example_table/_stream_load
- Broker Load
LOAD LABEL example_db.label1
(
    DATA INFILE("s3://bucket_name/data.csv")
    INTO TABLE example_table
    COLUMNS TERMINATED BY ","
    (k1, k2, k3, k4)
    where k4 > 1.2
)
WITH s3 (...);
- Routine Load
CREATE ROUTINE LOAD example_db.example_routine_load ON example_table
COLUMNS(k1, k2, k3, k4),
COLUMNS TERMINATED BY ","
WHERE k4 > 1.2;
FROM KAFKA (...)
Результат запроса
mysql> select * from example_table;
+------+------+-----------+------+
| k1   | k2   | k3        | k4   |
+------+------+-----------+------+
|    3 |  300 | guangzhou |  1.3 |
|    4 | NULL | chongqing |  1.4 |
+------+------+-----------+------+
Сценарий 2: фильтрация данных после преобразования столбцов
Предположим, что исходные данные имеют следующий вид (имена столбцов в заголовке приведены только для наглядности; в самих данных заголовка нет):
column 1, column 2, column 3, column 4
1,100,beijing,1.1
2,200,shanghai,1.2
3,300,guangzhou,1.3
4,\N,chongqing,1.4
В таблице четыре столбца k1, k2, k3 и k4. В примере преобразования столбцов название провинции преобразуется в идентификатор. Здесь требуется исключить строки с идентификатором 3.
Создание таблицы для примера
CREATE TABLE example_table
(
    k1 INT,
    k2 INT,
    k3 INT,
    k4 DOUBLE
)
ENGINE = OLAP
DUPLICATE KEY(k1)
DISTRIBUTED BY HASH(k1) BUCKETS 1;
Загрузка данных
- Stream Load
curl --location-trusted -u user:passwd \
    -H "column_separator:," \
    -H "columns: k1, k2, tmp_k3, k4, k3 = case tmp_k3 when 'beijing' then 1 when 'shanghai' then 2 when 'guangzhou' then 3 when 'chongqing' then 4 else null end" \
    -H "where: k3 != 3" \
    -T data.csv \
    http://host:port/api/example_db/example_table/_stream_load
- Broker Load
LOAD LABEL example_db.label1
(
    DATA INFILE("s3://bucket_name/data.csv")
    INTO TABLE example_table
    COLUMNS TERMINATED BY ","
    (k1, k2, tmp_k3, k4)
    SET (
        k3 = CASE tmp_k3 WHEN 'beijing' THEN 1 WHEN 'shanghai' THEN 2 WHEN 'guangzhou' THEN 3 WHEN 'chongqing' THEN 4 ELSE NULL END
    )
    WHERE k3 != 3
)
WITH s3 (...);
- Routine Load
CREATE ROUTINE LOAD example_db.example_routine_load ON example_table
COLUMNS(k1, k2, tmp_k3, k4),
COLUMNS TERMINATED BY ","
SET (
    k3 = CASE tmp_k3 WHEN 'beijing' THEN 1 WHEN 'shanghai' THEN 2 WHEN 'guangzhou' THEN 3 WHEN 'chongqing' THEN 4 ELSE NULL END
)
WHERE k3 != 3;
FROM KAFKA (...)
Результат запроса
mysql> select * from example_table;
+------+------+------+------+
| k1   | k2   | k3   | k4   |
+------+------+------+------+
|    1 |  100 |    1 |  1.1 |
|    2 |  200 |    2 |  1.2 |
|    4 | NULL |    4 |  1.4 |
+------+------+------+------+
Сценарий 3: фильтрация по нескольким условиям
Предположим, что исходные данные имеют следующий вид (имена столбцов в заголовке приведены только для наглядности; в самих данных заголовка нет):
column 1, column 2, column 3, column 4
1,100,beijing,1.1
2,200,shanghai,1.2
3,300,guangzhou,1.3
4,\N,chongqing,1.4
В таблице четыре столбца k1, k2, k3 и k4. Нужно исключить строки, в которых столбец k1 содержит NULL, а также строки, в которых значение столбца k4 меньше 1.2.
Создание таблицы для примера
CREATE TABLE example_table
(
    k1 INT,
    k2 INT,
    k3 STRING,
    k4 DOUBLE
)
ENGINE = OLAP
DUPLICATE KEY(k1)
DISTRIBUTED BY HASH(k1) BUCKETS 1;
Загрузка данных
- Stream Load
curl --location-trusted -u user:passwd \
    -H "column_separator:," \
    -H "columns: k1, k2, k3, k4" \
    -H "where: k1 is not null and k4 > 1.2" \
    -T data.csv \
    http://host:port/api/example_db/example_table/_stream_load
- Broker Load
LOAD LABEL example_db.label1
(
    DATA INFILE("s3://bucket_name/data.csv")
    INTO TABLE example_table
    COLUMNS TERMINATED BY ","
    (k1, k2, k3, k4)
    where k1 is not null and k4 > 1.2
)
WITH s3 (...);
- Routine Load
CREATE ROUTINE LOAD example_db.example_routine_load ON example_table
COLUMNS(k1, k2, k3, k4),
COLUMNS TERMINATED BY ","
WHERE k1 is not null and k4 > 1.2
FROM KAFKA (...);
Результат запроса
mysql> select * from example_table;
+------+------+-----------+------+
| k1   | k2   | k3        | k4   |
+------+------+-----------+------+
|    3 |  300 | guangzhou |  1.3 |
|    4 | NULL | chongqing |  1.4 |
+------+------+-----------+------+
Часто задаваемые вопросы
1. Почему в Stream Load нет PRECEDING FILTER?
Stream Load не поддерживает предварительную фильтрацию. Он позволяет выполнять только последующую фильтрацию через параметр where. Если требуется предварительная фильтрация, используйте Broker Load или Routine Load.
2. Почему предварительная фильтрация не рассматривает \N как NULL?
Предварительная фильтрация выполняется до преобразования данных и использует для сравнения исходные значения. Исходные данные рассматриваются как строки. Для \N при сравнении непосредственно используется строка \N, без предварительного преобразования в NULL. Для фильтрации по NULL используйте последующую фильтрацию (WHERE).
3. Как пропустить определённые столбцы исходного файла при сопоставлении столбцов?
В списке сопоставления столбцов назначьте ненужному столбцу имя, которого нет в целевой таблице (например, tmp_skip). Эти временные имена столбцов служат только заполнителями и автоматически игнорируются при загрузке.
4. Как обрабатываются столбцы целевой таблицы, которых нет в исходном файле?
Они заполняются по следующим правилам:
- Если у столбца есть значение по умолчанию, используется это значение.
- Если столбец допускает NULL, но не имеет значения по умолчанию, используется NULL.
- Если столбец не допускает NULL и не имеет значения по умолчанию, загрузка завершается ошибкой.
5. Какие функции можно использовать при преобразовании столбцов?
Преобразование столбцов поддерживает большинство встроенных функций, таких как ifnull, CASE WHEN, строковые функции, функции работы с датами, а также арифметические операции. Их можно использовать в предложении columns или SET.
6. Почему при предварительной фильтрации нельзя ссылаться на столбцы, значения которых заданы выражением?
Предварительная фильтрация может использовать только самостоятельные простые столбцы и не может использовать столбцы, полученные из выражений (например, b = tmp + 1). Чтобы ссылаться на такие столбцы, используйте последующую фильтрацию (WHERE).