Обзор Apache Doris
Apache Doris представляет собой высокопроизводительная аналитическая база данных реального времени на основе архитектуры MPP. Эффективная, простая и универсальная система возвращает результаты запросов к большим наборам данных менее чем за секунду. Одна система поддерживает как высокую конкурентность точечных запросов, так и сложную аналитику с высокой пропускной способностью.
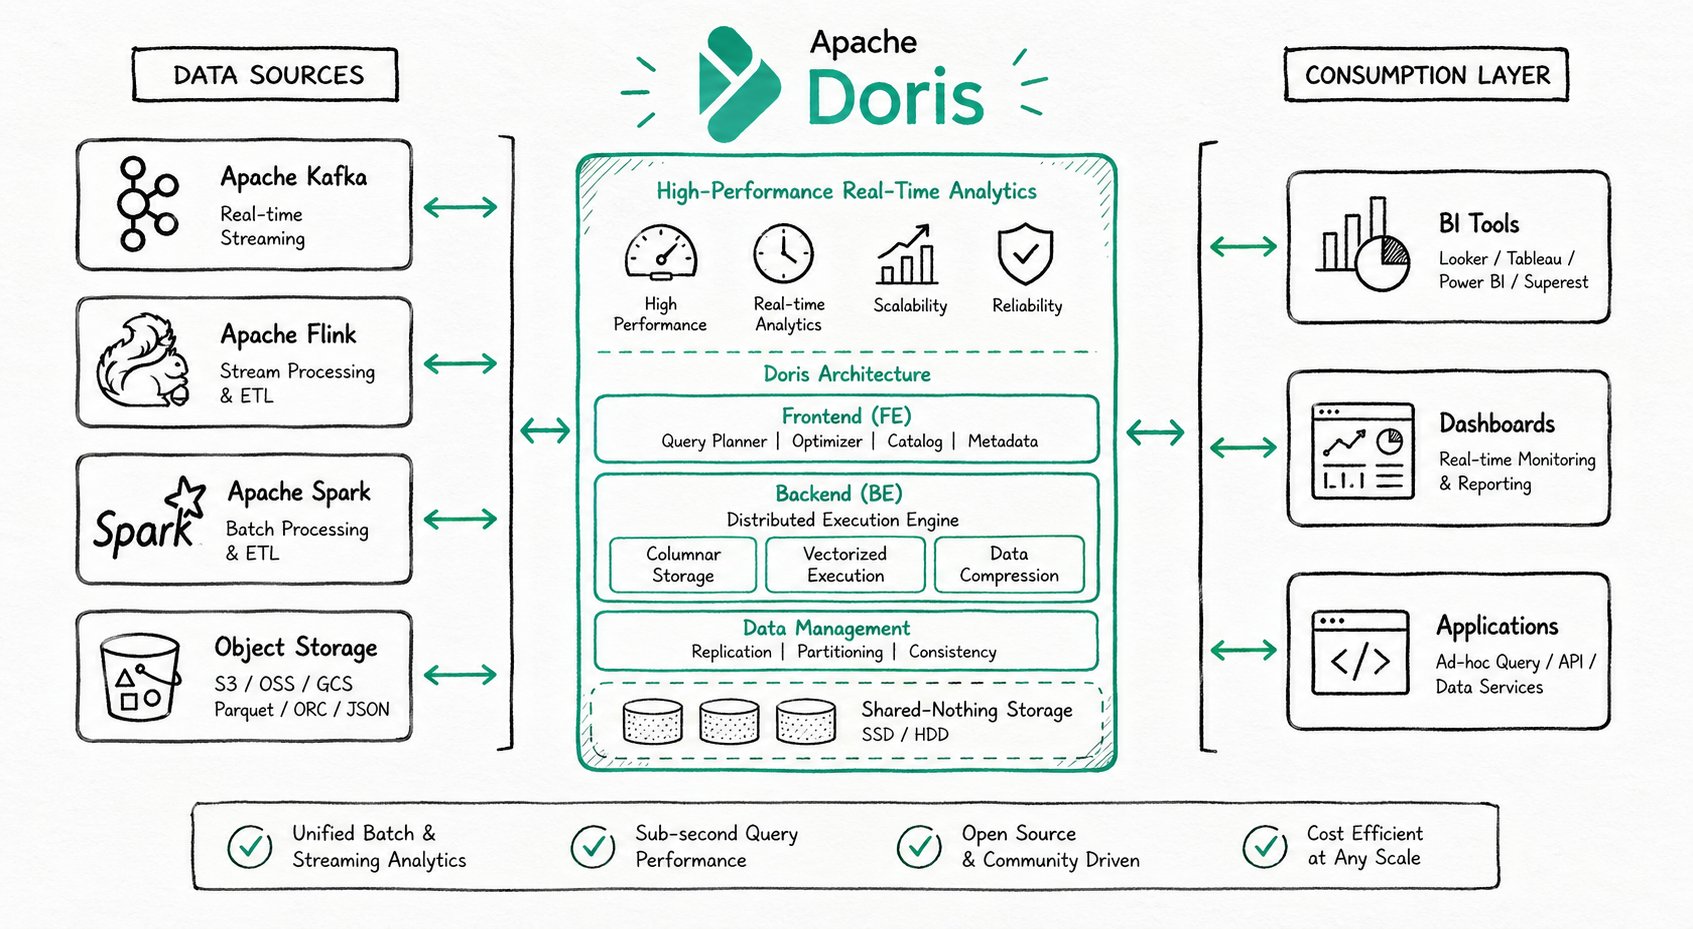
Основные возможности
| Возможность | Характеристики |
|---|---|
| Задержка запросов | < 1 секунды (ответ менее чем за секунду) |
| Задержка загрузки | На уровне секунд (загрузка данных в реальном времени) |
| Конкурентность | 10,000+ QPS |
| Объём хранения | На уровне PB / сотни машин в кластере |
| Интерфейс SQL | Уровень совместимости с протоколом MySQL, синтаксис ANSI SQL |
Типичные сценарии использования
Apache Doris широко используется в следующих трёх категориях сценариев:
Аналитика данных в реальном времени
Внутренние и внешние отчёты в реальном времени, панели мониторинга, анализ поведения пользователей, платформы A/B-тестирования, поиск и анализ журналов.
Примеры:
- Панели мониторинга в реальном времени: отслеживание объёма заказов в День холостяка с обновлением на уровне секунд
- Анализ профилей пользователей: сегментация аудитории и точный маркетинг
- Поиск и анализ журналов: устранение неполадок и оптимизация производительности
Аналитика озера данных и хранилища
Построение единого хранилища данных, ускорение федеративных запросов к озёрам данных и аналитика смешанных нагрузок.
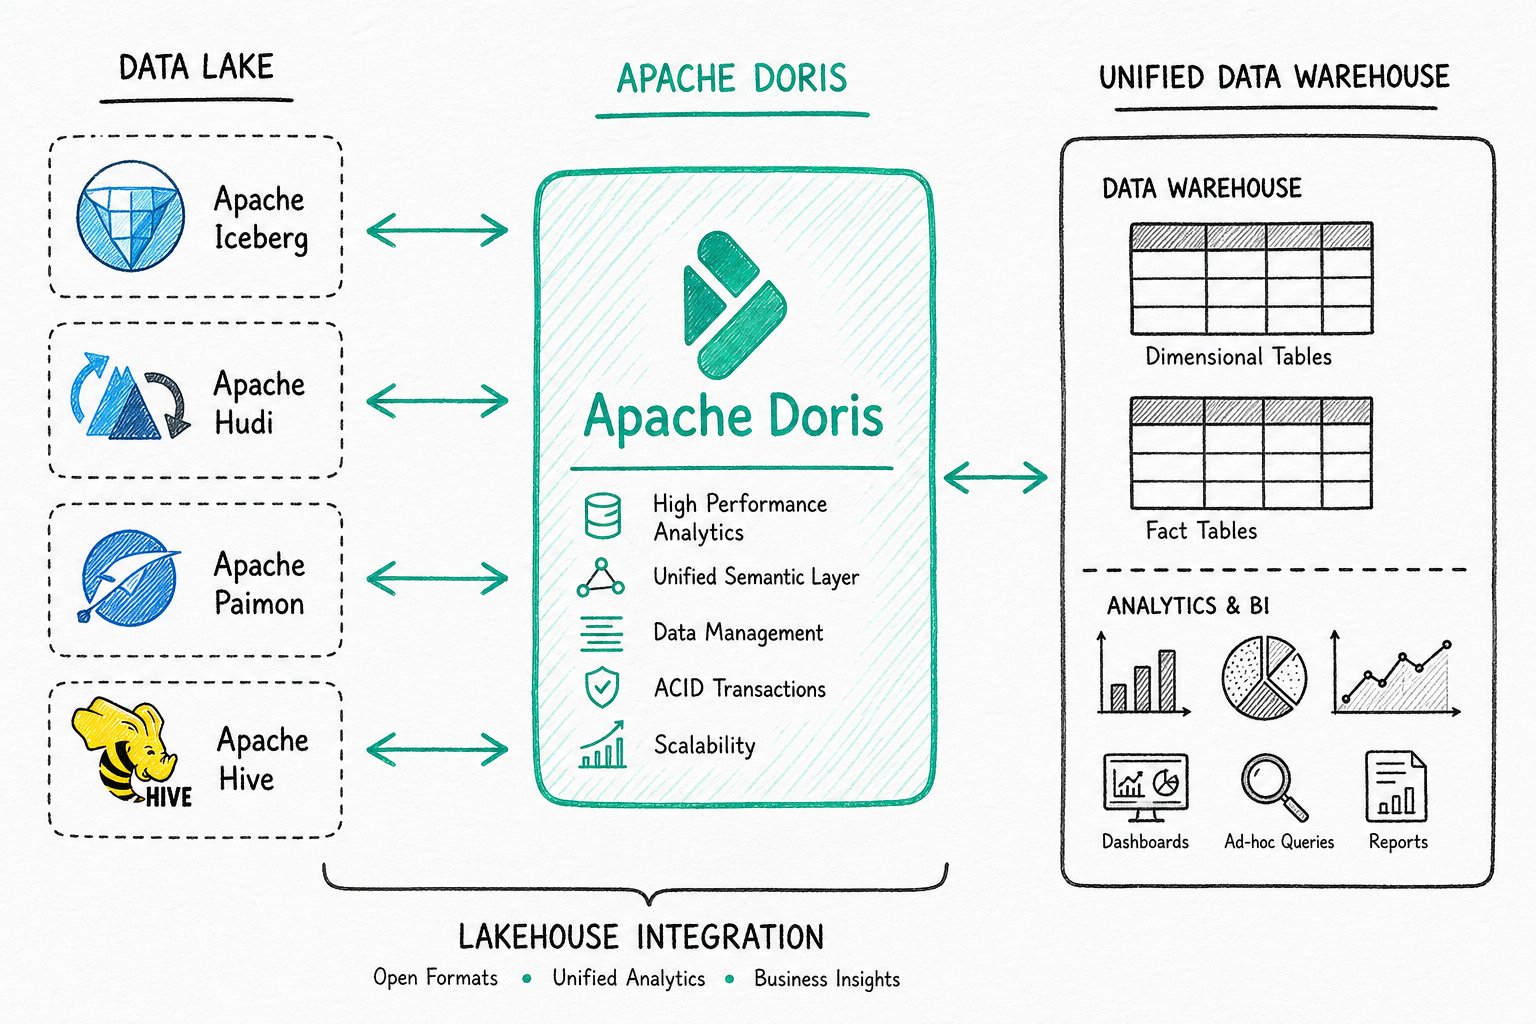
Гибридный поиск и аналитика (стек данных для ИИ)
Для работы с большими моделями Apache Doris объединяет полнотекстовый поиск, векторный поиск и функции ИИ, формируя полный стек данных для ИИ: от хранения до поиска и аналитики.
| Сценарий | Описание |
|---|---|
| Аналитика для ИИ-агентов | Принятие решений в реальном времени на уровне миллисекунд для ИИ-агентов (выявление мошенничества, интеллектуальные рекомендации) |
| Гибридный поиск и аналитика | Векторный поиск по сходству, фильтрация по ключевым словам и агрегатная аналитика в одном операторе SQL |
| Приложения RAG | Ответы на вопросы по корпоративной базе знаний, интеллектуальная поддержка клиентов и помощники по документам |
| Семантический поиск | Межъязыковой поиск, распознавание синонимов и понимание намерений |
| Наблюдаемость ИИ | Мониторинг обучения моделей, трассировка инференса и анализ журналов |
Архитектура системы
Apache Doris обладает высокой совместимостью с протоколом MySQL, поддерживает стандартный SQL, доступен через различные клиентские инструменты и интегрируется с инструментами BI. При развёртывании Apache Doris можно выбрать архитектуру с совместным хранением и вычислениями или архитектуру с разделением хранения и вычислений в зависимости от потребностей бизнеса.
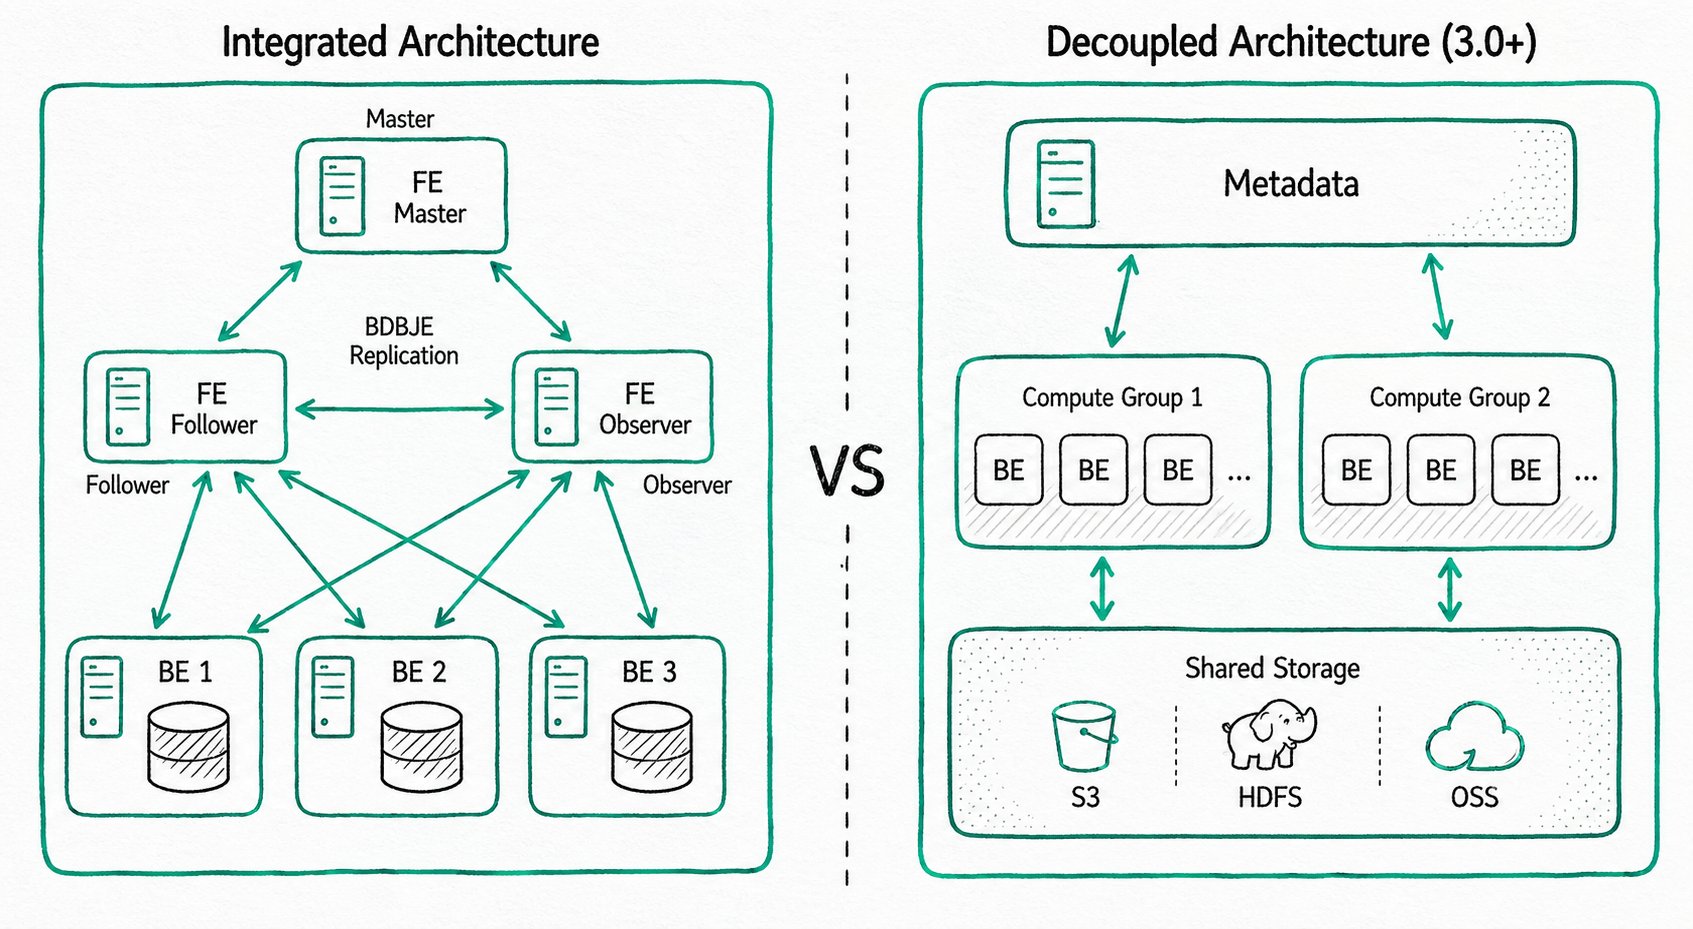
Архитектура с совместным хранением и вычислениями
Простая архитектура с двумя типами процессов:
- Frontend (FE): принимает запросы, разбирает их, управляет метаданными и узлами
- Backend (BE): хранит данные и выполняет запросы (с хранением нескольких реплик)
В промышленной среде для высокой доступности развёртывают несколько узлов FE. Узлы FE имеют три роли: Master, Follower и Observer.
Архитектура с разделением хранения и вычислений (общее хранилище)
Хранение и вычисления разделены, поэтому ёмкость хранилища и вычислительные ресурсы можно масштабировать независимо:
- Вычислительный уровень: несколько вычислительных групп, каждая из которых может обслуживать отдельного арендатора
- Уровень хранения: общее хранилище, например S3, HDFS или OSS
Как выбрать: если масштабы бизнеса умеренные и важна простота эксплуатации, выбирайте совместную архитектуру. Если требуется эластичное масштабирование, выбирайте раздельную архитектуру.
Технические особенности
Движок хранения
Apache Doris использует колоночное хранение: данные кодируются, сжимаются и читаются по столбцам. Это обеспечивает высокую степень сжатия и сокращает сканирование ненужных данных, позволяя эффективнее использовать ресурсы IO и CPU. Doris оптимизирован для сверхшироких таблиц (10,000+ столбцов), обеспечивая эффективное хранение и запросы к разреженным столбцам. Для разных сценариев Doris предоставляет несколько структур индексов (Sorted Compound Key, Min/Max, BloomFilter, инвертированный индекс, векторный индекс) и моделей хранения (Duplicate, Aggregate, Unique), а также поддерживает строго согласованные однотабличные материализованные представления и асинхронно обновляемые многотабличные материализованные представления.
- Колоночное хранение: кодирование, сжатие и чтение по столбцам; высокая степень сжатия и сокращение IO
- Несколько индексов: Sorted Compound Key, Min/Max, BloomFilter, инвертированный индекс, векторный индекс
- Модели хранения: Duplicate, Aggregate, Unique (поддерживает обновления на уровне строк)
- Материализованные представления: строго согласованные однотабличные и асинхронные многотабличные материализованные представления
Векторные и инвертированные индексы лежат в основе Hybrid Search (гибридного поиска и аналитики). Подробнее см. Обзор ИИ.
Движок запросов
Движок запросов Apache Doris основан на архитектуре MPP (Massively Parallel Processing) и поддерживает параллельное выполнение между узлами и внутри узла, а также распределённый Shuffle Join для нескольких больших таблиц. При сложных соединениях нескольких таблиц Doris использует глобальное планирование запросов, распределённые стратегии соединения и технологию Runtime Filter, чтобы значительно сократить передачу данных и ускорить соединения. Doris применяет векторизованное выполнение: все структуры в памяти имеют колоночную организацию, что сокращает вызовы виртуальных функций, повышает долю попаданий в кеш и эффективно использует инструкции SIMD, обеспечивая рост производительности в 5-10x при агрегации широких таблиц. В сочетании с Adaptive Query Execution (AQE) и движком выполнения Pipeline Doris динамически оптимизирует планы по статистике времени выполнения и использует возможности многоядерных CPU.
- Архитектура MPP: параллелизм между узлами и внутри узла, распределённый Shuffle Join для больших таблиц
- Векторизованное выполнение: колоночная организация в памяти, инструкции SIMD, рост производительности в 5-10x
- Adaptive Query Execution (AQE): Runtime Filter динамически оптимизирует соединения
- Движок Pipeline: параллелизм на многоядерных CPU с ограничением числа потоков для предотвращения их чрезмерного роста
Гибридный поиск (с поддержкой ИИ)
Apache Doris объединяет структурированную аналитику, полнотекстовый и векторный поиск в одном операторе SQL. Одна система выполняет векторный поиск по сходству, фильтрацию по ключевым словам и агрегатную аналитику без переноса данных или интеграции разнородных систем. В сочетании с типом VARIANT, который нативно поддерживает динамические структуры JSON, и механизмом Light Schema Change, позволяющим менять поля за секунды, Doris обеспечивает работу с данными для приложений RAG, семантического поиска и корпоративных баз знаний.
SELECT * FROM products
WHERE match(query_vector, 'summer breathable shoes')  -- Vector similarity search
  AND body MATCH 'breathable lightweight'           -- Full-text keyword search
  AND category_id = 1                                -- Structured filtering
GROUP BY brand
ORDER BY sales_count DESC;
- Единая архитектура: без переноса данных и разнородных систем
- Производительность гибридных запросов: один оператор SQL выполняет векторные операции, поиск по ключевым словам и агрегацию
- Тип VARIANT: нативная поддержка динамических структур JSON и изменение полей за секунды с Light Schema Change
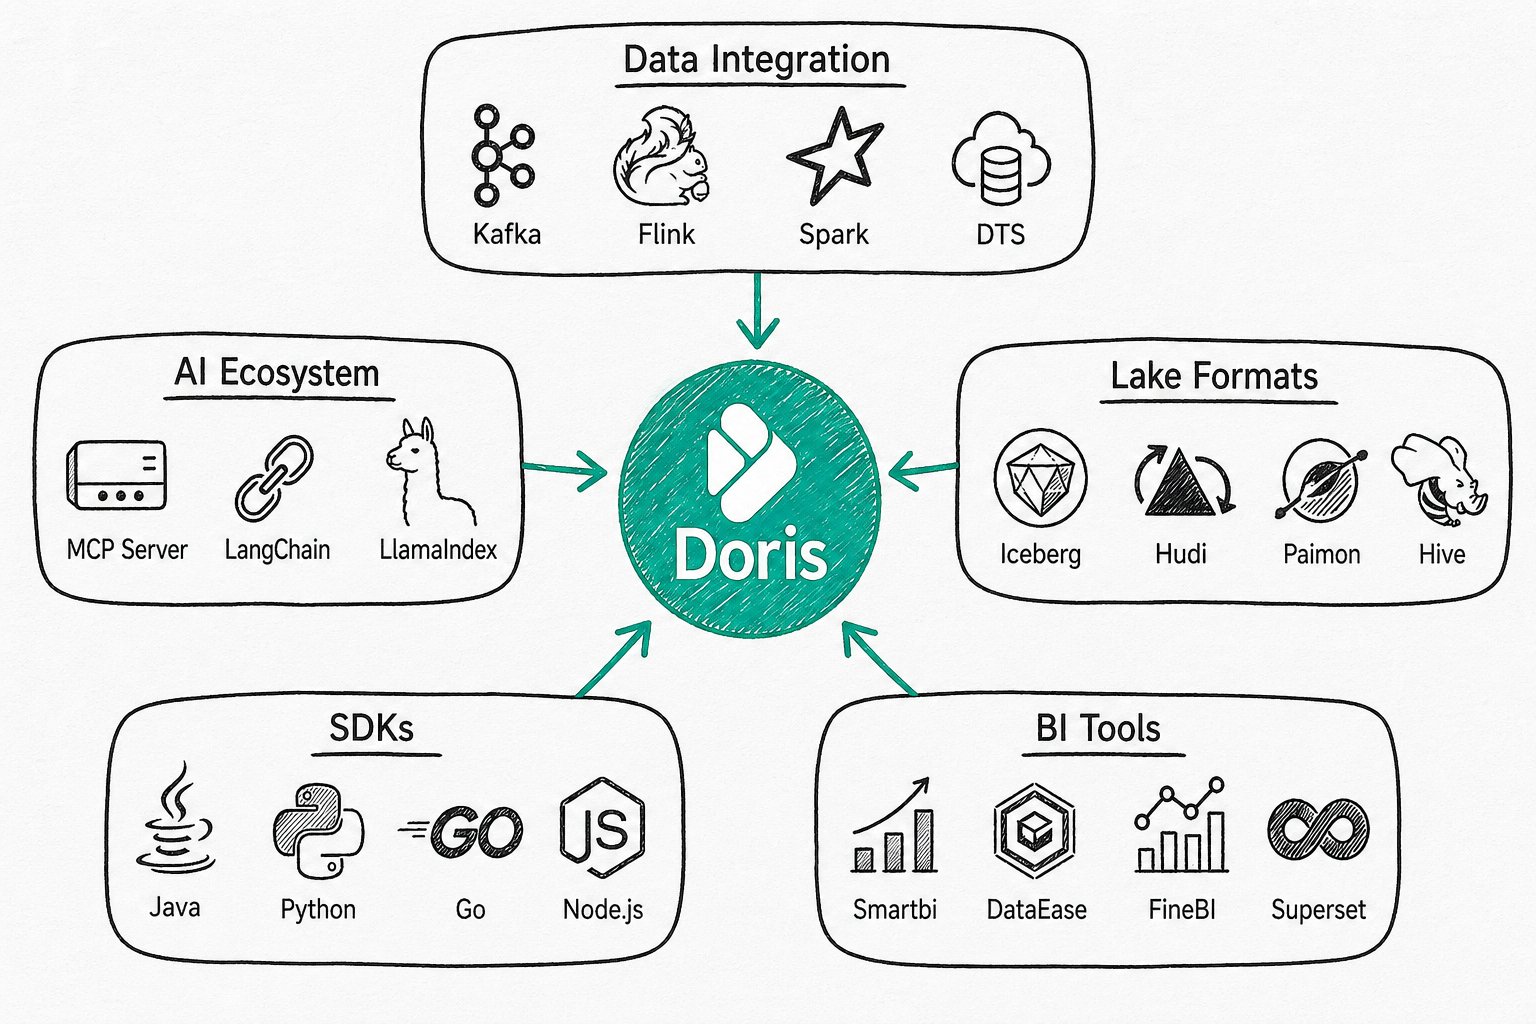
Интеграция с экосистемой
Apache Doris тесно интегрируется с основными экосистемами данных.
Сообщество и участие
Присоединяйтесь к сообществу: https://doris.apache.org/community/join-community