Аналитические функции
Кратко Аналитические функции Apache Doris (оконные функции) вычисляют значение для каждой строки результирующего набора, не сворачивая строки, как это делает
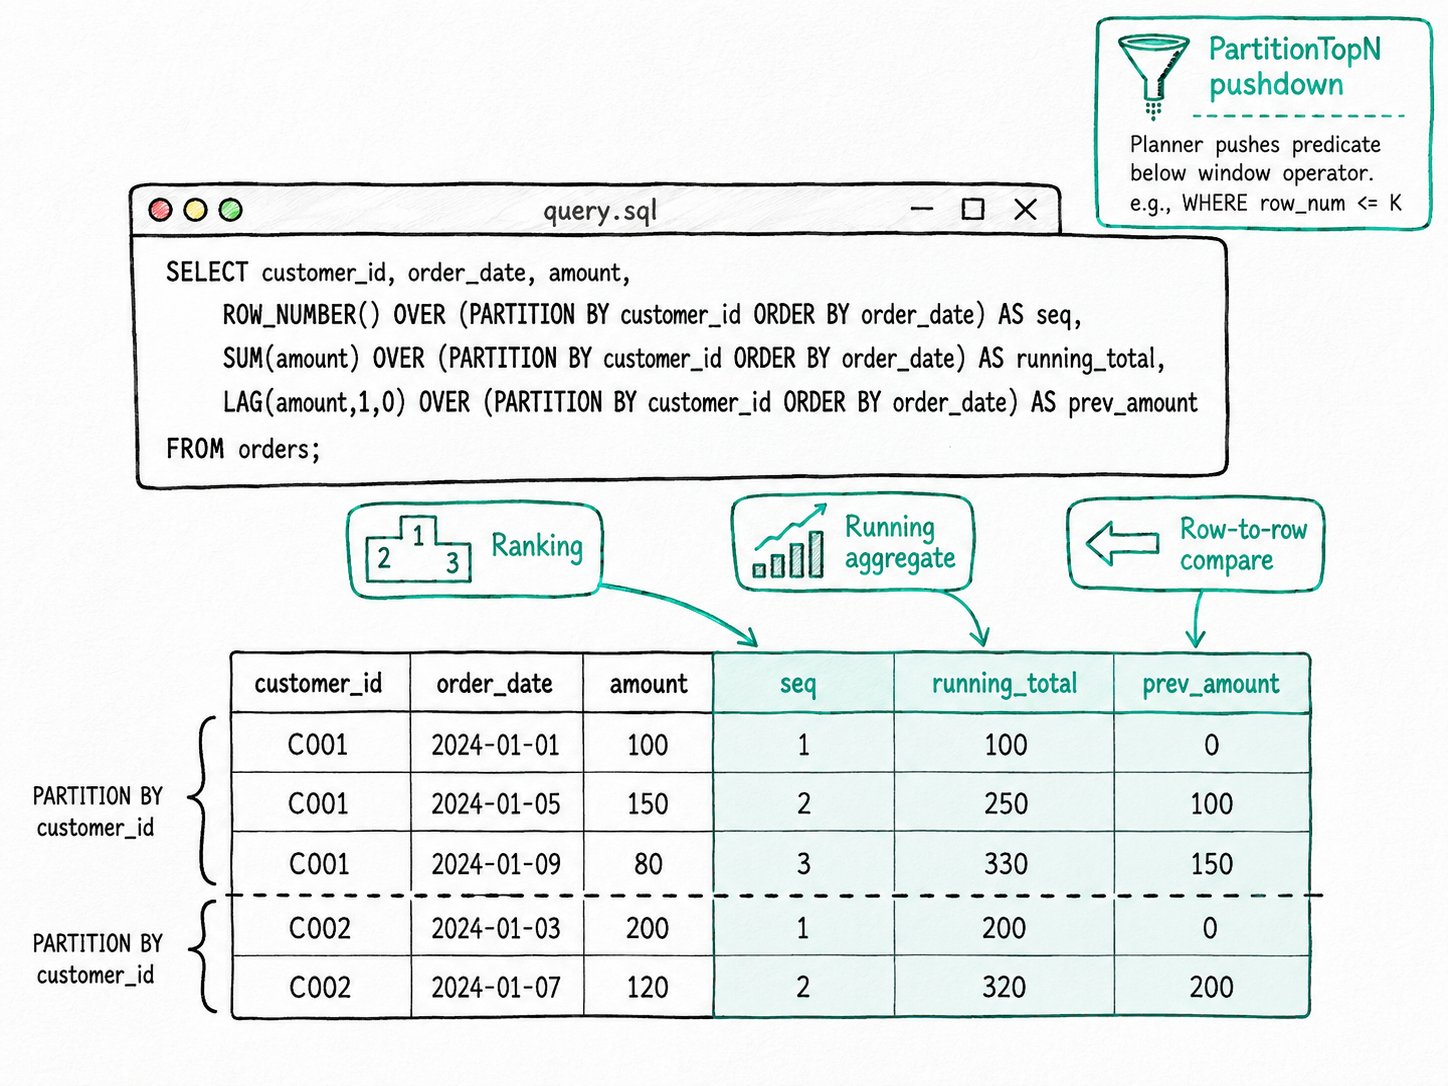
GROUP BY. Apache Doris поддерживает стандартный набор функций:ROW_NUMBER,RANK,DENSE_RANK,NTILE,LAG,LEAD,FIRST_VALUE,LAST_VALUE,NTH_VALUE,PERCENT_RANK,CUME_DIST, а также все агрегатные функции (SUM,AVG,COUNT,MIN,MAX), используемые сOVER. Оптимизатор Nereids также преобразуетWHERE row_num <= Kв Top-N с учётом секций, расположенный ниже оконного оператора, поэтому запрос «10 лучших в каждой категории» не сортирует секцию целиком.
Зачем использовать аналитические функции в Apache Doris?
Аналитические функции Apache Doris отвечают на три вопроса, которые возникают почти в любой аналитической нагрузке и на которые один лишь GROUP BY ответить не может.
- «Пронумеровать все заказы каждого клиента в хронологическом порядке, затем оставить первые 10». Самосоединение по
(customer_id, order_date)решает задачу, но требует дважды прочитать таблицу. - «Каким был накопительный итог продаж по дням и скользящее среднее за 7 дней?»
GROUP BYсворачивает строки, которые вы хотите сохранить в результате. - «Как каждая строка соотносится с предыдущей?» Сравнения год к году, период к периоду, интервалы между событиями относятся к шаблону lag/lead. Без оконных функций для этого потребуется самосоединение с условием смещения, которое планировщик не может оптимизировать.
Аналитические функции Apache Doris решают все три задачи за один проход по данным, без самосоединений и с сохранением исходных строк.
Что такое аналитические функции Apache Doris?
Аналитическая функция Apache Doris представляет собой функцию SQL, которая для каждой входной строки вычисляет значение по окну связанных строк, заданному предложением OVER. Окно может охватывать всю секцию, фиксированный диапазон вокруг текущей строки или любой промежуточный вариант. Число строк на выходе совпадает с числом строк на входе.
function(args) OVER ( [PARTITION BY ...] [ORDER BY ...] [<frame>] )
Основные термины
- Предложение
OVER: указывает Apache Doris, что этот вызов является оконной функцией, а не обычной агрегатной функцией. Обязательно. PARTITION BY: разбивает входные данные на независимые группы. Вычисления выполняются отдельно для каждой секции. В отличие от партиций таблицы, эти секции формируются во время выполнения запроса.ORDER BY(внутриOVER): упорядочивает строки в каждой секции. Необходимо дляLAG,LEAD,ROW_NUMBER,RANKи любой рамки окна сPRECEDING/FOLLOWING.- Рамка окна: часть секции, которую функция читает для текущей строки. Apache Doris поддерживает
ROWS BETWEEN ... PRECEDING/FOLLOWING/CURRENT ROW/UNBOUNDED ...и ограниченную формуRANGE. - PartitionTopN: внутренний оператор, который планировщик добавляет, когда может доказать, что фильтру
WHERE rank <= Kнужны только первые K строк каждой секции. Исходный код:CreatePartitionTopNFromWindow.java.
Как работают аналитические функции Apache Doris?
Аналитические функции Apache Doris проходят пять этапов: планирование, перераспределение данных, сортировку, вычисление и проталкивание.
- Планирование. Оптимизатор разбирает предложение
OVERвWindowExpression, нормализует рамку окна (CheckAndStandardizeWindowFunctionAndFrame) и объединяет вызовы оконных функций с одинаковымиPARTITION BYиORDER BYв один физический оконный оператор. Вызовы с одинаковым секционированием и порядком строк не требуют дополнительной сортировки. - Перераспределение по секциям. Если присутствует
PARTITION BY, движок перераспределяет строки так, чтобы все строки одной секции попали на один бэкенд. БезPARTITION BYвсё окно обрабатывается в одном конвейере, что задаёт верхнюю границу параллелизма. - Сортировка внутри секции. Каждый бэкенд сортирует свои секции по столбцам
ORDER BY. Если значения совпадают, порядок строк недетерминирован, если толькоORDER BYне задаёт уникальный порядок. Поэтому документация предупреждает, чтоSUM() OVER (ORDER BY date_col)может возвращать разные результаты при совпадающих датах. - Вычисление для каждой строки. Apache Doris проходит каждую секцию один раз, по ходу обновляя рамку окна. Функции ранжирования выдают по одному целому числу для каждой строки; агрегатные функции с
ROWS UNBOUNDED PRECEDINGподдерживают накопительный итог; агрегатные функции со скользящим окном добавляют новую строку и исключают строку, вышедшую за заднюю границу окна. - Проталкивание фильтров и Top-N.
CreatePartitionTopNFromWindowпреобразуетWHERE row_number() OVER (PARTITION BY a ORDER BY b) <= Kв операторPartitionTopN(K)ниже оконного оператора, поэтому из каждой секции в оконный оператор поступают только первые K строк.PushDownFilterThroughWindowпереносит фильтры по столбцамPARTITION BYперед оконным оператором, поэтому Apache Doris фильтрует данные до сортировки, а не после неё.
Быстрый старт
CREATE TABLE orders (
  customer_id INT, order_date DATE, amount DECIMAL(10,2)
) DISTRIBUTED BY HASH(customer_id) BUCKETS 4
PROPERTIES ("replication_num" = "1");

INSERT INTO orders VALUES
  (1,'2026-04-30',50),(1,'2026-05-01',80),(1,'2026-05-02',30),
  (2,'2026-04-30',20),(2,'2026-05-01',90);

SELECT customer_id, order_date, amount,
       ROW_NUMBER() OVER (PARTITION BY customer_id ORDER BY order_date) AS seq,
       SUM(amount)  OVER (PARTITION BY customer_id ORDER BY order_date) AS running_total,
       LAG(amount,1,0) OVER (PARTITION BY customer_id ORDER BY order_date) AS prev_amount
FROM orders;
Ожидаемый результат
+-------------+------------+--------+-----+---------------+-------------+
| customer_id | order_date | amount | seq | running_total | prev_amount |
+-------------+------------+--------+-----+---------------+-------------+
|           1 | 2026-04-30 |     50 |   1 |            50 |           0 |
|           1 | 2026-05-01 |     80 |   2 |           130 |          50 |
|           1 | 2026-05-02 |     30 |   3 |           160 |          80 |
|           2 | 2026-04-30 |     20 |   1 |            20 |           0 |
|           2 | 2026-05-01 |     90 |   2 |           110 |          20 |
+-------------+------------+--------+-----+---------------+-------------+
Один проход, три столбца с результатами оконных функций, без самосоединений. Исходные пять строк сохранены. LAG(..., 1, 0) возвращает 0 вместо NULL для первой строки каждой секции.
Когда следует использовать аналитические функции Apache Doris?
Аналитические функции Apache Doris подходят для любых вычислений, которые сохраняют строки и зависят от соседних строк, включая Top-N по группам, накопительные итоги, сравнения lag/lead, разбиение на группы для отчётов по перцентилям и расчёт доли от общего итога.
Подходящие задачи
- Top-N по группам: «10 крупнейших заказов каждого клиента», «самый продаваемый товар в каждом регионе». Добавьте фильтр
WHERE rn <= 10, и Apache Doris протолкнёт Top-N по секциям ниже оконного оператора. - Накопительные итоги, скользящие средние и центрированные скользящие средние с
ROWS BETWEEN n PRECEDING AND m FOLLOWING. - Анализ изменений год к году, день ко дню и интервалов между событиями с помощью
LAGиLEAD. Один проход по таблице заменяет самосоединение. - Разбиение на группы для отчётов по перцентилям или квартилям с помощью
NTILE. - Отчётные запросы, которые сочетают значения отдельных строк с итогами по всей секции, например
amount / SUM(amount) OVER (PARTITION BY region) AS share_of_region.
Неподходящие задачи
- Обычная агрегация со сворачиванием строк.
SELECT category, SUM(amount) FROM t GROUP BY categoryвыполняет ту же работу без сортировки и без хранения каждой строки в памяти. Сначала используйтеGROUP BYи переходите кOVER, только если вам также нужны неагрегированные столбцы. - Рамки
RANGEс числовыми смещениями, напримерRANGE BETWEEN 5 PRECEDING AND CURRENT ROW. В Apache Doris рамкаRANGEограничена границамиUNBOUNDEDилиCURRENT ROW; произвольное смещениеRANGE n PRECEDING/FOLLOWINGне поддерживается. Если нужно числовое смещение, используйтеROWS. - Окно без
PARTITION BY. Весь результирующий набор попадает в один конвейер, который становится узким местом при большом объёме входных данных. Добавляйте ключ секционирования всякий раз, когда это позволяет задача. ORDER BYпо неуникальному столбцу, когда важен детерминированный результат.SUM(x) OVER (ORDER BY day)может возвращать разные накопительные итоги при повторных запусках, если несколько строк относятся к одному дню. Добавьте дополнительный критерий сортировки для строк с одинаковыми значениями; см. Обзор оконных функций.- Повторное вычисление одного и того же оконного результата при каждом обновлении. Если один и тот же запрос с
ROW_NUMBER()выполняется каждую минуту по таблице с редко изменяющимися данными, асинхронное материализованное представление с частичным обновлением потребует меньше ресурсов, чем повторное выполнение оконных вычислений.
Дополнительные материалы
- Аналитические функции (оконные функции): полное руководство с разобранными примерами
- Обзор оконных функций: синтаксис, предложения рамки окна и оговорка об уникальном порядке
LAG,LEAD,ROW_NUMBER,RANK,NTILE: справочные страницы отдельных функций- Конвейерный движок выполнения: как обработка секционированных окон распараллеливается между BE
- Векторизованное выполнение: движок, который обрабатывает пакет данных каждого окна с помощью операторов с ускорением SIMD.
- Асинхронное материализованное представление: предварительное вычисление оконных результатов, которые пересчитываются каждую минуту
- Архитектура MPP: как данные для оконных и аналитических операторов перераспределяются и разбиваются на секции между BE.