Интеграции Catalog
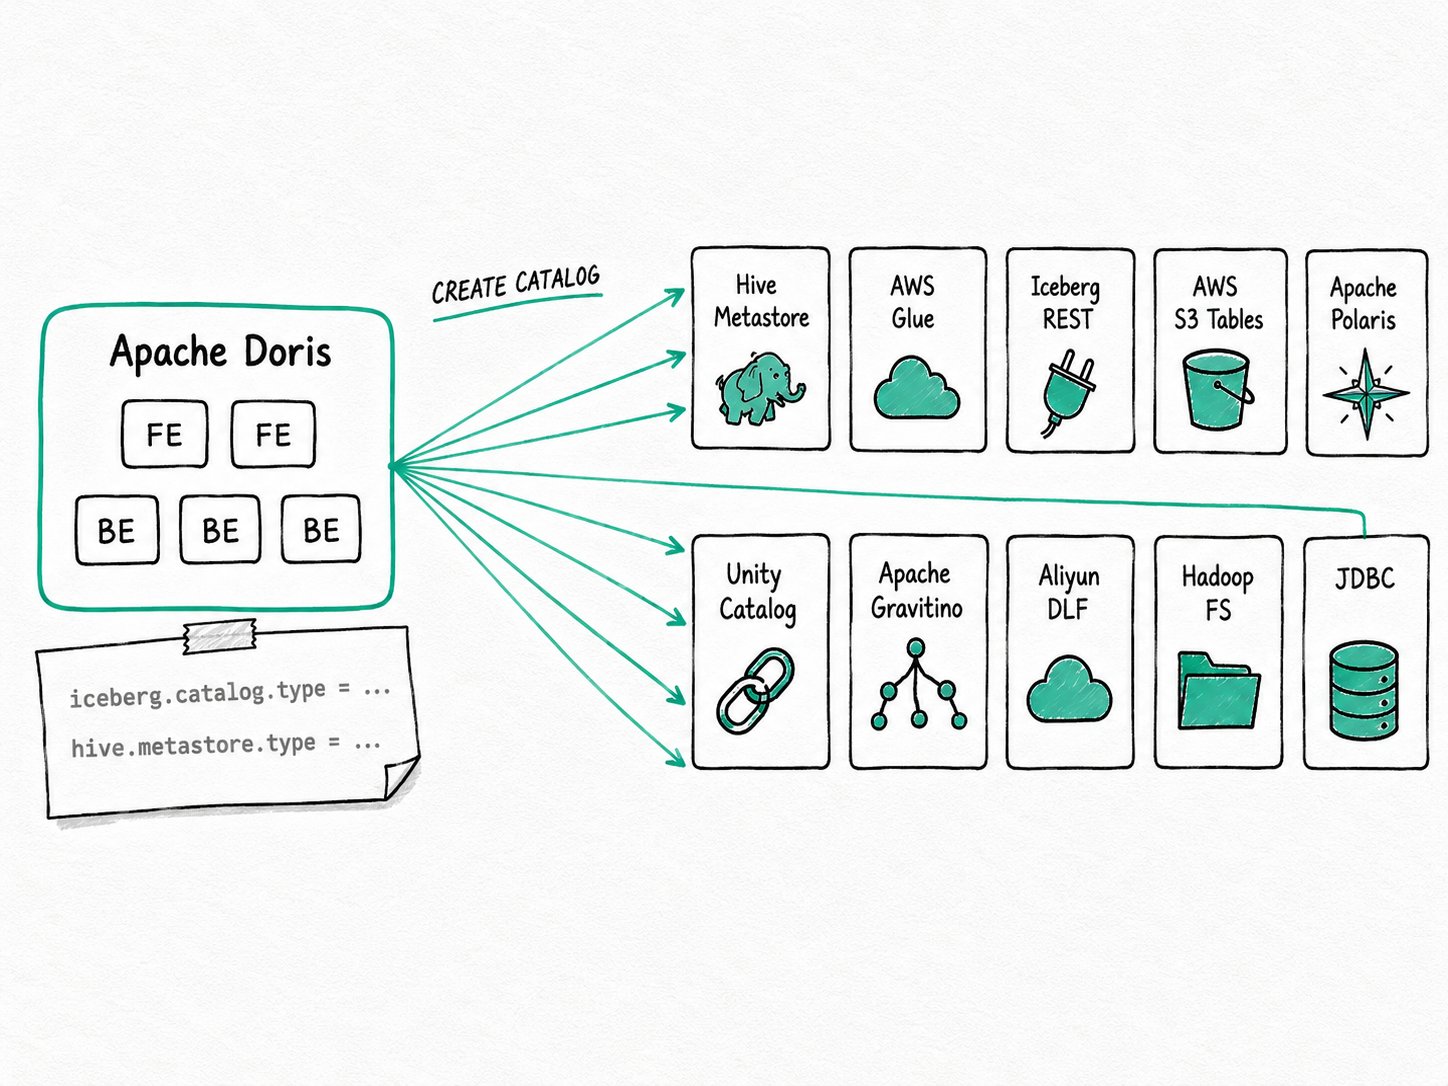
Кратко Интеграции Catalog в Apache Doris охватывают большинство сервисов каталогов, которые уже используются в lakehouse: Hive Metastore, AWS Glue, спецификацию Iceberg REST (Tabular, Polaris, Lakekeeper, Snowflake Open Catalog, Gravitino, Unity), AWS S3 Tables, Aliyun DLF, файловый Hadoop и бэкенд JDBC. Каждый бэкенд подключается одной командой
CREATE CATALOGи выбирается с помощьюiceberg.catalog.typeилиhive.metastore.type. После указания учётных данных и warehouse один и тот же SQL работает с любым из них.
Зачем использовать интеграции Catalog в Apache Doris?
Интеграции Catalog в Apache Doris позволяют одному движку поддерживать все распространённые протоколы каталогов lakehouse, поэтому выбор хранилища метаданных не определяет выбор слоя выполнения запросов. Выбор каталога редко зависит от аналитического движка. Хранилище метаданных обычно приходит из другой системы: кластера Hadoop, где много лет назад выбрали Hive Metastore; аккаунта AWS, в котором стандартом стал Glue; платформенной команды, только что внедрившей Polaris; рабочего пространства Databricks, использующего Unity. Если движок запросов поддерживает лишь один из этих вариантов, приходится создавать слой преобразования или ограничивать озеро данных возможностями движка.
Apache Doris предлагает другой подход: поддерживать разные каталоги и сохранять единый SQL. Вы вводите CREATE CATALOG, выбираете тип и получаете SHOW DATABASES, SELECT, соединения, запись и time travel для одной и той же таблицы Iceberg или Hive независимо от того, где хранятся метаданные. Добавьте к этому федерацию нескольких Catalog и единый кеш метаданных, и вы сможете управлять таблицами озера данных на всех этапах их жизненного цикла.
- Один движок для множества хранилищ метаданных. Не нужно поддерживать отдельный слой выполнения запросов для каждого каталога.
- Новые сервисы каталогов подключаются как очередной тип бэкенда. Iceberg REST, S3 Tables, Polaris и Unity используют одну и ту же основу подключения.
- Для перехода с устаревшего хранилища метаданных достаточно
CREATE CATALOG, без смены платформы.
Что такое интеграция Catalog в Apache Doris?
Интеграция Catalog в Apache Doris — это драйвер бэкенда, который связывает интерфейс внешнего Catalog с конкретным сервисом метаданных. Для таблиц Iceberg тип выбирается с помощью iceberg.catalog.type; для таблиц в стиле Hive используются type = 'hms' и hive.metastore.type. Учётные данные для доступа к хранилищам (S3, OSS, COS, HDFS) настраиваются поверх выбранного Catalog.
Сейчас доступны следующие бэкенды:
- Hive Metastore (
hms): давно используемый сервис Thrift с простой аутентификацией или Kerberos для таблиц Hive, Iceberg и Paimon. - AWS Glue (
glue): управляемый AWS каталог, совместимый с Hive. Доступен как бэкенд Hive (hive.metastore.type=glue), через нативный клиент Iceberg Glue (iceberg.catalog.type=glue) или через конечную точку Iceberg REST в Glue при работе с S3 Table Bucket. - Iceberg REST (
rest): открытая спецификация Iceberg REST Catalog. Один и тот же бэкенд поддерживает сервисы в стиле Tabular, Apache Polaris, Lakekeeper, Snowflake Open Catalog, Apache Gravitino и конечную точку Iceberg REST в Databricks Unity. - AWS S3 Tables (
s3tables): управляемый AWS каталог Iceberg, привязанный к Table Bucket; также доступен через конечную точку REST в Glue с подписью SigV4. - Aliyun DLF (
dlf): Data Lake Formation 1.0 через интерфейс, совместимый с HMS, для Iceberg и Hive; DLF 2.5+ через REST для Paimon. - Файловая система Hadoop (
hadoop): метаданные Iceberg в файлах без демона хранилища метаданных; подходит для автономных warehouse. - Каталог JDBC (
jdbc): метаданные Iceberg хранятся в базе данных SQL (Postgres, MySQL); подходит, когда нужно транзакционное хранилище метаданных без запуска отдельного сервиса. - Unity Catalog: доступен через бэкенд Iceberg REST с OAuth2 и vended credentials.
Основные термины
type: семейство Catalog. Например,iceberg,hms,paimon,hudi,jdbcи другие.iceberg.catalog.type: драйвер хранилища метаданных в семействе Iceberg. Один из следующих:hms,rest,glue,dlf,jdbc,hadoop,s3tables.hive.metastore.type: аналогичный переключатель для Catalog в стиле Hive.hms(по умолчанию),glueилиdlf.- Vended credentials: возможность Apache Doris запрашивать у каталога REST краткосрочные учётные данные для доступа к хранилищу отдельно для каждой таблицы, чтобы не прописывать AK вручную в свойствах Catalog.
- Warehouse: корневой каталог хранилища, в котором каталог создаёт новые таблицы. Обязателен для
hadoop, необязателен для большинства остальных бэкендов.
Как работает интеграция Catalog в Apache Doris?
Интеграция Catalog в Apache Doris направляет обращения к метаданным через драйвер бэкенда, выбранный при выполнении CREATE CATALOG, а затем выполняет чтение и запись через тот же единый слой доступа к хранилищу, который уже используют BE.
- Выбор бэкенда. В Apache Doris фабрика
IcebergExternalCatalogFactoryпроверяетiceberg.catalog.typeи создаёт экземплярIcebergHMSExternalCatalog,IcebergGlueExternalCatalog,IcebergRestExternalCatalog,IcebergDLFExternalCatalog,IcebergJdbcExternalCatalog,IcebergHadoopExternalCatalogилиIcebergS3TablesExternalCatalog. Catalog семейства Hive маршрутизируют обращения аналогичным образом через драйверhmsиhive.metastore.type. - Получение метаданных. Выбранный бэкенд обрабатывает
SHOW DATABASES, получение схем, поиск снимков и получение списка разделов через собственный протокол (Thrift для HMS, AWS SDK для Glue, HTTP для REST). - Настройка доступа к хранилищу. Любые переданные параметры доступа (
s3.access_key,oss.endpoint, vended credentials из каталога REST) поступают в единый слой доступа к хранилищу, который BE используют для чтения файлов Parquet, ORC или Avro. - Кеширование для ускорения. Схемы, объекты таблиц, манифесты и представления кешируются отдельно для каждого Catalog с использованием ключей
meta.cache.iceberg.*. Модель вытеснения описана в разделе Кеш метаданных. - Планирование и выполнение. Далее используется тот же конвейер MPP, что и для внутренних запросов Apache Doris, с тем же кешем данных, переписыванием запросов с использованием материализованных представлений и векторизованным выполнением.
Быстрый старт
-- Connect to an Iceberg REST catalog (Polaris, Lakekeeper, Tabular,
-- Snowflake Open Catalog, Unity, or any spec-compatible service).
CREATE CATALOG iceberg_rest PROPERTIES (
  'type' = 'iceberg',
  'iceberg.catalog.type' = 'rest',
  'iceberg.rest.uri' = 'https://catalog.example.com/api/catalog',
  'warehouse' = 'analytics',
  'iceberg.rest.security.type' = 'oauth2',
  'iceberg.rest.oauth2.credential' = 'client_id:client_secret',
  'iceberg.rest.vended-credentials-enabled' = 'true',
  's3.endpoint' = 'https://s3.us-west-2.amazonaws.com',
  's3.region' = 'us-west-2'
);

SWITCH iceberg_rest;
SELECT region, SUM(amount) FROM sales.orders WHERE dt = '2026-05-01' GROUP BY region;
Ожидаемый результат
+--------+-----------+
| region | sum       |
+--------+-----------+
| us     | 184320.50 |
| eu     |  91200.00 |
+--------+-----------+
SHOW CATALOGS выводит iceberg_rest рядом с internal. Та же структура запроса работает после замены блока PROPERTIES на настройки бэкенда Glue, HMS или S3 Tables; меняется только блок подключения.
Когда стоит использовать интеграции Catalog в Apache Doris?
Используйте интеграции Catalog в Apache Doris, когда метаданные lakehouse уже находятся во внешнем сервисе и вам нужен единый движок для чтения и записи без перемещения данных.
Подходит
- Существующее озеро данных уже использует Hive Metastore, Glue, DLF или сервис Iceberg REST, и вы хотите читать и записывать данные с помощью Apache Doris без их перемещения.
- Работа с несколькими регионами или поставщиками, например чтение каталога Glue в одном аккаунте и соединение с данными каталога Polaris в другом. Возможности федерации описаны в разделе Работа с несколькими Catalog.
- Миграции между сервисами каталогов. Подключите старый и новый сервисы как отдельные Catalog, работайте с ними параллельно и переключитесь, когда будете готовы.
- Облачные развёртывания, которым нужны vended credentials, чтобы движок никогда не получал долгосрочные ключи доступа к хранилищу.
- Файловые озёра Iceberg или озёра Iceberg для одного арендатора, где запуск демона хранилища метаданных избыточен: бэкенд
hadoopчитает метаданные прямо из файловой системы.
Не подходит
- Операционные хранилища метаданных, такие как Confluent Schema Registry. Они описывают форматы передачи данных, а не таблицы.
- Использование Apache Doris в качестве основного источника метаданных озера. Изменения записываются в подключённый каталог, но сам Apache Doris каталогом не является; для таблиц, которыми полностью управляет Apache Doris, используйте Catalog
internal. - Чтение необработанных файлов при полном отсутствии каталога. Используйте табличные функции (
s3(),hdfs(),local()), вместо того чтобы развёртывать пустой каталог.
Дополнительные материалы
- Работа с несколькими Catalog: слой федерации, позволяющий выполнять соединения между подключёнными здесь Catalog.
- Управление таблицами озера данных: запись, эволюция схемы и жизненный цикл таблиц Iceberg и Hive после подключения Catalog.
- Iceberg Catalog: справочник по свойствам, матрица версий и таблица поддерживаемых возможностей для каждого бэкенда.
- AWS Glue, Iceberg REST Catalog, Hive Metastore, Aliyun DLF: подробные руководства по подключению каждого бэкенда с примерами.
- Обзор Catalog: общие свойства (
include_database_list, чувствительность к регистру, обновление), применимые ко всем бэкендам. - Кеш метаданных: модель кеширования, которая ускоряет повторные запросы и сохраняет актуальность данных.
- Iceberg: возможности движка Doris, доступные при использовании любого из семи бэкендов каталогов Iceberg.