Вычислительная группа
Кратко Compute Group в Apache Doris представляет собой аналог Resource Group для архитектуры с разделением хранения и вычислений. Вы разбиваете узлы BE на именованные группы, предоставляете пользователям доступ и привязываете каждый сеанс к группе; запрос обслуживают только BE этой группы. Поскольку хранилище общее (S3, OSS, COS, HDFS), добавление группы требует затрат на вычислительные ресурсы, а не на дополнительную реплику. Сбой BE в одной группе не затрагивает остальные, а вывод из эксплуатации целой группы оставляет данные без изменений.
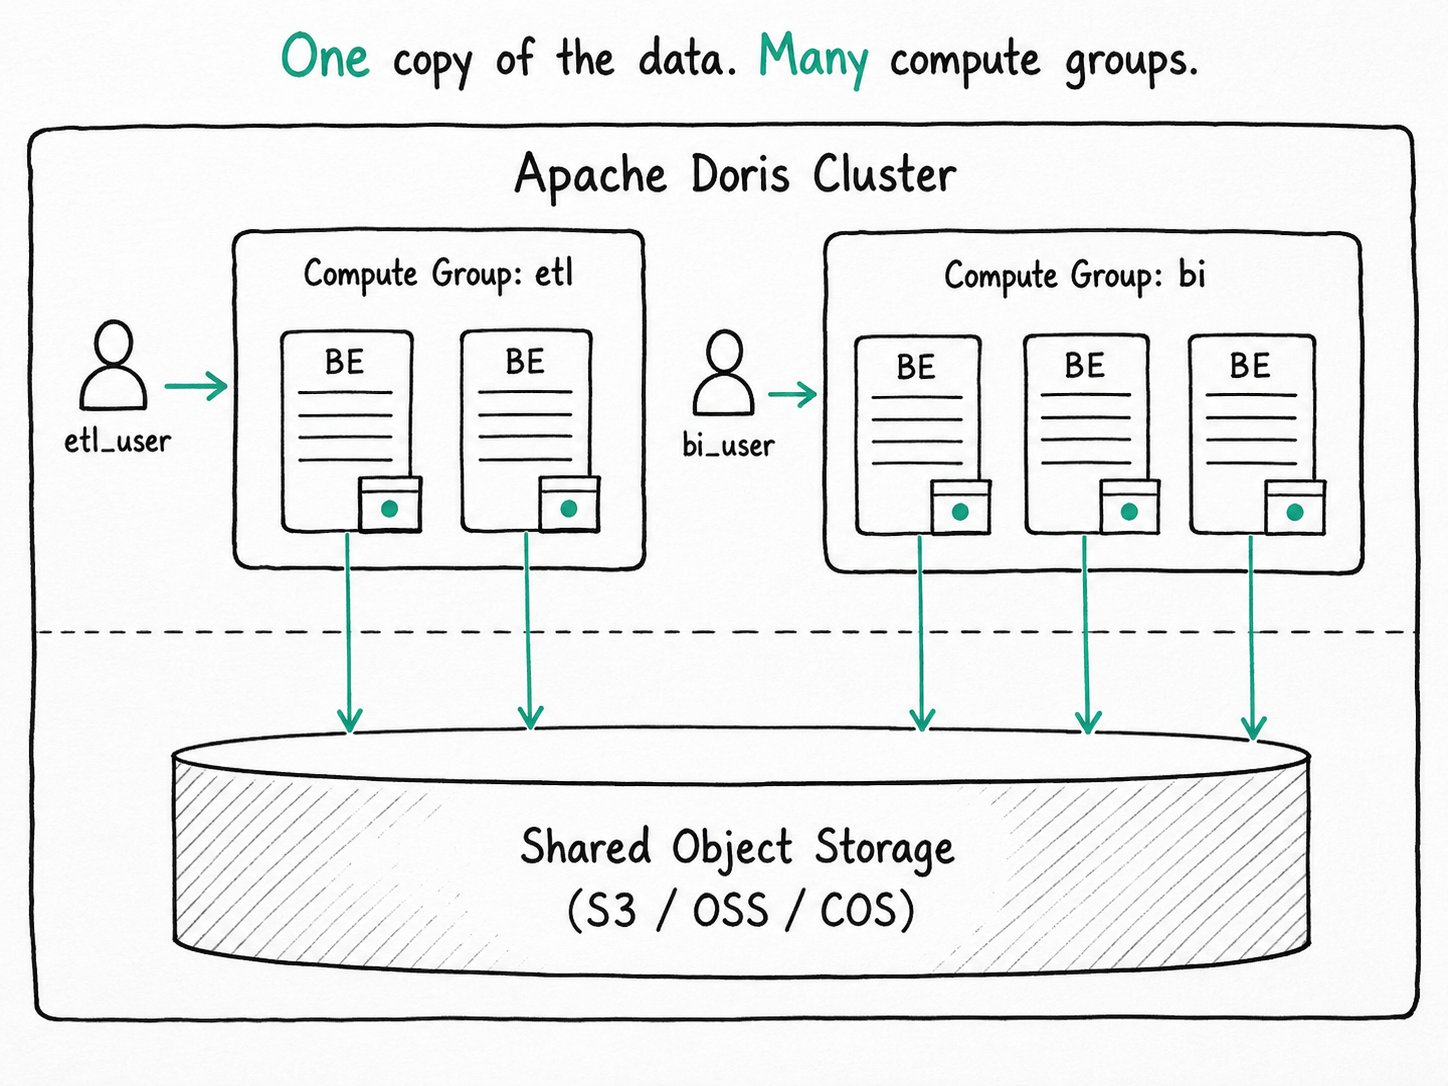
Зачем использовать вычислительные группы Apache Doris?
Вычислительные группы Apache Doris обеспечивают изоляцию рабочих нагрузок на уровне BE без многократного увеличения объёма хранения, поскольку все группы читают данные из одного общего объектного хранилища. Resource Group обеспечивает изоляцию на уровне BE в режиме с совмещёнными вычислениями и хранением, но за это приходится платить объёмом хранения. Если пяти группам нужно читать одну и ту же таблицу, потребуется пять реплик этой таблицы. Два новых арендатора означают необходимость перераспределить реплики. Чтобы развернуть временный пул для завтрашнего пакетного задания, сначала придётся переместить данные.
В развёртывании с разделением хранения и вычислений BE не хранит состояние. Для ускорения работы он локально кэширует часто используемые tablet, но достоверные данные находятся в общем объектном хранилище. Поэтому добавление ещё одного набора BE означает лишь затраты на вычислительные ресурсы и необходимость прогреть холодный кэш. Существует одна логическая копия данных независимо от того, сколько вычислительных групп её читают.
Compute Group превращает это свойство в механизм изоляции рабочих нагрузок. Вы разделяете BE на группы, как и при использовании Resource Group, но расходы на хранение больше не растут с числом групп. Разверните пул ETL на время загрузки, запускайте BI в другом пуле, на который эта загрузка не влияет, выведите группу из эксплуатации в полночь. Данные при этом не перемещаются.
Что такое вычислительная группа Apache Doris?
Вычислительная группа Apache Doris представляет собой базовый механизм изоляции на уровне узлов в режиме с разделением хранения и вычислений (облачном режиме). Каждый BE принадлежит ровно одной вычислительной группе, определяемой по имени. Все группы используют один и тот же манифест объектного хранилища, поэтому добавление группы означает добавление вычислительных ресурсов и кэша, который нужно прогреть, а не реплики. Workload Group работает внутри вычислительной группы и распределяет CPU и память между выполняемыми в ней запросами.
Основные термины
tag.compute_group_name: свойство BE, задаваемое при добавлении backend. Если не указано, по умолчанию используетсяdefault_compute_group.default_compute_group: пользовательское свойство, определяющее вычислительную группу для новых сеансов. Задаётся командойSET PROPERTY FOR '<user>' 'default_compute_group' = '<name>'.USE @<group>: команда переключения активной группы для текущего сеанса подключения; её также можно использовать с именем базы данных (USE my_db@<group>).USAGE_PRIV ON COMPUTE GROUP: право доступа. Предоставляется командойGRANT USAGE_PRIV ON COMPUTE GROUP <name> TO <user>. Без него пользователь не может выбрать группу.- Файловый кэш: локальный кэш блоков часто используемых tablet на BE. Новая группа начинает работу с холодным кэшем, и до его прогрева каждый промах требует сетевого обращения к объектному хранилищу.
Как работает вычислительная группа Apache Doris?
Вычислительная группа Apache Doris помечает каждый BE тегом при регистрации, предоставляет определённым пользователям USAGE_PRIV, привязывает сеансы к группе через свойство по умолчанию или команду USE @<group> и ограничивает размещение фрагментов запроса узлами BE этой группы. Все группы при этом используют общее объектное хранилище.
- Задайте теги BE при регистрации.
ALTER SYSTEM ADD BACKEND 'host:9050' PROPERTIES ("tag.compute_group_name" = "etl")добавляет backend в группуetl. Если свойство не задано, BE попадает вdefault_compute_group. MetaService сохраняет назначение, аSHOW COMPUTE GROUPSпоказывает состав групп. - Предоставьте доступ. Обычному пользователю по умолчанию недоступна ни одна вычислительная группа. Команда
GRANT USAGE_PRIV ON COMPUTE GROUP etl TO 'etl_user'позволяет ему выбирать эту группу. Пользователи с правами администратора видят все группы. - Задайте группу по умолчанию.
SET PROPERTY FOR 'etl_user' 'default_compute_group' = 'etl'автоматически направляет новые сеансы в нужную группу. Чтобы изменение вступило в силу, пользователь должен переподключиться. - Переключайтесь по мере необходимости.
USE @biменяет активную вычислительную группу текущего сеанса. Это удобно для DBA с доступом к нескольким группам и для разовых запросов, которым нужен пул, отличный от пользовательского пула по умолчанию. - Планируйте и выполняйте запросы. Планировщик запросов размещает фрагменты только на BE выбранной группы. Каждый BE читает данные из общего хранилища; повторные обращения обслуживает локальный файловый кэш. Промахи кэша приводят к сетевому обращению, а не к сбою запроса.
- Масштабируйте без ограничений.
ALTER SYSTEM ADD BACKEND ...расширяет группу;ALTER SYSTEM DECOMMISSION BACKEND ...уменьшает её. Не нужно ждать перебалансировки tablet, поскольку перемещать реплики не требуется.
Быстрый старт
-- Add stateless BEs into two compute groups
ALTER SYSTEM ADD BACKEND 'be1:9050' PROPERTIES ("tag.compute_group_name" = "etl");
ALTER SYSTEM ADD BACKEND 'be2:9050' PROPERTIES ("tag.compute_group_name" = "bi");
ALTER SYSTEM ADD BACKEND 'be3:9050' PROPERTIES ("tag.compute_group_name" = "bi");

-- Grant access
GRANT USAGE_PRIV ON COMPUTE GROUP etl TO 'etl_user';
GRANT USAGE_PRIV ON COMPUTE GROUP bi  TO 'bi_user';

-- Set defaults (the user has to reconnect for new defaults to apply)
SET PROPERTY FOR 'etl_user' 'default_compute_group' = 'etl';
SET PROPERTY FOR 'bi_user'  'default_compute_group' = 'bi';

-- One-off switch for the current session
USE my_db@bi;
SELECT region, SUM(amount) FROM orders WHERE dt = CURRENT_DATE() GROUP BY region;
Ожидаемый результат
+------+-----------+-------+----------+
| Name | IsCurrent | Users | Backends |
+------+-----------+-------+----------+
| etl  | false     | 1     | 1        |
| bi   | true      | 1     | 2        |
+------+-----------+-------+----------+
Команда SHOW COMPUTE GROUPS подтверждает такую конфигурацию. Агрегация выполняется только на be2 и be3. ETL и BI используют одни и те же данные orders в объектном хранилище, но не имеют общих BE и общего локального кэша. Выведите be1 из эксплуатации, и группа etl станет пустой; данные останутся без изменений.
Когда стоит использовать вычислительную группу Apache Doris?
Вычислительные группы Apache Doris подходят для кластеров с разделением хранения и вычислений, которым нужны изоляция рабочих нагрузок, разделение чтения и записи или эластичное изменение вычислительных ресурсов в часы пиковой и низкой нагрузки. Они не подходят для развёртываний с совмещёнными вычислениями и хранением или для запросов, использующих несколько групп.
Подходящие сценарии
- Кластеры с разделением хранения и вычислений, которым требуется изоляция рабочих нагрузок без затрат на дополнительные реплики.
- Разделение чтения и записи: загружайте данные через группу записи и выполняйте запросы через группу чтения, используя одну общую копию в объектном хранилище. Приёмы прогрева, помогающие сохранить высокую скорость чтения, описаны в рекомендациях по использованию файлового кэша.
- Эластичное изменение вычислительных ресурсов в часы пиковой и низкой нагрузки: добавляйте группу в рабочее время и выводите её из эксплуатации на ночь; в обоих случаях данные перемещать не нужно.
- Кластеры с несколькими арендаторами, где каждый арендатор получает собственный вычислительный пул, а расходы на хранение остаются прежними.
- Распределяйте CPU и память внутри каждой вычислительной группы с помощью Workload Group; об области действия, задаваемой при создании, см. раздел Привязка Workload Group.
Неподходящие сценарии
- Развёртывания с совмещёнными вычислениями и хранением. В них нет общего объектного хранилища, поэтому аналогичную функцию выполняет Resource Group.
- Запросы к нескольким группам. Как и в случае Resource Group, запрос не может объединить BE из двух вычислительных групп; выбирайте подходящую группу для каждого сеанса.
- Рабочие нагрузки, для которых неприемлемы задержки из-за холодного кэша. В новой группе файловый кэш пуст, поэтому при первом запросе все данные для чтения извлекаются из объектного хранилища. Используйте
WARM UP COMPUTE GROUP <target> WITH COMPUTE GROUP <source>, чтобы заранее заполнить кэш до поступления трафика. - Повторная привязка групп рабочих нагрузок к другим вычислительным группам после создания. Группа рабочих нагрузок создаётся внутри одной вычислительной группы, и её нельзя переместить; для изменения привязки удалите её и создайте заново.
- Расчёт на то, что изоляция записи данных появится автоматически. Операции чтения закреплены за BE выбранной группы, но операции записи в конечном счёте сохраняют данные в общем слое хранения, поэтому неконтролируемая загрузка всё равно может исчерпать пропускную способность хранилища.
Дополнительные материалы
- Справочник по Compute Group: полный набор SQL-команд, модель привилегий и правила переключения с помощью
USE @group. - Управление вычислительными группами: пошаговое руководство по эксплуатации со сценариями изоляции чтения от чтения, чтения от записи и записи от записи, а также примечание об устаревшем названии «compute cluster».
- Привязка Workload Group: как область действия группы рабочих нагрузок ограничивается одной вычислительной группой и какие правила действуют для автоматически создаваемой группы
normal. - Resource Group: аналог для режима с совмещёнными вычислениями и хранением и связанные с ним затраты на дополнительные реплики.
- Workload Group: уровень изоляции внутри процесса, который обычно используют совместно с Compute Group.
- Рекомендации по использованию файлового кэша при разделении чтения и записи: стратегии прогрева, которые сохраняют высокую скорость работы групп для запросов, даже когда запись выполняется в других группах.
- Архитектура MPP: модель выполнения shared-nothing, в которой каждый добавляемый BE предоставляет ещё один слот для экземпляра фрагмента.