Data Cache и Page Cache
Кратко Apache Doris кэширует данные хранилища lakehouse на двух уровнях. Data Cache хранит байты из S3 или HDFS на локальном диске BE (блоками по 1 MB), поэтому повторные сканирования обходятся без обращения к сети. Page Cache хранит распакованные страницы столбцов в памяти, поэтому повторные сканирования также обходятся без распаковки и декодирования.
WARM UPзаранее заполняет оба кэша: после развёртывания с непрогретым кэшем второй запуск выполняется со скоростью локального диска, а третий со скоростью RAM.
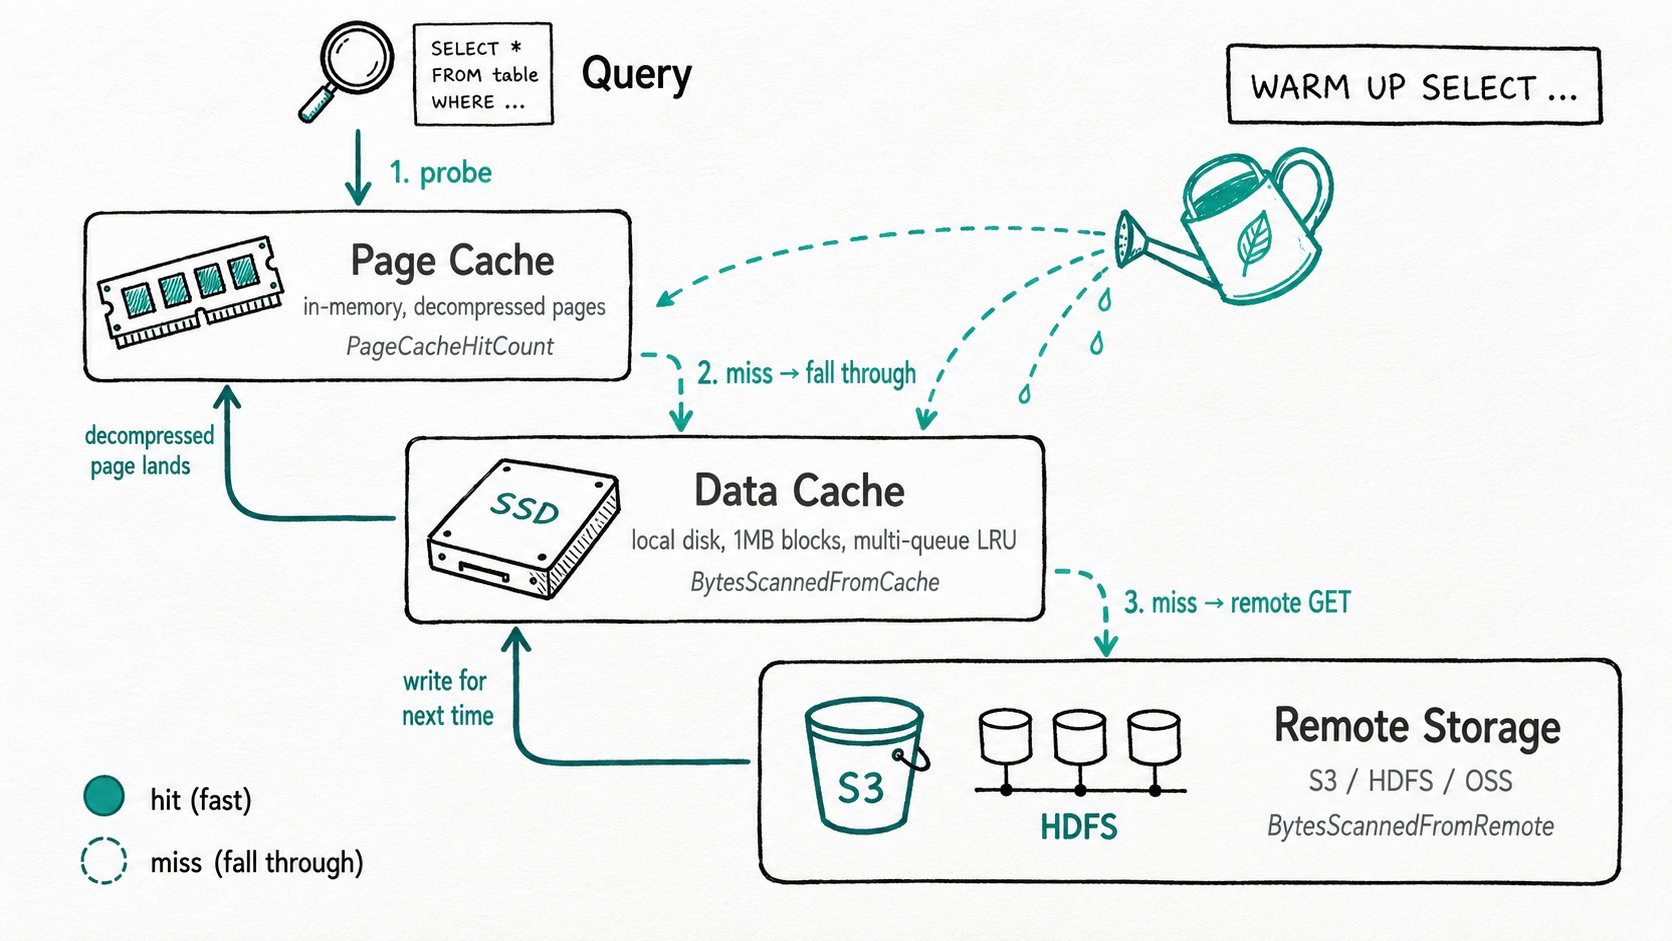
Зачем использовать Data Cache и Page Cache в Apache Doris?
Data Cache и Page Cache в Apache Doris сокращают задержку запросов к lakehouse, устраняя повторное получение данных по сети и повторную распаковку часто используемых данных. При выполнении запроса к таблице Hive или Iceberg в S3 ресурсы на обработку каждого байта тратятся трижды: на получение (цикл HTTP-запроса и ответа для каждого GET-запроса диапазона байтов), на распаковку (snappy, zstd, gzip) и на декодирование (RLE, dictionary, plain). Обычно больше всего времени уходит на получение данных. Хвостовая задержка S3 GET составляет от 30 ms до 500 ms; сканирование Parquet, выполняющее тысячи чтений по диапазонам, может тратить большую часть общего времени на ожидание HTTP ещё до начала работы CPU.
В нескольких распространённых сценариях это особенно заметно:
- Одна и та же панель мониторинга обновляется каждые пять минут, обращается к тем же 100 GB недавних партиций и при каждом запуске загружает их заново.
- В кластер только что добавили BE (автомасштабирование, замена, развёртывание), и первый попавший на него запрос вынужден заново загружать все файлы, тогда как остальная часть кластера отвечает за миллисекунды.
- Отчёт с большим числом параллельных запросов распределяет работу между десятками BE, которые запрашивают одни и те же часто используемые партиции. В результате производительность кластера ограничивается передачей данных из объектного хранилища, а не ресурсами CPU.
Два кэша работают на разных уровнях. Попадание в Data Cache устраняет обращение к сети. Попадание в Page Cache устраняет обращение к сети и распаковку, но только если кэш был заполнен при предыдущем чтении.
Что такое Data Cache и Page Cache в Apache Doris?
Data Cache и Page Cache в Apache Doris представляют собой два взаимодополняющих кэша хранения: кэш байтов удалённых файлов на локальном диске каждого BE и кэш страниц столбцов в памяти.
Data Cache хранит байты удалённых файлов на локальном диске каждого BE. Когда BE Apache Doris читает файл Parquet или ORC из таблицы Hive, Iceberg, Hudi или Paimon, байты загружаются блоками по 1 MB и записываются в настроенный локальный каталог. При повторном чтении того же смещения данные считываются с диска вместо обращения к S3.
Page Cache хранит страницы столбцов в памяти. Существует два варианта. Storage Page Cache кэширует распакованные страницы из внутренних сегментов Doris. Parquet Page Cache (4.1+) делает то же самое для внешних файлов Parquet и в зависимости от коэффициента сжатия страницы выбирает, хранить её в сжатом или распакованном виде.
Основные термины
Block: единица хранения Data Cache. По умолчанию 1 MB; на диске каждой паре(file, offset)соответствует один блок.Multi-queue LRU: стратегия вытеснения Data Cache. Отдельные очереди для обычных данных, данных с TTL, индексных данных и данных для разовых чтений не позволяют однопроходному сканированию вытеснить часто используемые блоки панели мониторинга.Page: единица декодирования внутри фрагмента столбца (column chunk): обычно от 64 KB до 1 MB значений, закодированных с помощью RLE/dictionary/plain.WARM UP: синтаксис SQL для предварительного заполнения любого из кэшей с помощью синтетического сканирования в фоновом режиме.Admission control: политика, определяющая, разрешено ли данному запросу записывать данные в Data Cache; предотвращает заполнение кэша данными разовых сканирований.
Как работают Data Cache и Page Cache в Apache Doris?
Apache Doris направляет каждое сканирование lakehouse сначала в Page Cache, затем в Data Cache и лишь при отсутствии данных обращается к S3/HDFS. Сканирование проходит через кэши последовательно, сверху вниз.
- Поиск в Page Cache (память). Перед выполнением любых операций IO модуль чтения проверяет, есть ли нужная страница столбца в Page Cache. Ключ состоит из пути к файлу, размера файла и смещения. При попадании возвращаются байты, готовые к декодированию (или уже декодированные); модуль чтения пропускает и IO, и распаковку.
- Поиск в Data Cache (локальный диск). При промахе Page Cache модуль чтения файлов ищет в Data Cache блок размером 1 MB, покрывающий запрошенный диапазон байтов. При попадании данные считываются с локального NVMe со скоростью, измеряемой в GB/s; распаковка и декодирование всё ещё требуются, но обращения к сети нет.
- Удалённое чтение (S3/HDFS). При промахе Data Cache BE отправляет GET-запрос диапазона байтов к объектному хранилищу и записывает блок размером 1 MB в локальный кэш для последующих обращений. Admission control может запретить запись, если запрос помечен как разовый.
- Декодирование и запись в Page Cache. Распакованные страницы помещаются в Page Cache. Parquet Page Cache сравнивает для каждой страницы
decompressed_size / compressed_sizeсparquet_page_cache_decompress_threshold(по умолчанию 1.5): если значение ниже порога, страница сохраняется в более экономном сжатом виде, а если выше, в распакованном. - Вытеснение. Оба кэша используют LRU с шардированием. Data Cache также выполняет фоновый цикл вытеснения (
enable_evict_file_cache_in_advance), который освобождает место при превышении порогового уровня заполнения диска, прежде чем запросу придётся ждать.
WARM UP по запросу проходит тот же путь. Он выполняет сканирование, учитывает попадания и промахи и заранее заполняет оба кэша, не возвращая строк.
Быстрый старт
-- One-time setup on each BE: configure a cache directory.
-- be.conf (enable_file_cache is enabled by default since Doris 4.2):
--   enable_file_cache = true
--   file_cache_path = [{"path":"/data/file_cache","total_size":107374182400}]

-- Per-session toggles (defaults shown):
SET enable_file_cache = true;

-- Pre-populate the Data Cache for today's hot partition.
WARM UP SELECT l_orderkey, l_shipmode
FROM hive_catalog.tpch.lineitem
WHERE l_shipdate = '2026-05-01';

-- Now run the real query: it should hit cache on retries.
SELECT l_shipmode, count(*)
FROM hive_catalog.tpch.lineitem
WHERE l_shipdate = '2026-05-01'
GROUP BY l_shipmode;
Ожидаемый результат (фрагмент профиля)
VFileScanNode
  BytesScannedFromCache:   2.02 GB
  BytesScannedFromRemote:  0 B
  PageCacheHitCount:       18432
  PageCacheMissCount:      0
Первый запуск заполнил Data Cache данными из S3. При втором запуске для выполнения запроса хватило локального диска BE, а распакованные страницы выдавались из RAM.
Когда следует использовать Data Cache и Page Cache в Apache Doris?
Используйте Data Cache и Page Cache в Apache Doris для повторяющихся запросов к часто используемым партициям lakehouse, панелей мониторинга с большим числом параллельных запросов и эластичного масштабирования вычислительных групп. Откажитесь от них, если рабочие наборы превышают объём кэша, при разовом ETL или на механических дисках, где локальный IO не быстрее удалённого источника.
Подходящие сценарии
- Повторяющиеся запросы к часто используемым партициям (панели мониторинга со скользящим окном, ежедневные отчёты).
- Таблицы lakehouse в S3 или HDFS, где основные затраты приходятся на сеть или исходящий трафик.
- Нагрузки с большим числом параллельных запросов, при которых десятки BE обращаются к одним и тем же файлам. Кэш снимает зависимость производительности обработки запросов от пропускной способности объектного хранилища.
- Эластичное масштабирование вычислительных групп: прогрейте новую вычислительную группу данными из существующей, прежде чем направлять на неё трафик.
- Нагрузки с неравномерным доступом (принцип Парето: на 10% партиций приходится 90% запросов).
Неподходящие сценарии
- Рабочие наборы, превышающие объём кэша. Если каждый запрос обращается к новым данным, содержимое кэша постоянно вытесняется, а каждое чтение требует всех затрат, связанных с промахом; при этом CPU дополнительно расходуется на вытеснение. Увеличьте кэш, сузьте предикат или отключите кэш для этой нагрузки.
- Разовые задачи ETL и дозагрузка исторических данных. Они вытесняют действительно часто используемые блоки ради данных, которые больше никто не прочитает. Используйте admission control, чтобы такие сканирования не заполняли кэш, или запускайте их с
enable_file_cache = false. - Запросы к внутренним таблицам Doris в расчёте на ускорение с помощью Data Cache. Data Cache работает только с файлами Hive, Iceberg, Hudi и Paimon; внутренние таблицы уже используют Storage Page Cache и страничный кэш операционной системы.
- Механические диски. Data Cache рассчитан на то, что локальный IO существенно быстрее удалённого источника. На HDD локальный цикл запроса и ответа может оказаться медленнее параллельного S3 GET. Используйте SSD или NVMe.
- Чрезмерно большой Page Cache. Если выделить более 30–40% памяти, буферным пулам запросов не хватает места, что вызывает сброс на диск (spilling), затраты на который превышают выигрыш от кэширования. Значение по умолчанию
storage_page_cache_limit = 20%подходит для большинства нагрузок.
Дополнительные материалы
- Справочник по Data Cache: полное описание возможностей, включая
WARM UP SELECT, ограничения для отдельных запросов и admission control. - File Cache (с разделением вычислений и хранения): тот же механизм для внутренних таблетов в облачном режиме.
- Parquet Page Cache и другие способы настройки lakehouse: кэш распакованных страниц в памяти для внешних файлов Parquet.
- Оптимизация Parquet Reader: модуль чтения, который изначально определяет, какие байты запрашивать. Кэширование и отсечение данных (pruning) дополняют друг друга.
- Query Cache и Condition Cache: кэши на уровне результатов и предикатов, расположенные над кэшами хранения.
- Оператор WARM UP: синтаксис SQL для предварительного заполнения кэшей в разных вычислительных группах.
- Iceberg: один из основных потребителей кэша страниц: при сканировании Iceberg удалённые файлы Parquet читаются из объектного хранилища типа S3.