Компактация данных
Кратко Каждая загрузка в Apache Doris создаёт новый неизменяемый rowset. Компактация Apache Doris объединяет эти rowset в фоновом режиме, чтобы запросам не приходилось просматривать сотни версий. Две политики (
size_basedиtime_series), а также вертикальная компактация и компактация сегментов позволяют настроить баланс между амплификацией записи и чтения для каждой таблицы.
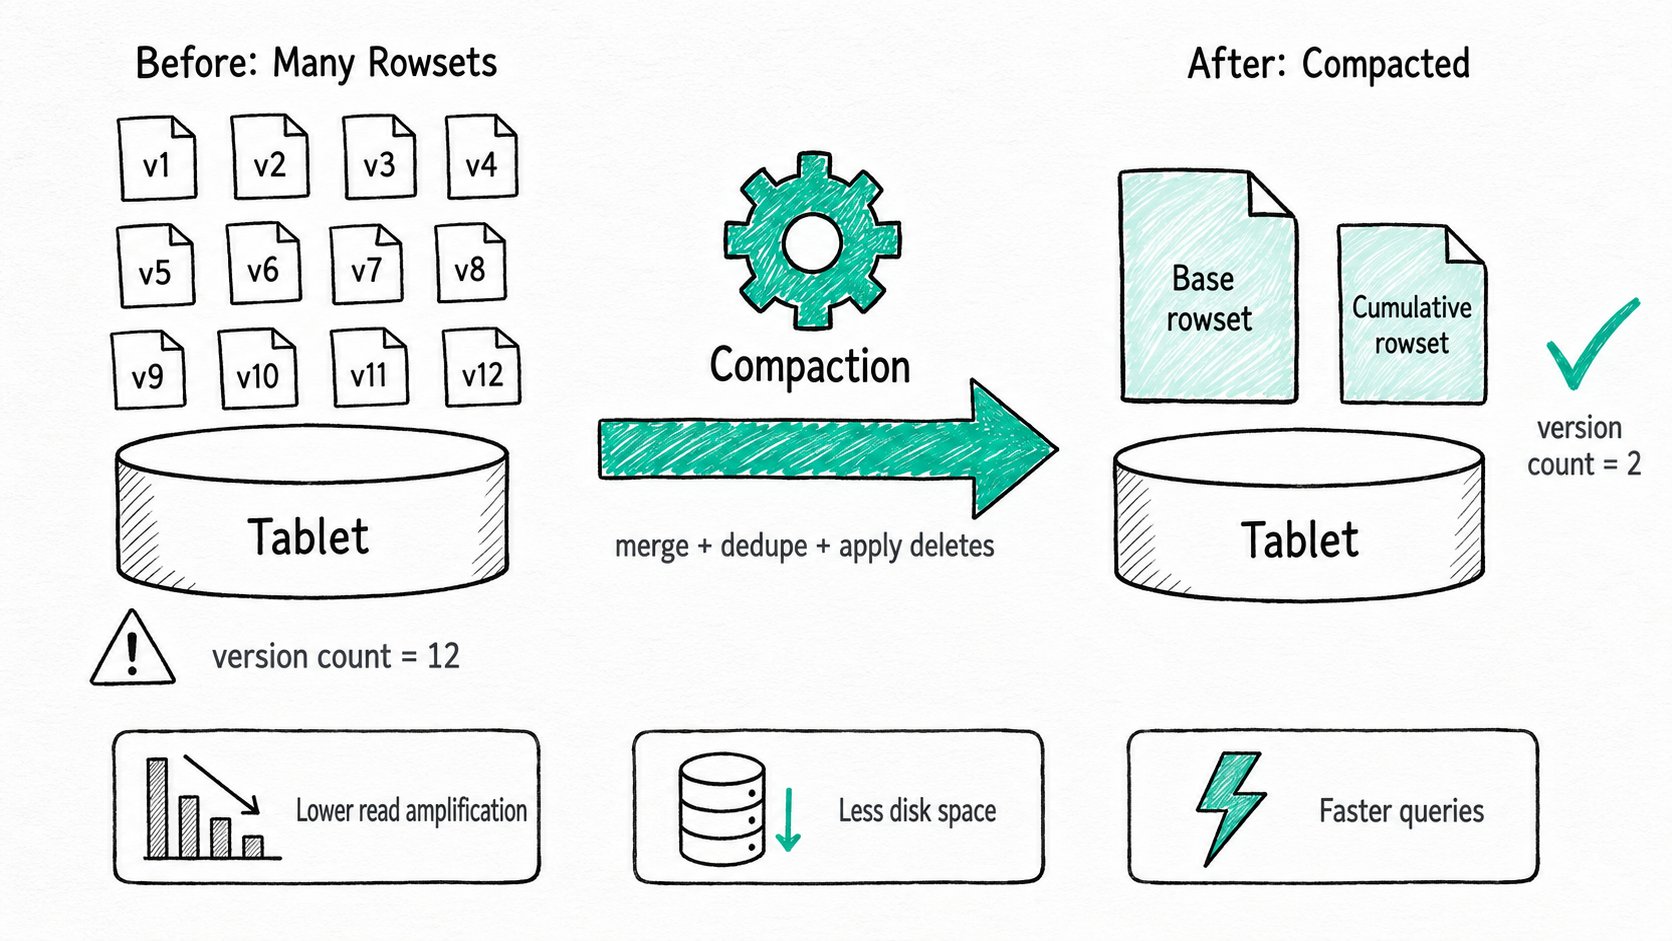
Зачем нужна компактация Apache Doris?
Компактация Apache Doris сохраняет высокую скорость запросов при частых загрузках, объединяя неизменяемые rowset, которые создаются при каждой записи, прежде чем накопление версий приведёт к печально известной ошибке загрузки -235. Apache Doris хранит данные по принципу LSM-дерева: запись никогда не изменяет файл на месте. Она создаёт совершенно новый rowset, и число rowset на таблете продолжает расти, пока не произойдёт очистка. Способы загрузки с высокой частотой, такие как Stream Load и Group Commit, особенно быстро увеличивают это число. Без компактации:
- Как только число версий на таблете превышает
max_tablet_version_num(по умолчанию 500), загрузки завершаются с ошибкой -235. Это один из самых распространённых инцидентов в рабочих средах, обсуждаемых в списке рассылки пользователей Doris. - Каждый запрос должен на лету объединять все rowset таблета. Если число rowset увеличивается с 5 до 50, это всё равно что вместо одной коробки искать данные в пятидесяти.
- Удалённые строки сохраняются в виде маркеров удаления (tombstones), а метаданные небольших файлов занимают больше места, чем сами данные в них.
Компактация Apache Doris — фоновый процесс, который решает все три проблемы. Встроенные политики учитывают, что эффективная компактация не должна потреблять столько CPU, чтобы замедлять загрузку данных.
Что такое компактация Apache Doris?
Компактация Apache Doris — процедура, выполняемая в пределах одного таблета: она выбирает диапазон rowset, объединяет их строки, применяет удаления и записывает один новый rowset взамен исходных. Backend (BE) выполняет её в пуле потоков, оценивая, насколько сильно таблет нуждается в компактации, и в первую очередь обрабатывая самые проблемные.
Основные термины
Rowset: неизменяемая группа файлов, создаваемая одной загрузкой. У rowset есть версии; запросы объединяют данные из разных rowset во время чтения.Cumulative compaction: быстрый и часто выполняемый вид компактации. Объединяет небольшие недавние rowset выше кумулятивной точки.Base compaction: медленный и редко выполняемый вид компактации. Объединяет всё ниже кумулятивной точки в один базовый rowset.Compaction score: приблизительное число путей слияния, которые запросу пришлось бы пройти на этом таблете. Чем выше оценка, тем выше приоритет.Compaction policy: выбор политики для отдельной таблицы:size_based(по умолчанию) илиtime_series. Определяет, какие rowset объединять и когда.Vertical compaction: объединение по группам столбцов для широких таблиц. Сокращает потребление памяти примерно в 10 раз по сравнению с построчным объединением.
Как работает компактация Apache Doris?
Компактация Apache Doris оценивает каждый таблет по степени накопления версий, выбирает rowset согласно действующей политике и объединяет их в пуле потоков BE. При этом исходные файлы остаются доступными для чтения уже выполняющимся запросам.
- Оценка каждого таблета. BE постоянно поддерживает оценку компактации для каждого таблета на основе числа rowset выше кумулятивной точки. Таблеты с более высокой оценкой обрабатываются в первую очередь.
- Выбор rowset. Действующая политика определяет диапазон.
size_basedгруппирует rowset по размерам, соответствующим степеням двойки;time_seriesждёт, пока rowset в партиции достигнут целевого суммарного размера, порога числа файлов или возраста, а затем объединяет их за один проход. - Объединение и запись. Задача читает строки из исходных rowset, удаляет дубликаты, применяет ожидающие удаления и записывает результат в новый rowset. Для широких таблиц используется вертикальная компактация, которая обрабатывает столбцы группами, ограничивая потребление памяти.
- Перевод на базовый уровень. Когда результат кумулятивной компактации превышает
compaction_promotion_size_mbytes(по умолчанию 1 GB), он может участвовать в базовой компактации на следующем цикле. - Замена и очистка. В метаданных таблета результирующий rowset заменяет исходные. Старые файлы сохраняются на некоторое время на случай, если запрос ещё читает их, а затем удаляются.
Быстрый старт
CREATE TABLE access_log (
  ts DATETIME, user_id BIGINT, url VARCHAR(512)
)
DUPLICATE KEY(ts, user_id)
PARTITION BY RANGE(ts) (
  PARTITION p202605 VALUES LESS THAN ("2026-06-01")
)
DISTRIBUTED BY HASH(user_id) BUCKETS 4
PROPERTIES (
  "compaction_policy" = "time_series",
  "time_series_compaction_goal_size_mbytes" = "1024",
  "time_series_compaction_file_count_threshold" = "2000",
  "time_series_compaction_time_threshold_seconds" = "3600"
);

ADMIN COMPACT TABLE access_log PARTITION (p202605) WHERE TYPE = "cumulative";
Ожидаемый результат
Query OK, 0 rows affected
Вы создали партиционированную таблицу журналов с политикой для временных рядов: небольшие rowset объединяются, когда их суммарный размер превышает 1 GB, число файлов достигает 2000 или с момента их создания проходит час. Строка с ADMIN COMPACT вручную запускает кумулятивную компактацию активной партиции, что полезно для замеров производительности и очистки после загрузки. Отслеживайте ход выполнения с помощью SELECT * FROM information_schema.doris_be_compaction_tasks WHERE TABLE_ID = ....
Когда следует использовать компактацию Apache Doris?
По умолчанию компактация Apache Doris выполняется для каждой таблицы; на практике нужно выбрать политику и определить, когда менять настройки по умолчанию.
Подходящие сценарии
- Любая таблица с частыми загрузками. Настройки по умолчанию уже работают; остаётся лишь решить, нужно ли сменить политику.
- Журналы и метрики, в которые только добавляются данные.
time_seriesснижает амплификацию записи, поскольку каждый rowset участвует в компактации один раз, а не многократно на разных уровнях размера. - Широкие таблицы с десятками столбцов и более. Сохраняйте настройку
enable_vertical_compaction = true, чтобы крупные операции объединения не приводили к чрезмерному потреблению памяти.
Неподходящие сценарии
- Частые вставки по одной строке ради «стресс-тестирования компактации». Так вы лишь создадите проблему накопления версий, которую пытаетесь изучить. Вместо этого используйте Group Commit при загрузке данных.
- Отключение автоматической компактации в рабочей среде ради «экономии CPU». На таблетах незаметно накапливаются версии, а затем загрузки начинают завершаться с ошибкой -235. Вместо этого настройте число потоков (
max_cumu_compaction_threads,max_base_compaction_threads). - Использование политики
time_seriesс нагрузками, которые обновляют или удаляют строки по первичному ключу. Политика предполагает только добавление данных; для таблиц Unique Key с частыми обновлениями используйтеsize_based. - Попытка исправить неудачное распределение по бакетам с помощью компактации. Если нагрузка на один таблет настолько высока, что компактация постоянно не успевает обрабатывать накопившиеся версии, нужно увеличить число бакетов, а не потоков компактации.
Производительность и показатели
- Вертикальная компактация: потребление памяти составляет ~1/10 от потребления при построчной компактации, а скорость на широких таблицах примерно на 15% выше. Источник: документация по настройке компактации Doris.
- Пропускная способность компактации: около 300,000 строк в секунду на задачу с настройками по умолчанию; при непрерывной загрузке оценка кумулятивной компактации держится около 50. Источник: Разбираемся в компактации данных за 3 минуты.
Дополнительные материалы
- Вертикальная компактация: объединение по группам столбцов, которое сокращает потребление памяти при компактации примерно в 10 раз и ускоряет объединение широких таблиц примерно на 15%.
- Принципы, виды и планирование компактации
- Настройка компактации: вертикальная, сегментная, на одной реплике, для временных рядов
- Справочник по синтаксису
ADMIN COMPACT TABLE - Разбираемся в компактации данных за 3 минуты (блог)
- Unique Key: модель таблиц, в которой компактация освобождает место, занятое строками, отмеченными в битовой карте удаления каждого rowset.