Модель данных
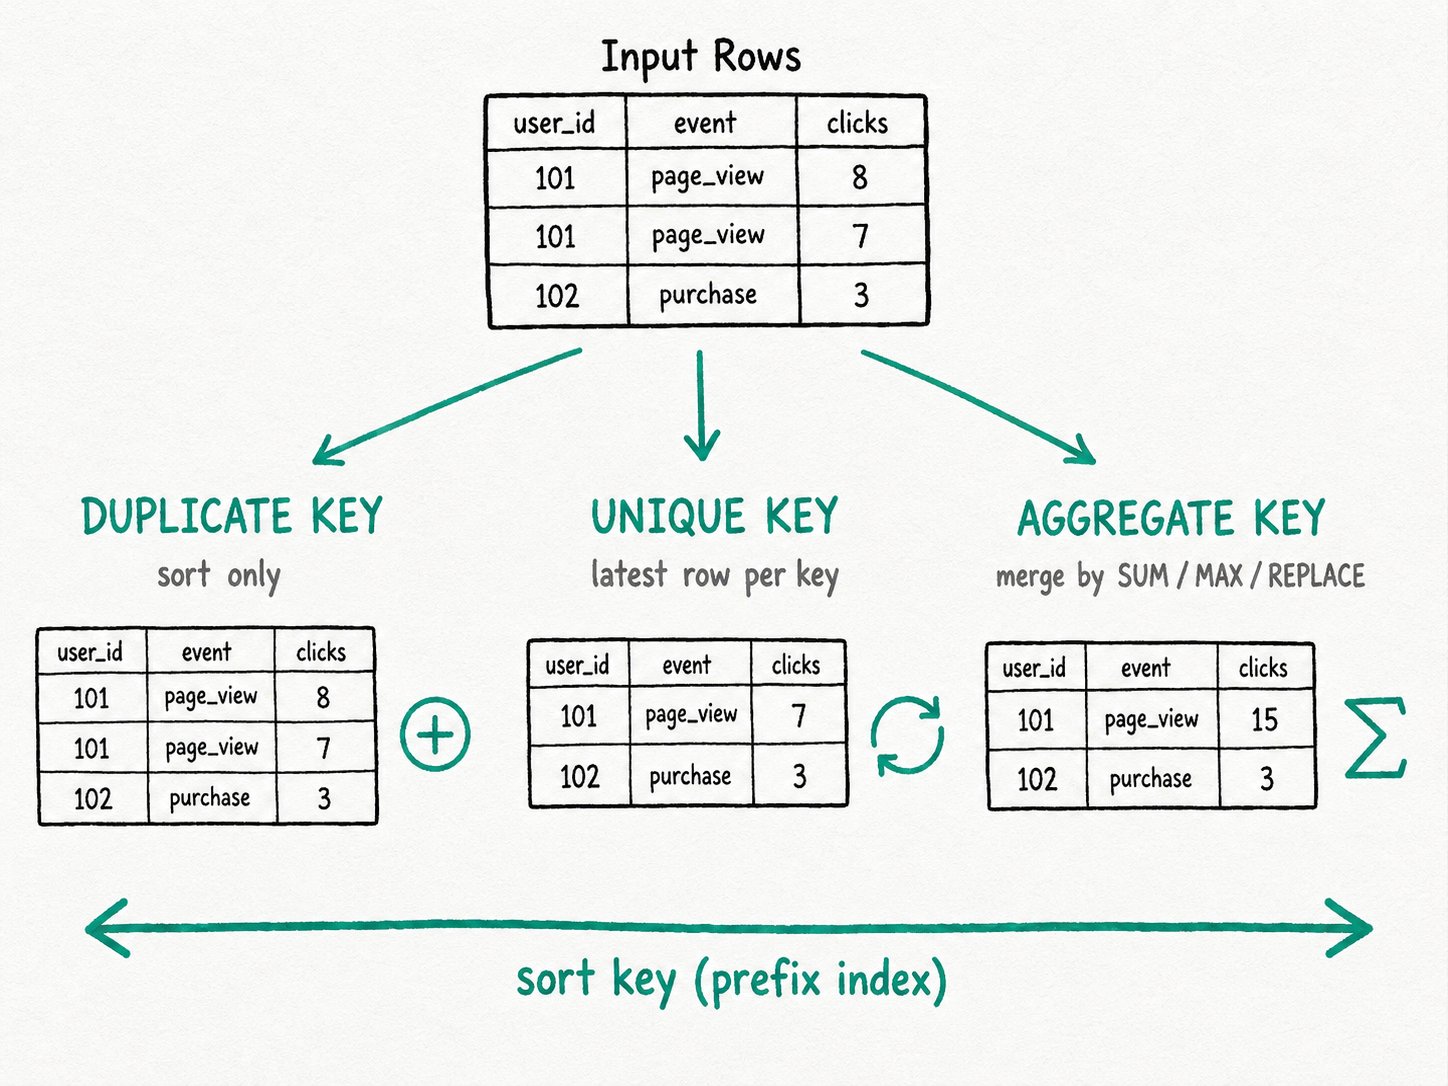
Кратко При создании каждой OLAP-таблицы Apache Doris выбирается одна из трёх моделей: Duplicate Key сохраняет все строки, Unique Key сохраняет последнюю строку для каждого первичного ключа, а Aggregate Key объединяет строки с помощью функций отдельных столбцов, например
SUM. ПредложениеKEY(...)указывает столбцы, по которым Apache Doris сортирует данные, а в моделях Unique и Aggregate эти же столбцы также обеспечивают уникальность. Модель фиксируется при выполненииCREATE TABLE, поэтому первоначальный выбор определяет, какие операции записи, обновления и запросы будут доступны на протяжении всего срока существования таблицы.
Зачем нужна модель данных Apache Doris?
Выбор модели данных Apache Doris — первое решение при проектировании любой схемы, и изменить его впоследствии нельзя. С помощью ALTER TABLE можно добавлять и удалять столбцы, изменять партиционирование и менять кодировки. Превратить таблицу Duplicate в таблицу Unique эта команда не позволяет. Если модель выбрана неверно, придётся выполнить CREATE TABLE и заново загрузить все данные.
- Таблица журналов, созданная с моделью Aggregate, теряет исходные строки и не позволяет выполнять запросы к детальным данным.
- Таблица заказов, созданная с моделью Duplicate, отклоняет
UPDATE, поэтому конвейеру CDC некуда записывать изменения строк. - Таблица для отчётности, созданная с моделью Unique, при каждой загрузке несёт затраты на индекс merge-on-write, даже если все запросы имеют вид
SUM(clicks) GROUP BY day.
Модель определяет, допустимы ли повторяющиеся ключи, что означают UPDATE и DELETE и как движок хранения обрабатывает строки с одинаковым ключом. Выбирайте модель по характеру данных: исходные события, текущее состояние или предварительно агрегированные факты. Не ориентируйтесь на вид дашборда, который вы создаёте на этой неделе.
Что такое модель данных Apache Doris?
Модель данных Apache Doris — это набор правил, которые движок хранения применяет к строкам с одинаковыми значениями ключевых столбцов. Apache Doris предоставляет три модели: DUPLICATE KEY, UNIQUE KEY и AGGREGATE KEY. В Catalog FE они обозначаются как DUP_KEYS, UNIQUE_KEYS и AGG_KEYS (см. KeysType.java). Соответствующее предложение располагается сразу после списка столбцов в CREATE TABLE и указывает ключевые столбцы:
... DUPLICATE KEY(log_time, log_type)
... UNIQUE KEY(order_id)
... AGGREGATE KEY(dt, ad_id, user_id)
Основные термины
- Ключевые столбцы: столбцы, указанные в предложении
KEY(...). Они определяют порядок сортировки на диске, используются для построения префиксного индекса и обеспечивают уникальность в моделях Unique и Aggregate. - Столбцы значений: все остальные столбцы. В моделях Duplicate и Unique они хранят данные в том виде, в котором те были записаны. В Aggregate для каждого такого столбца задаётся функция агрегации (
SUM,MAX,REPLACE,BITMAP_UNIONи так далее). - Ключ сортировки: другое название ключевых столбцов, используемое при обсуждении организации хранения. Данные внутри tablet сортируются по ключевым столбцам независимо от выбранной модели.
- Модель Duplicate Key: ключи могут повторяться. Строки добавляются в том виде, в котором поступают. Предложение
KEY(...)задаёт только сортировку. - Модель Unique Key: одна строка на ключ. Новые записи заменяют старые строки с тем же ключом. Поддерживает SQL-операции
UPDATE,DELETEи upsert с обновлением части столбцов через Merge-on-Write. - Модель Aggregate Key: строки с одинаковым ключом объединяются с помощью функции, заданной для каждого столбца значений. При чтении вы получаете объединённую строку.
Как работает модель данных Apache Doris?
Модель данных Apache Doris применяет один из трёх наборов правил обработки строк при загрузке, а затем повторно при compaction. При этом структура DDL остаётся одинаковой.
- Выберите модель. Предложение
DUPLICATE KEY,UNIQUE KEYилиAGGREGATE KEYзадаётKeysTypeтаблицы. Apache Doris проверяет остальную часть DDL на соответствие выбранной модели: для столбцов значений Aggregate необходимо указать функцию, для таблиц Unique устанавливается свойство merge-on-write, а в таблицах Duplicate функции агрегации полностью запрещены. - Упорядочьте столбцы. В списке столбцов все ключевые столбцы должны предшествовать столбцам значений. Apache Doris сортирует данные внутри каждого tablet по ключевым столбцам и строит разреженный префиксный индекс по первым 36 байтам ключа сортировки. Этот индекс ускоряет обработку предикатов диапазона и равенства по начальным ключевым столбцам.
- Примените правила при загрузке. Duplicate добавляет строки. Unique находит существующую строку по ключу, устанавливает для неё бит в delete bitmap соответствующего rowset и записывает новую строку. Aggregate объединяет поступающие строки с существующими, используя функцию каждого столбца значений (
SUM,MAX,REPLACEи так далее). - Повторно примените правила при compaction. Фоновая compaction объединяет rowset по тем же правилам. Duplicate выполняет конкатенацию. Unique удаляет строки, отмеченные в delete bitmap. Aggregate снова объединяет дубликаты с помощью функций столбцов значений.
- Прочитайте данные. Запросы видят данные в соответствии с моделью: каждую добавленную строку в Duplicate, последнюю строку для каждого ключа в Unique и одну объединённую строку для каждого ключа в Aggregate.
Модель записывается в метаданные tablet и реплицируется на все реплики. Команды ALTER TABLE ... CHANGE MODEL не существует. Чтобы сменить модель, нужно создать новую таблицу и заново загрузить данные.
Быстрый старт
-- Duplicate: keep every event, sort by (log_time, log_type)
CREATE TABLE logs (
  log_time DATETIME, log_type INT, msg VARCHAR(1024)
) DUPLICATE KEY(log_time, log_type)
DISTRIBUTED BY HASH(log_type) BUCKETS 4;

-- Unique: one row per order_id, with UPDATE / DELETE support
CREATE TABLE orders (
  order_id BIGINT, status VARCHAR(20), amount DECIMAL(10,2)
) UNIQUE KEY(order_id)
DISTRIBUTED BY HASH(order_id) BUCKETS 4;

-- Aggregate: pre-sum clicks per (dt, ad_id) at load time
CREATE TABLE ad_stats (
  dt DATE, ad_id INT, clicks BIGINT SUM
) AGGREGATE KEY(dt, ad_id)
DISTRIBUTED BY HASH(ad_id) BUCKETS 4;
Ожидаемый результат
SHOW CREATE TABLE logs\G     -- prints "DUPLICATE KEY(`log_time`, `log_type`)"
SHOW CREATE TABLE orders\G   -- prints "UNIQUE KEY(`order_id`)"
SHOW CREATE TABLE ad_stats\G -- prints "AGGREGATE KEY(`dt`, `ad_id`)"
Списки столбцов устроены одинаково, но движок хранения обрабатывает запись совершенно по-разному. Вставьте одну и ту же строку в logs дважды и получите две строки. Сделайте то же самое с orders и получите одну. Вставьте в ad_stats две строки с одинаковыми значениями (dt, ad_id), и значения столбца clicks будут просуммированы.
Когда следует использовать модели данных Apache Doris?
Выбирайте модель данных Apache Doris по характеру данных: исходные события, текущее состояние или предварительно агрегированные факты. Не ориентируйтесь на вид дашборда, который вы создаёте на этой неделе.
Подходящие сценарии
- Duplicate для данных, которые только добавляются и запрашиваются в исходном виде: журналы доступа, потоки кликов, показания IoT-устройств, детали транзакций. Дедупликация не выполняется, ограничений на столбцы, к которым могут обращаться предикаты, нет.
- Unique для данных, обновляемых по первичному ключу: приём изменений CDC из MySQL или Postgres, таблицы статусов заказов, профили пользователей, таблицы измерений, обновляемые в реальном времени. См. Обновление и удаление данных, где описаны
UPDATE, upsert с обновлением части столбцов и внутреннее устройство Merge-on-Write. - Aggregate для запросов сводных данных с фиксированной структурой к таблицам фактов, в которые преимущественно добавляются данные: расходы по дням, клики по объявлениям, уникальные зрители с помощью
BITMAP_UNION. См. Предварительная агрегация и Rollup, где приведён полный набор функций агрегации и описано, какROLLUPрасширяет их возможности. - Для любой модели: выбирайте не более трёх начальных ключевых столбцов, предпочитайте целые числа строкам и используйте наименьший подходящий тип. Префиксный индекс охватывает только первые 36 байт ключа сортировки.
Неподходящие сценарии
- Aggregate, если рабочая нагрузка также требует поиска отдельных исходных строк. Исходные строки теряются сразу после этапа объединения. Используйте Duplicate, при необходимости добавив асинхронное материализованное представление для сводных данных.
- Aggregate, если постоянно выполняется
count(*). Для подсчёта необходимо прочитать и объединить все ключевые столбцы, поэтому затраты растут с шириной ключа. Классический обходной путь — столбец значений, в котором всегда хранится1и для которого задана агрегацияSUM; тогда запросSUM(count)даёт тот же результат и выполняется примерно в 10 раз быстрее, чемcount(*)в таблице Aggregate с широким ключом. - Unique, если вы только добавляете данные и никогда их не обновляете. Индекс ключей merge-on-write требует затрат на возможности, которыми вы не пользуетесь. Выбирайте Duplicate.
- Unique, если первичный ключ используется как ключ партиционирования. Ключи партиционирования должны быть подмножеством уникального ключа, а не наоборот.
- Duplicate для таблиц, которым требуется
UPDATE. Эта команда отклоняется; заново загрузите данные через механизм загрузки или выберите Unique. - Aggregate для таблиц, которым требуется
UPDATEилиDELETEпо столбцам значений. В Aggregate предикатDELETEограничен ключевыми столбцами, поскольку движок не может вычислить условия по столбцам значений до агрегации.
Дополнительные материалы
- Обзор моделей таблиц: матрица возможностей и таблица выбора
- Модель Duplicate Key: хранение с добавлением строк и настройка ключа сортировки
- Модель Unique Key: сравнение Merge-on-Write и Merge-on-Read, обновление части столбцов
- Модель Aggregate: функции агрегации и
AGG_STATEдля пользовательского объединения - Рекомендации по моделям таблиц: порядок столбцов, выбор типов, оптимизация
count(*) - Префиксный индекс и ключ сортировки: как ключевые столбцы позволяют отсекать данные при выполнении запросов
- Обновление и удаление данных: SQL-операции UPDATE, DELETE, upsert с обновлением части столбцов и внутреннее устройство Merge-on-Write, доступные благодаря модели Unique Key.
- Предварительная агрегация и Rollup: подробное описание модели Aggregate Key, а также ROLLUP и синхронных материализованных представлений.
- Партиционирование и бакетирование: как те же ключевые столбцы используются для отсечения партиций и размещения tablet.
- Unique Key: вариант с первичным ключом и одной строкой на ключ наряду с Duplicate и Aggregate. Выбирайте его, если источники выполняют upsert.