Отсечение данных
Кратко Благодаря отсечению данных в Apache Doris запрос фактически сканирует лишь ту часть таблицы, которая осталась после последовательного применения нескольких уровней отсечения. Ключи партиционирования и распределения, статистика min/max в ZoneMap, индексы BloomFilter и NGram BloomFilter на каждом уровне исключают очередную часть данных, которую движку не придётся читать. Большая часть выигрыша достигается автоматически; администратор управляет отсечением через выбор параметров DDL и проверяет результат в выводе EXPLAIN.
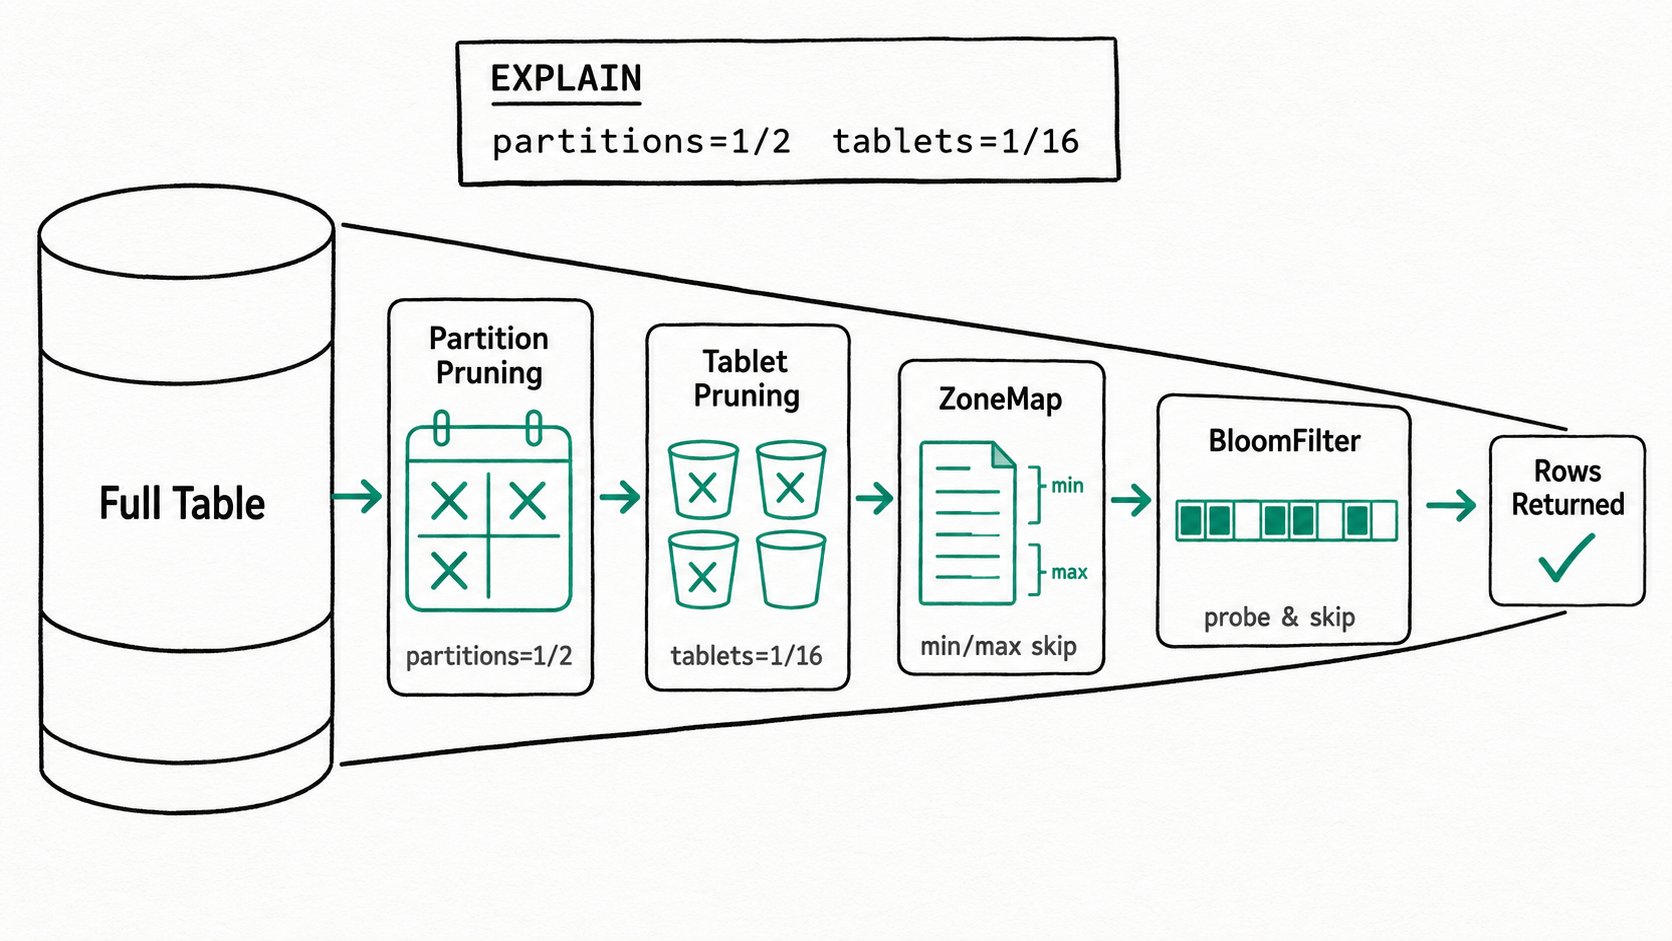
Зачем использовать отсечение данных в Apache Doris?
Отсечение данных в Apache Doris позволяет запросу пропустить большую часть таблицы ещё до её чтения, сокращая сканирование многих терабайт до чтения нескольких партиций или таблетов. Самый быстрый способ ускорить OLAP-запрос: читать меньше данных. Широкая таблица событий, пополняемая на 50 GB в день, за год разрастается до петабайт, а большинству запросов нужна лишь малая часть: один день, один пользователь, один продукт. Без отсечения планировщик распределяет запрос по всем партициям и всем таблетам, а исполнитель читает с диска каждую страницу, чтобы проверить условие WHERE.
Это приводит к трём конкретным проблемам:
- Запрос с условием
WHERE date BETWEEN '2026-04-01' AND '2026-04-07'к таблице с 365 партициями обращается ко всем партициям, пока планировщик не получит информацию о том, какие из них можно пропустить. - Точечные запросы к таблицам с хеш-распределением (
WHERE user_id = 12345) превращаются в полное сканирование таблетов, если оптимизатор не может связать предикат с ключом бакетирования. - Фильтры по столбцам с большим числом уникальных значений, не входящим в ключ (
WHERE phone = '...'), читают каждый сегмент, поскольку нет статистики, позволяющей исключить страницы.
Apache Doris решает каждую из этих проблем на отдельном уровне отсечения, причём уровни работают совместно: планировщик отсекает партиции и таблеты до начала сканирования, а затем BE пропускает сегменты и страницы в оставшихся данных.
Что такое отсечение данных в Apache Doris?
Отсечение данных в Apache Doris представляет собой совокупный результат всех этапов чтения, на которых движок может пропустить данные, не читая их: от партиций и таблетов до сегментов и страниц столбцов. Планировщик Frontend выполняет отсечение на крупном уровне, используя метаданные таблицы: партиции и таблеты. Backend выполняет более детальное отсечение во время сканирования: ZoneMap min/max, BloomFilter, NGram BloomFilter и инвертированный индекс определяют, можно ли пропустить сегмент, страницу столбца или даже диапазон строк.
Ключевые термины
Partition pruning: планировщик использует предикаты диапазона или списка значений по ключу партиционирования, чтобы исключить ненужные партиции ещё до назначения таблетов на выполнение.Bucket (tablet) pruning: предикаты равенства по ключуDISTRIBUTED BY HASHпозволяют планировщику выбрать только те бакеты, которые могут содержать искомую строку.ZoneMap index: статистика min/max/null для каждого сегмента и каждой страницы, автоматически создаваемая для всех столбцов. Предикаты диапазона используют её для пропуска страниц.BloomFilter index: явно включаемый вероятностный фильтр для отдельного столбца, полезный для предикатов равенства иINпо столбцам с большим числом уникальных значений.NGram BloomFilter: явно включаемый индекс, который превращает предикаты поиска подстрокиLIKE '%abc%'в проверки n-грамм по BloomFilter.Runtime filter: фильтр, создаваемый во время соединения на основе данных одной его стороны и проталкиваемый на другую сторону для отсечения данных.
Как работает отсечение данных в Apache Doris?
Отсечение данных в Apache Doris работает на пяти последовательных уровнях: партиции, таблеты, сегменты/страницы, проверки индексов и фильтры времени выполнения. Каждый уровень сокращает объём входных данных для следующего.
- Отсечение партиций (FE). Планировщик Nereids запускает
PruneOlapScanPartition, сопоставляет предикатыWHEREс деревом партиций таблицы, заданных диапазонами или списками значений, и формирует набор оставшихся партиций. EXPLAIN показывает его какpartitions=2/4 (p2,p3). - Отсечение таблетов (FE).
PruneOlapScanTabletизвлекает предикаты равенства по столбцу бакетирования и с помощьюHashDistributionPrunerопределяет, в какие бакеты хешируются эти значения. EXPLAIN показываетtablets=1/32. - Отсечение сегментов / страниц (BE). Для каждой оставшейся таблеты итератор сегментов открывает средства чтения столбцов и обращается к индексу ZoneMap. Если
[min, max]не пересекается с диапазоном предиката, страница исключается без распаковки. - Проверки индексов (BE). BloomFilter, NGram BloomFilter и инвертированные индексы проверяются до декодирования строк. Отсутствие совпадения позволяет пропустить страницу; наличие совпадения означает лишь, что на странице могут быть подходящие строки.
- Фильтры времени выполнения (FE/BE). При соединении фильтры формируются на стороне построения (например,
IN (A.id_set)) и рассылаются так, чтобы сканирование на стороне проверки могло использовать те же механизмы отсечения во время выполнения.
К моменту проверки предикатов большая часть таблицы уже исключена без чтения.
Быстрый старт
CREATE TABLE events (
  ts DATETIME, user_id BIGINT, action VARCHAR(64)
)
DUPLICATE KEY(ts, user_id)
PARTITION BY RANGE(ts) (
  PARTITION p202604 VALUES LESS THAN ("2026-05-01"),
  PARTITION p202605 VALUES LESS THAN ("2026-06-01")
)
DISTRIBUTED BY HASH(user_id) BUCKETS 16
PROPERTIES ("bloom_filter_columns" = "action");

EXPLAIN
SELECT count(*) FROM events
WHERE ts >= '2026-05-08' AND user_id = 42 AND action = 'click';
Ожидаемый результат (фрагмент)
0:VOlapScanNode
  TABLE: events
  PREDICATES: ts >= '2026-05-08', user_id = 42, action = 'click'
  partitions=1/2 (p202605)
  tablets=1/16
Планировщик оставил одну партицию из двух (по диапазону дат) и одну таблету из шестнадцати (по хешу user_id). Во время чтения BE использует ZoneMap для ts и BloomFilter для action, чтобы пропускать страницы внутри оставшейся таблеты. Четыре уровня отсечения обрабатывают три предиката без ручной настройки.
Когда стоит использовать отсечение данных в Apache Doris?
Отсечение данных в Apache Doris работает всегда; вопрос лишь в том, какие уровни задействуют ваши определения DDL и предикаты. Больше всего выигрывают аналитические запросы с ограничением по времени, точечные запросы при высокой конкурентной нагрузке, поиск подстрок в длинных текстовых столбцах и соединения по схеме «звезда». Типичные ошибки: неуместное применение BloomFilter и партиции, в которые попадают все данные.
Подходящие сценарии
- Аналитические запросы с ограничением по времени к партиционированным таблицам. Кривая задержки выравнивается, как только предикат даты становится доступен планировщику.
- Точечные запросы при высокой конкурентной нагрузке к таблицам с хеш-распределением. Выбирайте ключ бакетирования в соответствии с наиболее частым предикатом равенства.
- Поиск подстрок в длинных текстовых столбцах. Добавьте NGram BloomFilter, чтобы
LIKE '%...%'выполнялся через проверку BloomFilter вместо сканирования столбца. - Соединения по схеме «звезда». Фильтры времени выполнения передают ключи меньшей стороны соединения в сканирование таблицы фактов.
Неудачные варианты применения
- BloomFilter для столбцов с малым числом уникальных значений (флаги состояния, пол). Фильтр всё равно пропускает почти каждую страницу, а место для его хранения расходуется впустую. Используйте встроенный ZoneMap или вовсе откажитесь от индекса.
- BloomFilter для предикатов диапазона. BloomFilter отвечает на вопрос «входит ли X в множество?», а не «меньше ли X, чем Y?». Для фильтров диапазона используется ZoneMap.
- Бакетирование по столбцу, по которому вы не фильтруете данные. Вы несёте затраты на хеш-распределение при записи, но не получаете отсечения при чтении. Выбирайте ключ бакетирования, соответствующий наиболее избирательному предикату равенства.
- Одна огромная партиция для всех данных. Планировщику нечего исключать, и компенсировать это приходится только отсечением таблетов и сегментов. Партиционируйте по столбцу, по которому запросы действительно фильтруют данные, обычно по времени.
- Использование BloomFilter вместо полнотекстового поиска. Для поиска фраз или токенов используйте инвертированный индекс; BloomFilter обрабатывает только равенство.
Дополнительные материалы
- Оптимизация отсечения партиций
- Обзор индексов: индексы для пропуска данных
- Индекс BloomFilter
- Индекс NGram BloomFilter
- Партиционирование и бакетирование: параметры DDL, определяющие, какие партиции и таблеты планировщик в принципе может отсечь.
- Инвертированный индекс: уровень проверки индекса, который превращает текстовые предикаты и предикаты равенства по столбцам с большим числом уникальных значений в поиск по спискам вхождений.
- Подробный разбор: отсечение данных в Apache Doris (блог)
- Архитектура MPP: где выполняется отсечение. Партиции и бакеты отсекаются в планировщике Nereids до отправки фрагментов.