Точечные запросы при высокой конкурентной нагрузке
Кратко Apache Doris представляет собой колоночный OLAP-движок, но при поиске по равенству первичного ключа он меняет подход. Объедините модель Unique Key с Merge-on-Write, хранением в строчном формате (
store_row_column), сокращённым путём выполнения запросов и сервернымPreparedStatement, и запросSELECT * FROM t WHERE pk = ?перестанет выполняться как OLAP-запрос. Один обмен с BE, одна строка в ответ, без разбора плана и планирования фрагментов. Так одна и та же база данных обслуживает и виджет дашборда, и агрегацию по таблице фактов без развёртывания второй базы данных.
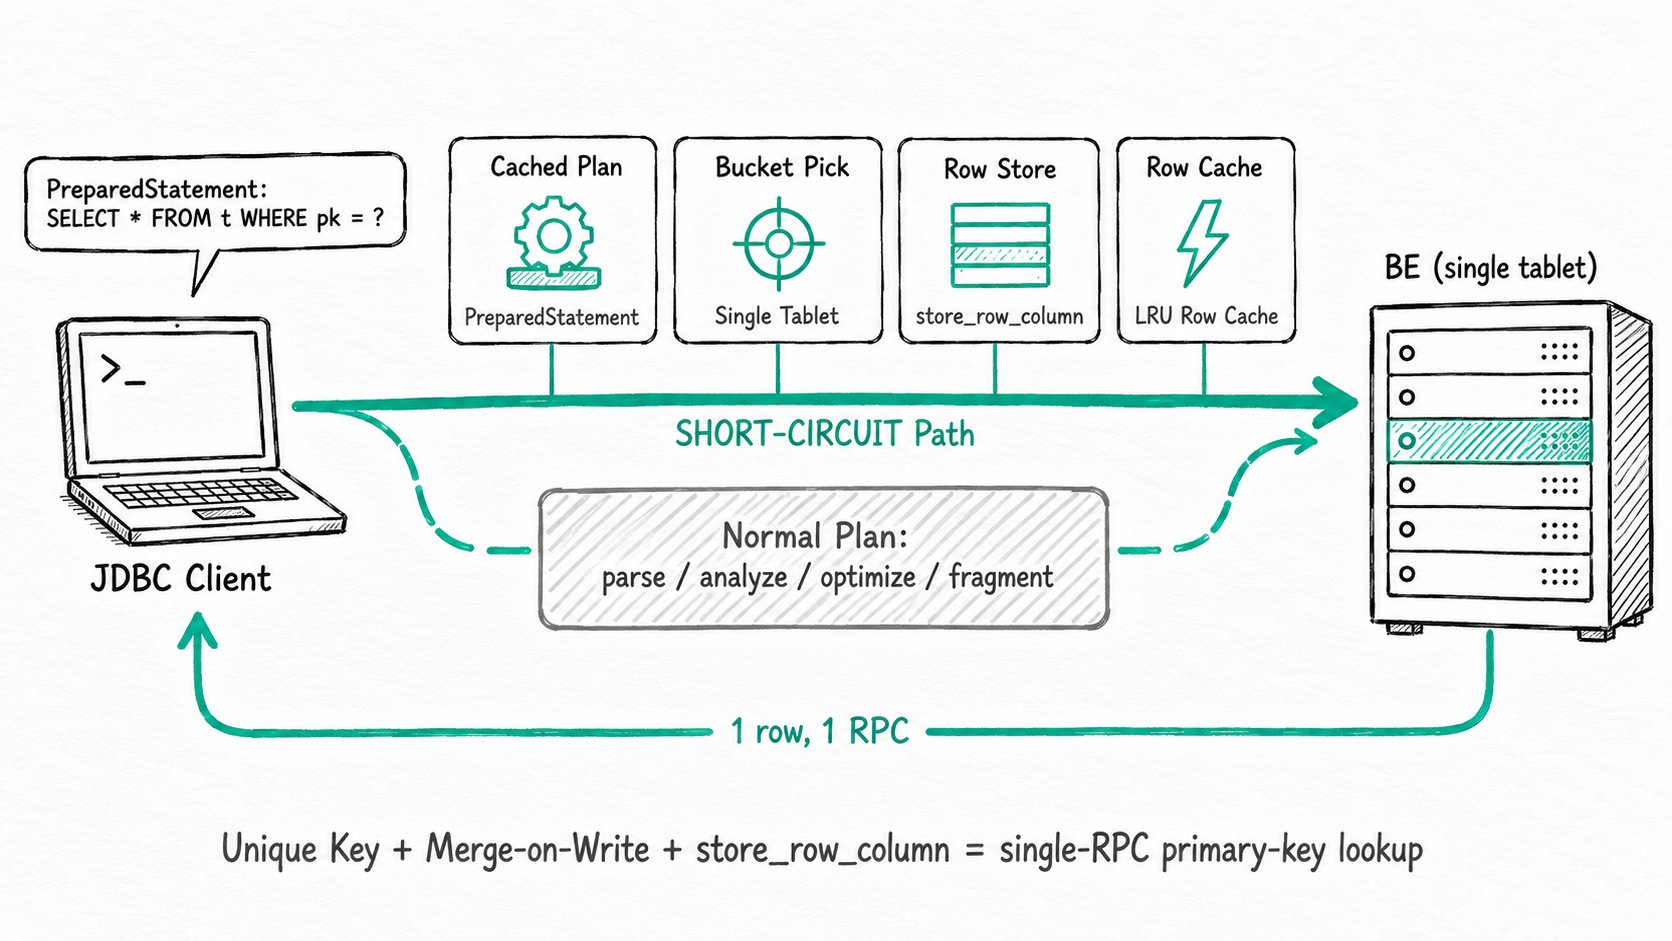
Зачем использовать точечные запросы при высокой конкурентной нагрузке в Apache Doris?
Путь выполнения точечных запросов при высокой конкурентной нагрузке в Apache Doris предназначен для многочисленных разрозненных запросов вида «найти одну строку по ID», которые встречаются в большинстве аналитических нагрузок. Пользовательский дашборд получает строку с данными клиента в ответ на его клик. Сервис оценки рисков при каждом вызове API считывает вектор признаков по ID сущности. Бэкенд системы рекомендаций получает актуальный профиль каждого пользователя. Ни один из этих запросов не является аналитическим, но их данные хранятся рядом с аналитическими данными, и никто не хочет запускать отдельное хранилище KV только для их обслуживания.
В стандартной конфигурации Apache Doris плохо подходит для такого потока запросов по причинам, заложенным в архитектуре:
- Колоночное хранение требует чтения множества небольших файлов столбцов для восстановления одной строки, увеличивая объём случайного IO для широких таблиц.
- Планировщик Frontend проходит один и тот же конвейер разбора, анализа, оптимизации и формирования фрагментов независимо от того, читает запрос одну строку или миллиард. При тысячах QPS CPU FE достигает предела загрузки ещё до того, как BE ощутит нагрузку.
- Каждый запрос создаёт собственный координатор, выделяет ресурсы для фрагментов и отправляет RPC. Для
WHERE id = 42такие накладные расходы неприемлемы. - Page Cache ориентирован на столбцы, а масштабные аналитические сканирования постоянно вытесняют его содержимое, поэтому точечные запросы не находят данные в кеше именно тогда, когда он им нужен.
Точечные запросы при высокой конкурентной нагрузке в Apache Doris решают эту задачу. Они меняют организацию хранения, планирование, выполнение и кеширование так, чтобы поиск по первичному ключу требовал одного обмена по сети и нескольких микросекунд процессорного времени FE.
Что такое точечные запросы при высокой конкурентной нагрузке в Apache Doris?
Точечные запросы при высокой конкурентной нагрузке в Apache Doris используют оптимизацию на четырёх уровнях, которая включается автоматически, когда таблица и запрос соответствуют строгим требованиям: таблица Unique Key с Merge-on-Write и включённым строчным хранением, а в запросе используются предикаты равенства, охватывающие весь первичный ключ. При выполнении этих условий планировщик выбирает сокращённый путь, а BE получает строку из столбца со строчным форматом вместо того, чтобы собирать её из файлов отдельных столбцов.
Основные термины
Unique Key model: модель таблиц Apache Doris, в которой строки адресуются по первичному ключу. Приenable_unique_key_merge_on_write=trueпоследняя версия каждой строки материализуется во время записи, поэтому при чтении не требуется объединять версии на лету.store_row_column: свойство таблицы, которое добавляет скрытый столбец, хранящий каждую строку в виде blob со строчным кодированием. Благодаря этому BE читает один столбец вместо N, чтобы вернуть целую строку.SHORT-CIRCUIT: метка в выводеEXPLAIN, которая появляется, когда планировщик обходит обычный распределённый план и направляет запрос по пути с одним tablet и одним RPC.PreparedStatement: серверное кеширование подготовленных запросов по протоколу MySQL. Apache Doris кеширует разобранный запрос, выражения результата и таблицу дескрипторов для каждой сессии, а затем повторно использует их при вызовахEXECUTE.Row Cache: отдельный кеш LRU, в котором хранятся целые строки. Он выдерживает давление вытеснения, которому подвергается колоночный Page Cache при смешанной нагрузке из аналитических и точечных запросов.
Как работают точечные запросы при высокой конкурентной нагрузке в Apache Doris?
Путь выполнения точечных запросов при высокой конкурентной нагрузке в Apache Doris объединяет пять уровней: организацию хранения, преобразование плана на FE, отправку по сокращённому пути, повторное использование серверного PreparedStatement и поиск строки на BE с необязательным Row Cache.
- Организация хранения. Если при создании таблицы задать
store_row_column=true, BE записывает каждую строку и в колоночные сегменты, и в скрытый столбец со строчным кодированием. Начиная с Apache Doris 3.0 можно ограничить строчное хранение подмножеством столбцов с помощьюrow_store_columns="k1,v1,v2", чтобы сократить накладные расходы на хранение. - Преобразование плана (FE). Правило Nereids
LogicalResultSinkToShortCircuitPointQueryпроверяет структуру запроса: одна таблица Unique, конъюнктивные условия равенства для каждого ключевого столбца, отсутствие соединений, подзапросов и агрегаций. Если все условия выполнены, правило устанавливает флагisShortCircuitQueryвStatementContext. - Отправка по сокращённому пути. Вместо создания и отправки фрагментов FE определяет бакет с помощью
PartitionPruneV2ForShortCircuitPlan, выбирает единственный tablet, в котором может находиться ключ, и отправляет один RPC на BE, которому принадлежит этот tablet. - Повторное использование серверного
PreparedStatement. ПриuseServerPrepStmts=trueFE кешируетShortCircuitQueryContextпо UUID сессии. Последующие вызовыEXECUTEполностью пропускают разбор и планирование; меняются только значения параметров. - Поиск строки на BE. Компонент
point_query_executorнаходит строку по ключу, читает столбец со строчным форматом и возвращает байты. Дополнительный Row Cache при попадании в кеш позволяет пропустить даже чтение сегмента.
Быстрый старт
CREATE TABLE tbl_point_query (
  k1 INT,
  v1 VARCHAR(64),
  v2 DECIMAL(27, 9)
)
UNIQUE KEY(k1)
DISTRIBUTED BY HASH(k1) BUCKETS 1
PROPERTIES (
  "enable_unique_key_merge_on_write" = "true",
  "light_schema_change" = "true",
  "store_row_column" = "true"
);

EXPLAIN SELECT * FROM tbl_point_query WHERE k1 = 42;
Ожидаемый результат (фрагмент)
0:VOlapScanNode
  TABLE: tbl_point_query, PREAGGREGATION: ON
  PREDICATES: k1 = 42 AND __DORIS_DELETE_SIGN__ = 0
  partitions=1/1, tablets=1/1
  SHORT-CIRCUIT
Главное здесь — строка SHORT-CIRCUIT. Если её нет, то при той же DDL запрос, не удовлетворяющий условиям (соединение, отсутствие ключевого столбца, неравенство), возвращается к обычному распределённому плану. Чтобы дополнительно снизить затраты CPU FE, подключите клиент со строкой подключения jdbc:mysql://host:9030/db?useServerPrepStmts=true&cachePrepStmts=true и используйте PreparedStatement с заполнителями ?. Убедитесь, что в fe.audit.log для повторных запросов записывается Stmt=EXECUTE(...), а не исходный SQL.
Когда следует использовать точечные запросы при высокой конкурентной нагрузке в Apache Doris?
Точечные запросы при высокой конкурентной нагрузке в Apache Doris подходят для любого онлайн-сервиса, который при каждом обращении читает строку по первичному ключу, особенно если данные уже находятся в таблице Unique Key, используемой также для аналитической нагрузки.
Подходит
- Онлайн-сервисы, которые при каждом обращении читают строку по первичному ключу: профили пользователей, векторы признаков, флаги состояния, справочные таблицы.
- Смешанные нагрузки из OLAP- и точечных запросов, при которых отдельное хранилище KV привело бы к дублированию данных и дополнительным затратам на эксплуатацию.
- Клиенты с высоким QPS, которые уже используют
PreparedStatementчерез JDBC. - Широкие таблицы Unique Key, для которых можно ограничить строчное хранение несколькими часто используемыми столбцами с помощью
row_store_columns.
Не подходит
- Диапазонные запросы (
k1 BETWEEN 1 AND 1000). Сокращённый путь требует равенства для каждого ключевого столбца. Выполняйте такие запросы через обычное сканирование и используйте отсечение данных. - Агрегации по нескольким строкам или соединения. Даже
GROUP BY pkисключает такое преобразование плана. Выполняйте их как обычные OLAP-запросы. - Поиск по неключевому столбцу. Добавьте вторичный или инвертированный индекс, а не строчное хранение.
- Таблицы, для которых при создании забыли включить строчное хранение. Свойство
store_row_columnможно задать только вCREATE TABLE. Если оно нужно для существующей таблицы, создайте её заново и повторно загрузите данные. - Нагрузки почти исключительно на запись, с редкими чтениями. Строчный формат увеличивает занимаемое место и IO при записи. Если поиск по ключу нужен редко, откажитесь от строчного формата и используйте только колоночное хранение.
Производительность и проверка
По данным Apache Doris, включение серверного PreparedStatement в дополнение к сокращённому пути выполнения повышает пропускную способность более чем в 4 раза, когда узким местом является CPU FE. Это тот же рост в 4 раза, который рассматривается со стороны подготовленных запросов в карточке «Подготовленные запросы»: единый совокупный эффект, а не два независимых прироста, которые можно совместить. Результаты зависят от ширины строки, доли попаданий в кеш строк и числа FE Observers, принимающих трафик, поэтому используйте эту оценку как нижний ориентир при планировании, а не как результат бенчмарка.
Две проверки позволяют убедиться, что этот путь используется:
EXPLAINдля запроса показываетSHORT-CIRCUITв узле сканирования.fe.audit.logпоказываетStmt=EXECUTE(...)для повторных поисков, а не исходную строку SQL.
Если производительность по-прежнему ограничена CPU FE, увеличьте число Observers и используйте балансировку нагрузки JDBC (jdbc:mysql:loadbalance://host1,host2,host3/db?useServerPrepStmts=true&cachePrepStmts=true), чтобы распределить соединения. В развёртываниях с разделением вычислений и хранения также рассмотрите настройку SET GLOBAL enable_snapshot_point_query=false и флаг BE enable_file_cache_keep_base_compaction_output=1, чтобы результат Base Compaction оставался в файловом кеше.
Дополнительные материалы
- Точечные запросы при высокой конкурентной нагрузке (полное руководство)
- Организация хранения Row Store
- Обзор индексов: вторичные, Bloom, инвертированные
- Отсечение данных: ускорение неточечных запросов
- Архитектура MPP: полный путь распределённого выполнения, который позволяет обойти сокращённый путь точечных запросов.
- Unique Key: модель таблиц, которая в сочетании с точечными запросами и свойством
store_row_columnпозволяет использовать таблицу как хранилище KV.