Инвертированный индекс
Кратко Инвертированный индекс Apache Doris представляет собой вторичный индекс на базе CLucene, который объявляется для любого столбца с помощью
INDEX ... USING INVERTED. Индекс ускоряет проверку равенства, попадания в диапазон,IN,IS NULL, вхождения элементов в массив и условий полнотекстового поискаMATCH_*, считывая список вхождений вместо сканирования строк. Доступен с Apache Doris 2.0.
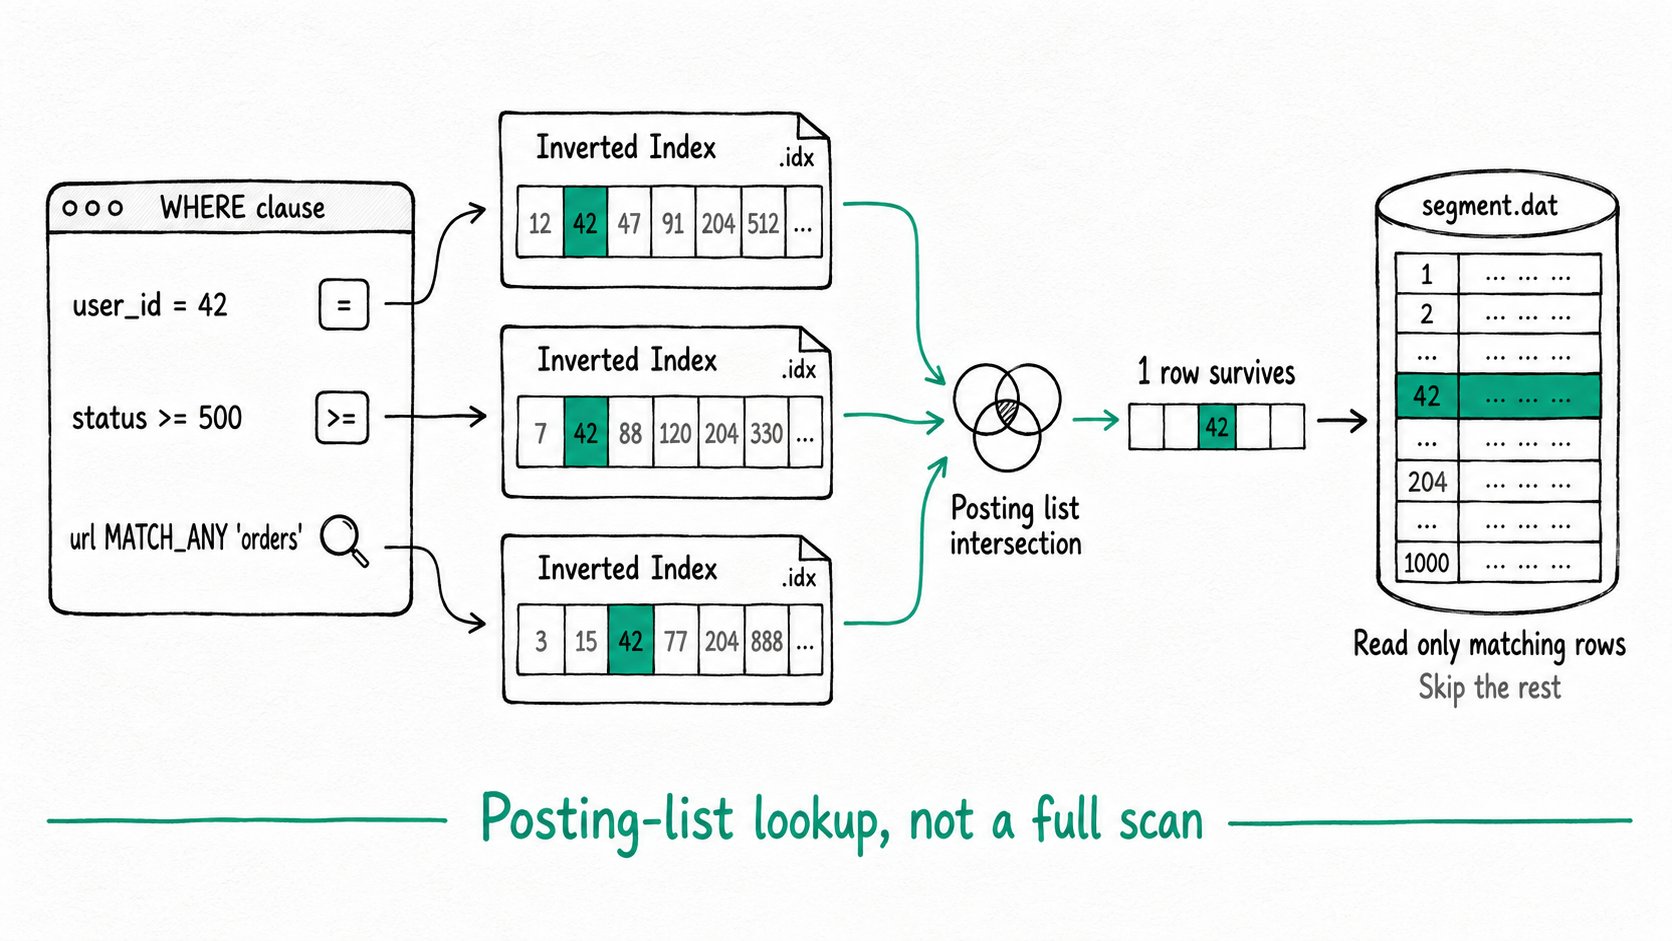
Зачем использовать инвертированный индекс в Apache Doris?
Инвертированный индекс Apache Doris заменяет полное сканирование поиском по спискам вхождений при выполнении самой затратной операции OLAP-запросов: проверке условий WHERE. Без него для таблицы событий объёмом 2 TB с условием по user_id, диапазоном по request_time и поиском по ключевым словам в url пришлось бы декодировать каждый столбец каждой строки во всех сегментах, оставшихся после отсева. Обычный обходной путь, инкрементальное материализованное представление или отдельный поисковый кластер, удваивает затраты на хранение и эксплуатацию.
Проблемные сценарии:
- Поиск по равенству в столбцах с высокой кардинальностью (
WHERE order_id = ?) приводит к сканированию tablet целиком, поскольку дешёвого способа отсеять сегменты нет. - Фильтры по диапазону для числовых столбцов или столбцов даты и времени (
WHERE event_time BETWEEN ...) ограничиваются лишь минимумом и максимумом ZoneMap и всё равно обращаются к каждой странице в пределах диапазона. - Базовый SQL-движок не предоставляет средств для поиска по ключевым словам в текстовых столбцах.
LIKE '%term%'приводит к сканированию, а передача данных в Elasticsearch требует второго конвейера, который нужно поддерживать в синхронизированном состоянии.
Инвертированный индекс Apache Doris решает все три задачи с помощью одного и того же DDL.
Что такое инвертированный индекс Apache Doris?
Инвертированный индекс Apache Doris представляет собой вторичный индекс на уровне столбца, который сопоставляет каждое значение, а для текстовых столбцов каждый терм, полученный при токенизации, с множеством идентификаторов строк, в которых оно встречается. Он построен на базе CLucene, порта Lucene на C++, и полностью интегрирован со столбцовым хранилищем и векторизованным выполнением запросов Apache Doris.
Инвертированный индекс объявляется в DDL с помощью INDEX <name>(<col>) USING INVERTED [PROPERTIES(...)]. Поддерживаются целочисленные типы, DECIMAL, DATE, DATETIME, TIMESTAMP_NS, IPV4, IPV6, CHAR/VARCHAR/STRING, а также ARRAY<T> с элементами этих типов. Для текстовых столбцов можно задать parser, управляющий токенизацией.
Основные термины
Posting list: множество идентификаторов строк, связанное со значением или термом. Проверка условия сводится к поиску по списку вхождений и операции над множествами (AND/OR/NOT).Parser: токенизатор для текстовых столбцов. Встроенные варианты:none(строка целиком, по умолчанию),english,chinese,kuromoji(японский, с версии 5.0.0),unicode,standard; с версии 3.1 также доступны пользовательские анализаторы.MATCH operators:MATCH_ANY(любой терм),MATCH_ALL(все термы),MATCH_PHRASE(соседние термы),MATCH_PHRASE_PREFIX,MATCH_REGEXP. Для них нужен инвертированный индекс с парсером; для обычных=иLIKEон не требуется..idx file: данные индекса на диске. Один файл.idxхранится рядом с каждым файлом сегмента в каталоге tablet, поэтому индекс привязан к сегменту и следует за rowset при compaction.
Как работает инвертированный индекс Apache Doris?
Инвертированный индекс Apache Doris строится один раз и многократно используется для поиска, при этом он хранится рядом с индексируемым сегментом.
- Построение при записи. При сбросе rowset на диск BE записывает индекс в формате CLucene в файл
.idxрядом с сегментом. Каждая строка сегмента сопоставляется в отношении 1:1 с CLuceneDocID, поэтому индексу не нужна отдельная таблица соответствия строк и документов. - Выбор способа обработки при выполнении запроса. Для условия, которое планировщик проталкивает на уровень хранения, BE сначала обращается к инвертированному индексу: токенизирует литерал тем же парсером, который использовался при построении, просматривает словарь термов и считывает список вхождений.
- Объединение с помощью операций над множествами.
AND,ORиNOTмежду условиями преобразуются в пересечения, объединения и дополнения списков вхождений без обращения к данным столбцов. - Передача сканеру битовой карты строк. Сканер считывает из столбцового хранилища только строки, оставшиеся после фильтрации. Результаты ZoneMap, BloomFilter и инвертированного индекса можно сочетать: каждый из них сокращает объём работы следующего уровня.
- Хранение в пределах сегмента. Поскольку индексы находятся рядом с сегментами, compaction объединяет их вместе с данными, а при переносе на удалённый уровень хранения они следуют за данными. Глобального индекса, который нужно было бы перестраивать, нет.
Быстрый старт
CREATE TABLE access_log (
  ts        DATETIME    NOT NULL,
  user_id   BIGINT      NOT NULL,
  status    INT         NOT NULL,
  url       STRING      NOT NULL,
  INDEX idx_user(user_id)  USING INVERTED,
  INDEX idx_status(status) USING INVERTED,
  INDEX idx_url(url) USING INVERTED PROPERTIES("parser"="english")
) DUPLICATE KEY(ts) DISTRIBUTED BY HASH(user_id) BUCKETS 4;

INSERT INTO access_log VALUES
  ('2026-05-01 10:00:00', 42, 200, '/api/orders/list'),
  ('2026-05-01 10:01:00', 42, 500, '/api/orders/create'),
  ('2026-05-01 10:02:00', 99, 200, '/api/users/profile');

SELECT user_id, status, url FROM access_log
WHERE user_id = 42 AND status >= 500 AND url MATCH_ANY 'orders';
Ожидаемый результат
+---------+--------+---------------------+
| user_id | status | url                 |
+---------+--------+---------------------+
|      42 |    500 | /api/orders/create  |
+---------+--------+---------------------+
Для каждого условия выполняется поиск по индексу. user_id = 42 и status >= 500 используют инвертированный индекс для проверки равенства и попадания в диапазон. url MATCH_ANY 'orders' токенизирует столбец парсером english и находит список вхождений для orders. Сканер считывает только одну строку, оставшуюся после пересечения трёх списков вхождений по AND.
Когда следует использовать инвертированный индекс Apache Doris?
Инвертированный индекс Apache Doris окупается при фильтрации по столбцам с высокой кардинальностью, поиске по тексту и массивам, а также для любых столбцов, где отсев с помощью ZoneMap слишком грубый.
Подходящие случаи
- Проверки равенства и
INдля неключевых столбцов с высокой кардинальностью:order_id,trace_id,device_id. - Фильтры по диапазону и
BETWEENдля числовых столбцов или столбцовDATETIME, где одного ZoneMap недостаточно для точного отсева. IS NULL/IS NOT NULLдля разреженных столбцов; индекс хранит сведения о значениях NULL и выполняет поиск по ним за O(1).- Поиск по ключевым словам и фразам в столбцах с журналами, документами и другим содержимым. Набор операторов описан в разделе Полнотекстовый поиск, а ранжирование по релевантности в разделе Оценка BM25.
- Условия вхождения элементов в массив:
array_contains(tags, 'x')иarray_overlaps(tags, ['a','b']).
Неподходящие случаи
LIKE '%abc%'с подстановочным символом в начале шаблона. Инвертированный индекс не ускоряет поиск подстрок с помощьюLIKE; используйте индекс NGram BloomFilter.- Столбец, по которому таблицу фильтруют чаще всего. Сделайте его столбцом Key, чтобы его обслуживал префиксный индекс; префиксный индекс компактнее и не требует дополнительных затрат.
- Небольшие таблицы (несколько миллионов строк), для которых полное сканирование завершается за миллисекунды. Индекс окупается, только когда объём пропускаемых благодаря ему данных намного превышает затраты на поиск по нему.
- Столбцы, для которых условие уже соответствует большинству строк. Списки вхождений дают выигрыш, когда они короткие; если после фильтрации остаётся 80% строк, сканер в любом случае выполняет ту же работу.
- Таблицы с ограниченным объёмом хранилища: инвертированный индекс для широкого текстового столбца может быть сопоставим по размеру с самим столбцом. Если занимаемый объём важнее поиска по тексту, используйте индекс BloomFilter.
Дополнительные материалы
- Руководство пользователя по инвертированному индексу: полный синтаксис DDL, параметры парсеров и команды управления.
- Справочник операторов поиска: каждый оператор
MATCH_*с примерами. - Обзор индексов: сравнение инвертированного индекса с префиксным индексом, ZoneMap, BloomFilter и NGram BloomFilter.
- Полнотекстовый поиск: токенизаторы, фразовые запросы и DSL
SEARCH(), построенный на базе этого индекса. - Оценка релевантности BM25: ранжирование совпадений с помощью
score(), доступное с версии 4.0. - Гибридный поиск: сочетание инвертированного индекса с векторным индексом ANN в одном SQL-запросе.
- Как работает инвертированный индекс в Apache Doris: подробный разбор внутреннего устройства и результатов тестирования производительности.