Управление таблицами озера данных
Кратко После подключения каталога озера данных Apache Doris работает с таблицами Iceberg, Hive и Paimon как с полноценными объектами. Поддерживаются
CREATE TABLE,INSERT,INSERT OVERWRITE,UPDATE,DELETE, эволюция схемы и партиционирования, ветви и теги Iceberg, time travel по снимкам и операции обслуживания, такие какexpire_snapshotsиrewrite_data_files. Все изменения метаданных фиксируются через каталог (HMS, Glue, REST, JDBC), поэтому Trino, Spark и Flink видят одни и те же записанные данные.
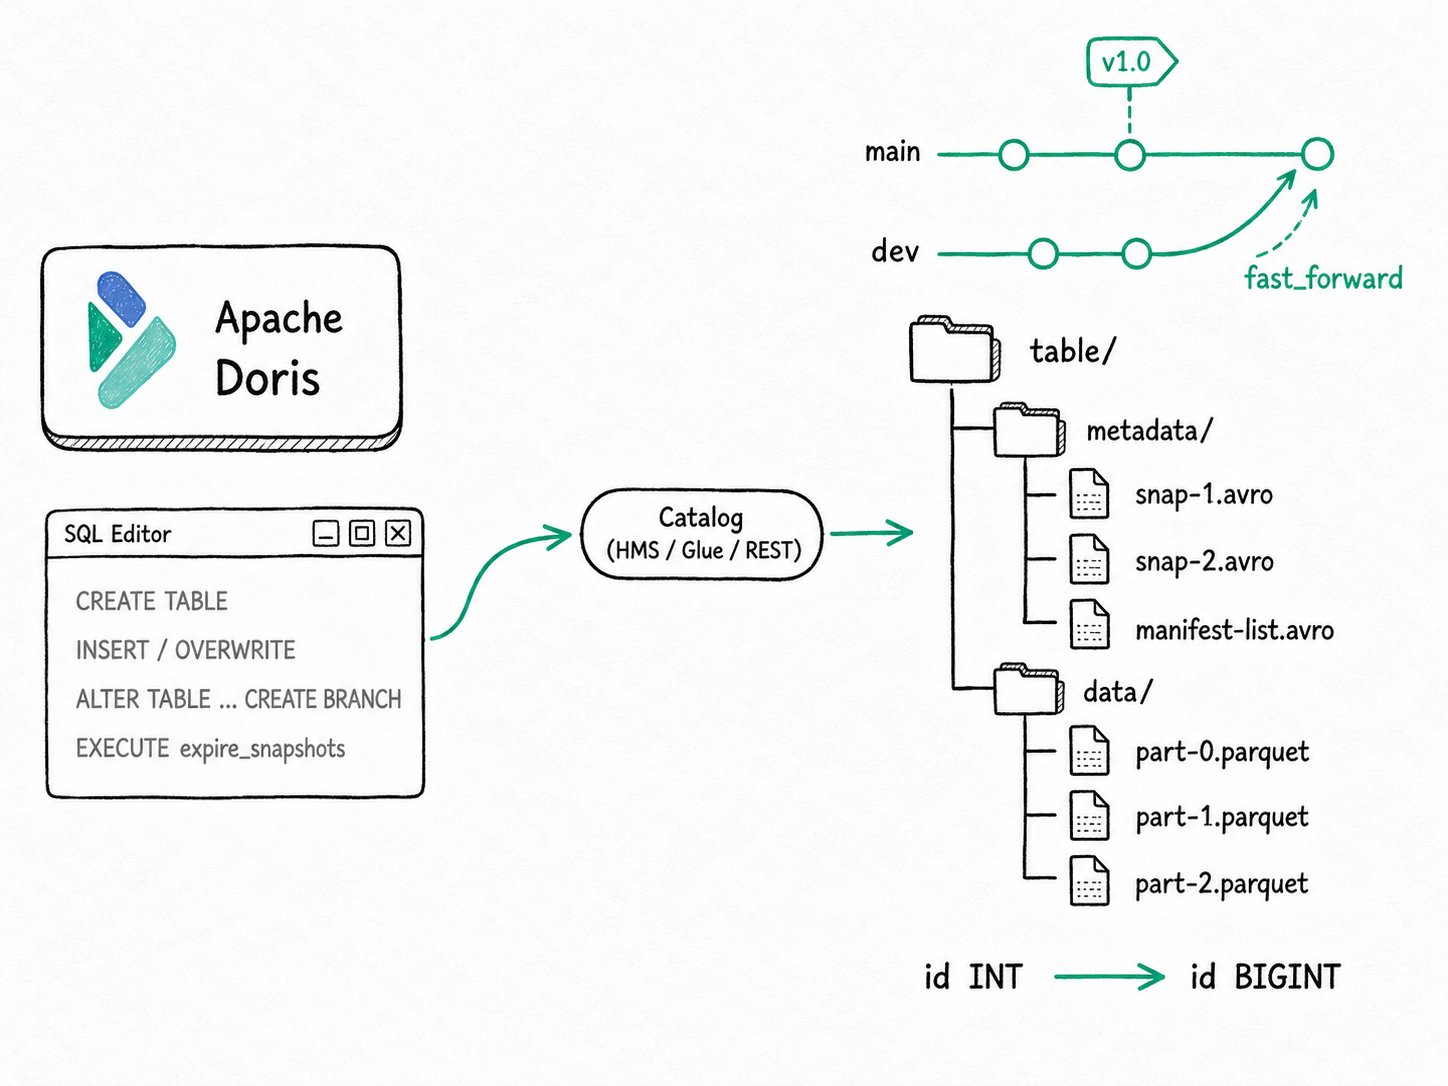
Зачем использовать Apache Doris для управления таблицами озера данных?
Управление таблицами озера данных в Apache Doris позволяет одному кластеру выполнять и федеративное чтение, и запись в озеро данных через SQL. Командам больше не нужно запускать отдельный кластер Spark или Flink только для изменения таблиц Iceberg, Hive или Paimon. Большинство движков lakehouse изначально поддерживают чтение. Вы подключаете их к каталогу Iceberg, выполняете запросы к нескольким таблицам, а затем сталкиваетесь с одним и тем же ограничением: любая запись должна выполняться через Spark или Flink. В результате приходится обслуживать два кластера, изучать два диалекта SQL и согласовывать два набора разрешений для одних и тех же данных. Объединение нескольких каталогов на основе интеграций с каталогами отвечает за чтение; эта карточка посвящена записи.
Apache Doris поддерживает оба направления. Тот же SQL, которым вы запрашиваете внутреннюю таблицу Doris, позволяет создать таблицу Iceberg, добавить строки, перезаписать партицию, изменить схему, создать ветвь, удалить старые снимки и объединить мелкие файлы. Кластер, обслуживающий дашборды, также поддерживает озеро данных в рабочем состоянии.
- Один движок для федеративного чтения и записи в озеро данных без отдельного задания Spark на каждом этапе ETL.
- Стандартные SQL DDL и DML для Iceberg, Hive и Paimon, поэтому команде не приходится изучать новый диалект для каждого формата.
- Фиксация изменений через каталог. Результат
INSERT, выполненного Apache Doris в Iceberg, становится виден в Trino, Spark и Flink без дополнительной синхронизации.
Что представляет собой управление таблицами озера данных в Apache Doris?
Управление таблицами озера данных в Apache Doris охватывает операции записи и управления жизненным циклом, которые движок предоставляет поверх внешнего каталога: DDL, DML, эволюцию схемы, ветви, теги и обслуживание с помощью действий над таблицами. После того как CREATE CATALOG подключает Apache Doris к HMS, Glue, REST, JDBC, S3 Tables или DLF, каталог становится пространством имён с возможностью записи. Apache Doris преобразует CREATE TABLE, ALTER TABLE, INSERT, UPDATE, DELETE и MERGE INTO в соответствующие формату операции записи манифестов, фиксации снимков и вызовы metastore.
Подробнее о самом подключении см. в разделах Работа с несколькими каталогами (Multi Catalog) и Обзор lakehouse. Эта карточка посвящена действиям, доступным после подключения каталога.
Основные термины
Catalog: объект подключения, который связывает Apache Doris с metastore и системой хранения. Изменения фиксируются через API каталога.Snapshot: неизменяемая версия таблицы Iceberg или Paimon. Каждая запись создаёт новую версию; при чтении можно выбрать конкретный снимок.BranchиTag: именованные ссылки на снимки в Iceberg и Paimon. Ссылка ветви обновляется при новых коммитах, а ссылка тега остаётся фиксированной.Schema evolution: добавление, удаление, переименование столбцов или расширение их типов без перезаписи файлов данных.Table action: операция обслуживания, вызываемая черезALTER TABLE ... EXECUTE, напримерexpire_snapshots,rewrite_data_filesилиrewrite_manifests.
Как работает управление таблицами озера данных в Apache Doris?
Управление таблицами озера данных в Apache Doris состоит из пяти этапов: подключение каталога, планирование с учётом формата, подготовка файлов данных на узлах BE, атомарная фиксация через API каталога и обслуживание таблиц на месте с помощью SQL.
- Подключение каталога.
CREATE CATALOG iceberg_ctl PROPERTIES (...)регистрирует metastore и систему хранения. Apache Doris кеширует метаданные, но изменения всегда фиксируются через API каталога, чтобы другие движки видели актуальное состояние. - Планирование с учётом формата. Планировщик Nereids распознаёт внешнюю таблицу и направляет оператор в механизм записи соответствующего формата: фиксацию манифестов Iceberg, фиксацию дельт Paimon или перезапись партиций Hive.
- Подготовка файлов данных. Компоненты записи BE создают файлы данных Parquet (или ORC для Hive) в расположении таблицы. Удаления в Iceberg V2 записываются в файлы Position Delete, удаления в V3 записываются в Puffin Deletion Vectors, а Paimon записывает сегменты LSM-tree.
- Атомарная фиксация. FE формирует список манифестов и запрашивает у каталога замену указателя на таблицу. Если фиксация конфликтует с параллельной записью, Apache Doris обнаруживает несовпадение снимков, и оператор корректно завершается с ошибкой.
- Обслуживание на месте. Операции обслуживания выполняются через SQL в том же кластере:
EXECUTE expire_snapshots,EXECUTE rewrite_data_files,EXECUTE rewrite_manifests,ALTER TABLE ... CREATE BRANCHи так далее.
Набор поддерживаемых возможностей зависит от формата. Наиболее полная поддержка у Iceberg: все операции DDL и DML, стратегии удаления V2 и V3, ветви, теги, эволюция партиционирования и действия над таблицами. Paimon поддерживает чтение, time travel, ветви и теги через Apache Doris; запись в таблицы Paimon с первичным ключом по-прежнему выполняется через Flink. Hive поддерживает CREATE, INSERT, INSERT OVERWRITE и CTAS, но запись в конкретные партиции и параллельные операции INSERT OVERWRITE для одной партиции требуют такой же осторожности, как при работе через Spark или сам Hive. Для Hudi сейчас доступно только чтение.
Быстрый старт
SWITCH iceberg_ctl;
CREATE DATABASE IF NOT EXISTS sales;
CREATE TABLE sales.orders (
  order_id BIGINT, region STRING, amount DECIMAL(10,2), ts DATETIME
) PARTITION BY LIST (day(ts), region) ();

INSERT INTO sales.orders VALUES (1, 'bj', 99.50, '2026-05-08 10:00:00');
ALTER TABLE sales.orders CREATE BRANCH dev;
INSERT INTO sales.orders@branch(dev) VALUES (2, 'sh', 12.00, '2026-05-08 11:00:00');

SELECT COUNT(*) FROM sales.orders;             -- main branch
SELECT COUNT(*) FROM sales.orders@branch(dev); -- dev branch
ALTER TABLE sales.orders EXECUTE expire_snapshots ("retain_last" = "5");
Ожидаемый результат
+----------+
| count(*) |
+----------+
|        1 |   -- main
|        2 |   -- dev
+----------+
Ветвь main сохраняет строку с рабочими данными, ветвь dev содержит дополнительную строку, а expire_snapshots удаляет старые метаданные. Trino или Spark, подключённые к тому же каталогу REST или HMS, прочитают те же снимки, которые только что создал Doris.
Когда стоит использовать Apache Doris для управления таблицами озера данных?
Управление таблицами озера данных в Apache Doris подходит для федеративного ELT с записью в Iceberg или Hive, использования ветвей Iceberg в стиле git при разработке, воспроизводимого чтения с помощью time travel, обслуживания по расписанию с помощью expire_snapshots и rewrite_data_files, а также эволюции схемы и партиционирования через SQL. Оно не подходит для высококонкурентных обновлений отдельных строк в стиле OLTP, CDC в реальном времени в обычные таблицы Hive или любой записи в Hudi (сейчас доступно только чтение).
Подходящие сценарии
- Федеративные конвейеры ELT, которые читают данные из каталогов JDBC или Kafka и записывают подготовленные данные в Iceberg или Hive, не выходя за пределы Apache Doris. Сценарий обратной записи описан в разделе Обзор lakehouse.
- Командные процессы, которым нужна изоляция в стиле git в Iceberg: выполните
ALTER TABLE ... CREATE BRANCH dev, проверьте данные в ветви dev, затем выполнитеEXECUTE fast_forwardдля публикации. - Чтение с помощью time travel и воспроизводимое заполнение исторических данных с использованием
FOR VERSION AS OFилиFOR TIME AS OFв Iceberg, Paimon и Hudi. - Обслуживание по расписанию: еженощный запуск
expire_snapshots, ежечасный запускrewrite_data_filesдля объединения мелких файлов от потоковых заданий, периодический запускrewrite_manifestsпосле масштабного перераспределения партиций. - Эволюция схемы и партиционирования через привычный SQL:
ADD COLUMN,MODIFY COLUMN,ADD PARTITION KEY day(ts),REPLACE PARTITION KEY ts_day WITH day(ts).
Неподходящие сценарии
- Высококонкурентные обновления отдельных строк в стиле OLTP. Фиксация изменений в озере данных основана на снимках, поэтому накладные расходы на каждый оператор слишком велики. Для такой нагрузки используйте таблицу Unique Key в Apache Doris.
- Построчные операции upsert в реальном времени в Hive. Hive не поддерживает файлы удалений или merge-on-read. Если CDC требует построчной записи, используйте Iceberg V2 или V3 либо таблицы Paimon с первичным ключом.
INSERT INTOс указанием конкретной партиции в Hive. Apache Doris выбирает партицию для записи на основе значений столбцов, а не предложенияPARTITION (...); если нужна явная маршрутизация по партициям Hive, используйтеINSERT OVERWRITEили выполняйте загрузку через Spark.- Параллельные операции
INSERT OVERWRITEдля одной и той же партиции Hive из нескольких источников записи. В Hive нет атомарной замены данных партиции, поэтому результат может оказаться неполным; выполняйте запись последовательно или переведите эту таблицу на Iceberg. - Запись в Hudi. Apache Doris сейчас поддерживает только чтение Hudi; для записи в Hudi используйте Spark или Flink.
Дополнительные материалы
- Работа с несколькими каталогами (Multi Catalog): как Doris объединяет внешние каталоги и направляет запросы между ними.
- Справочник по каталогу Iceberg: полный синтаксис DDL, DML, работы с ветвями и тегами и действий над таблицами с примечаниями о версиях.
- Справочник по каталогу Hive: семантика записи, поддержка транзакционных таблиц, правила параллельной записи.
- Справочник по каталогу Paimon: чтение, time travel, пакетное инкрементальное чтение, ветви и теги, системные таблицы.
- Обзор lakehouse: место управляемых таблиц озера данных в общей архитектуре федеративной аналитики.
- Обновление и удаление данных: аналогичные возможности внутренних таблиц для частых изменений на уровне строк.
- Iceberg: возможности, специфичные для Iceberg: семь вариантов каталога, удаления V2/V3, ветви, теги и time travel.