Архитектура MPP
Кратко MPP в Apache Doris превращает один SQL-запрос в DAG из
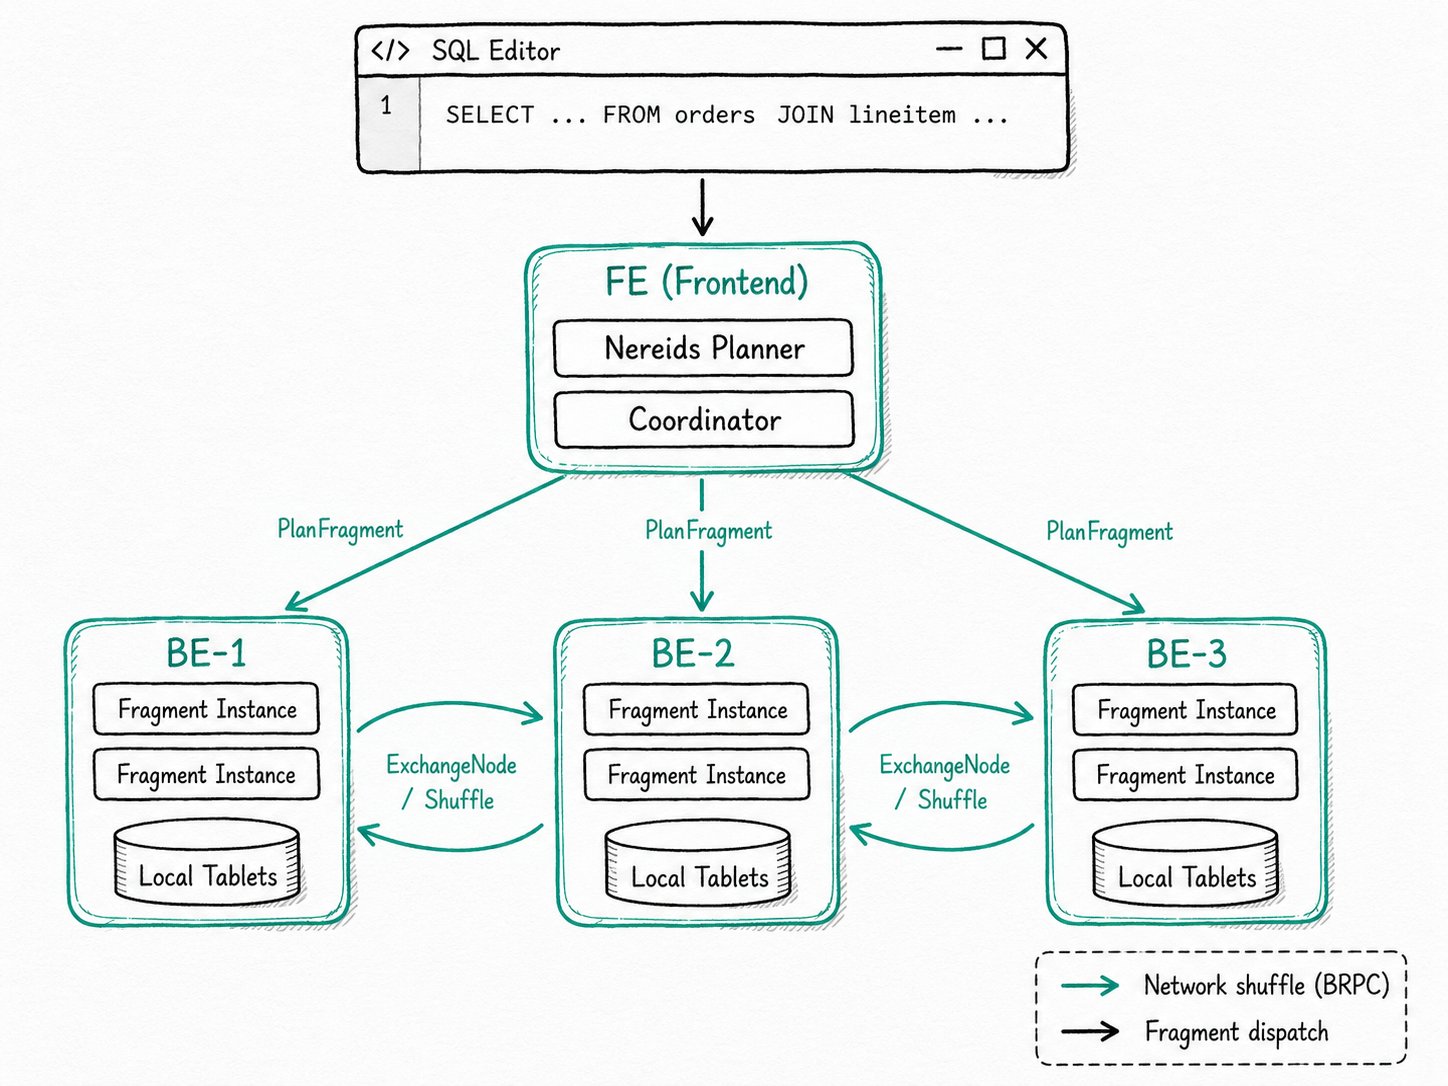
PlanFragment, которые выполняются параллельно на всех BE кластера. КомпонентCoordinatorна стороне FE строит план DAG с помощью оптимизатора Nereids, отправляет каждый фрагмент на соответствующие BE по BRPC и связывает фрагменты посредством перераспределения данных (shuffle) черезExchangeNode+DataStreamSink. Архитектура хранения shared-nothing и лимит памяти на запрос (exec_mem_limit, по умолчанию 2 GB) позволяют масштабировать кластер горизонтально: каждый добавленный BE пополняет общий пул ресурсов для запросов вычислительными ресурсами CPU, памятью и локальными таблетами.
Зачем использовать MPP в Apache Doris?
MPP в Apache Doris позволяет одному аналитическому запросу использовать все CPU кластера вместо ресурсов одной машины. Агрегация по 10 миллиардам строк, соединение пяти таблиц фактов, широкий GROUP BY по журналам за год: ни одна из этих задач не завершится за приемлемое время на одном узле. Слой MPP позволяет перейти от «купить сервер помощнее» к «добавить BE».
Он решает вполне конкретные проблемы:
- Возможности планировщиков для одного узла ограничены. Для запроса, который обращается к терабайту данных в колоночном формате, работу по сканированию, фильтрации, соединению и агрегации нужно распределять между машинами, а не сосредотачивать на одной.
- Ручное шардирование создаёт дополнительную нагрузку на команду данных. Написанные вручную запросы с UNION по таблицам отдельных шардов работают до тех пор, пока не изменятся ключи соединения или не начнётся перебалансировка шарда.
- Узкие места на стороне хранения мешают использовать вычислительные ресурсы. Если для вычислений собирать данные шардов на одном сервере, сеть выполняет работу, которую кластер мог бы выполнить на месте.
MPP в Apache Doris позволяет планировщику разделять запрос на части, переносить вычисления к данным и перераспределять лишь те строки, которые действительно нужно передать по сети.
Что представляет собой архитектура MPP в Apache Doris?
MPP в Apache Doris представляет собой модель распределённого выполнения shared-nothing, в которой Frontend (FE) планирует запрос как DAG из PlanFragment, а узлы Backend (BE) параллельно выполняют эти фрагменты на своих локальных таблетах. Оптимизатор Nereids компилирует SQL в логический план, разделяет его по границам перераспределения данных, а Coordinator на FE назначает выполнение каждого PlanFragment группе BE. Каждый BE создаёт для фрагмента один или несколько экземпляров фрагмента, которые затем выполняются в его потоках под управлением внутреннего планировщика конвейеров BE. Данные пересекают границы фрагментов через ExchangeNode (на стороне получателя) и DataStreamSink (на стороне отправителя), сериализуются в Block и передаются по BRPC.
Основные термины
PlanFragment: наименьшая единица распределённой работы, которую FE отправляет на BE. Одному запросу соответствует один DAG фрагментов.- Экземпляр фрагмента: копия
PlanFragment, выполняемая на одном BE. Несколько экземпляров одного фрагмента на разных BE обеспечивают горизонтальный параллелизм. Coordinator: объект на стороне FE, который строит DAG фрагментов, назначает BE, отправляет фрагменты, собирает результаты и обрабатывает сбои. Реализован вfe/fe-core/src/main/java/org/apache/doris/qe/Coordinator.java.ExchangeNode/DataStreamSink: пара получатель / отправитель, которая передаёт данные между фрагментами по сети. Планировщик вставляет их на каждой границе перераспределения данных.- Режим распределения: способ маршрутизации строк по сети при перераспределении данных:
UNPARTITIONED,RANDOM,HASH_PARTITIONEDилиBUCKET_SHFFULE_HASH_PARTITIONED. - Планировщик Nereids: оптимизатор на основе стоимостной модели, построенный по принципам Cascades и выбирающий порядок соединений, способ перераспределения данных и степень параллелизма. Старый планировщик удалён; переключатель
enable_nereids_plannerпомечен какREMOVED.
Как работает архитектура MPP в Apache Doris?
Работа MPP в Apache Doris состоит из пяти этапов: FE строит план, разделяет его на фрагменты и отправляет их; каждый BE преобразует свой фрагмент в задачи конвейера; таблеты сканируются локально; данные перераспределяются через ExchangeNode только там, где этого требует план; единственный корневой фрагмент возвращает результат клиенту.
- Построение и разделение плана. Оптимизатор Nereids преобразует SQL в физический план, а FE обходит дерево и разделяет его на
PlanFragmentво всех точках, где необходимо перераспределить данные (агрегация, для которой все ключи должны находиться на одной машине; хеш-соединение, для которого обе стороны должны быть одинаково распределены по хешу; конечный приёмник результата). - Выбор способа перераспределения данных. На каждой границе фрагментов планировщик выбирает один из четырёх режимов распределения, а для хеш-соединений выбирает одну из четырёх стратегий: Broadcast Join (копирование правой стороны в каждый экземпляр левой), Shuffle Join (распределение обеих сторон по хешу ключа соединения), Bucket Shuffle Join (использование существующего распределения левой таблицы по бакетам, чтобы передавать только правую сторону) или Colocate Join (полный отказ от перераспределения, поскольку обе таблицы уже находятся на одних и тех же BE). Выбор определяется оценкой стоимости.
- Отправка и создание экземпляров.
Coordinatorотправляет каждый фрагмент назначенным ему BE по BRPC. Каждый BE создаёт экземпляры фрагмента, по одному на каждый слот параллелизма, и передаёт их в Pipeline Execution Engine для планирования выполнения. - Локальное сканирование и перераспределение по необходимости. Операторы сканирования читают таблеты, расположенные на том же BE, поэтому основной объём данных не передаётся по сети. Только строки, необходимые следующему фрагменту и сериализованные в колоночные
Block, передаются по сети черезDataStreamSink→ExchangeNode. - Возврат результата. Корневой фрагмент с приёмником
UNPARTITIONEDвыполняется на одном BE, собирает объединённый результат и возвращает его в FE, который передаёт его клиенту потоком по протоколу MySQL.
Быстрый старт
Включать ничего не требуется: все запросы выполняются с использованием MPP. Для администрирования особенно полезен EXPLAIN: он показывает DAG фрагментов, режимы распределения и стратегии перераспределения данных, выбранные оптимизатором.
EXPLAIN
SELECT o.o_orderpriority, COUNT(*) AS orders, SUM(l.l_extendedprice) AS revenue
FROM   orders o
JOIN   lineitem l ON o.o_orderkey = l.l_orderkey
WHERE  o.o_orderdate >= '2026-01-01'
GROUP BY o.o_orderpriority
ORDER BY revenue DESC
LIMIT 10;
Ожидаемый результат (сокращённо)
PLAN FRAGMENT 2  (BUCKET_SHFFULE_HASH_PARTITIONED on o_orderkey)
  HASH JOIN   join op: INNER JOIN  ... (Bucket Shuffle)
    SCAN orders  (partitions=12, tablets=120, ...)
    EXCHANGE  HASH_PARTITIONED  <-- from FRAGMENT 1
PLAN FRAGMENT 1  (RANDOM)
  SCAN lineitem  (partitions=48, tablets=480, ...)
PLAN FRAGMENT 0  (UNPARTITIONED)
  RESULT SINK
  AGGREGATE (merge finalize)
    EXCHANGE  HASH_PARTITIONED  <-- from FRAGMENT 2
Три фрагмента. Фрагмент 1 сканирует lineitem на каждом BE, где хранится таблета, хеширует строки по l_orderkey и передаёт их во фрагмент 2 через Exchange. Фрагмент 2 соединяет их с orders с помощью Bucket Shuffle (таблица orders разбита на бакеты по o_orderkey, поэтому её таблеты не перемещаются), выполняет предварительную агрегацию по o_orderpriority и передаёт частичные группы во фрагмент 0. Фрагмент 0 завершает агрегацию, выполняет сортировку и записывает результат.
Когда следует использовать архитектуру MPP в Apache Doris?
MPP в Apache Doris является режимом выполнения по умолчанию для всех аналитических запросов: другого пути для обычных SELECT-запросов нет. При настройке учитывайте принципы работы MPP.
Хорошо подходит
- Аналитическое сканирование от десятков миллионов до миллиардов строк. Широкие GROUP BY, большие соединения, агрегации по временным окнам.
- Соединения в схемах «звезда» и «снежинка». Выбор Bucket Shuffle или Colocate Join вместо Broadcast как раз относится к задачам оптимизатора Nereids.
- Кластеры с несколькими арендаторами, в которых запросы должны выполняться на всех BE. Сочетайте MPP с группами рабочих нагрузок (Workload Group) для изоляции CPU и памяти между арендаторами.
- Длительные запросы к данным с перекосом распределения. Выбранные планировщиком MPP способы перераспределения данных учитываются механизмом Local Shuffle на BE, который сглаживает перекос внутри каждого BE.
Плохо подходит
- Поиск одной строки по первичному ключу при тысячах QPS. Затраты на построение плана, отправку фрагментов и обмен по BRPC намного превышают объём самой работы; используйте высококонкурентные точечные запросы (High-Concurrency Point Query).
- Использование MPP как движка OLTP для построчной обработки. Отдельного слоя транзакций на уровне строк нет; обновления проходят через таблицы Unique Key и механизмы массовой загрузки.
- Отождествление MPP с Pipeline или векторизованным выполнением. Эти три уровня работают совместно и не заменяют друг друга. Механизм конвейерного выполнения (Pipeline Execution Engine) выполняет операторы внутри одного BE; векторизованное выполнение (Vectorized Execution) выполняет внутренний цикл обработки над пакетами колоночных данных; MPP координирует их работу между BE.
- Маленькие таблицы в маленьком кластере. Если вся таблица помещается в памяти одного фрагмента, а CPU одного BE выполняет работу менее чем за секунду, планировщик выберет Broadcast Join на одном BE. Это корректный выбор.
Дополнительные материалы
- Понятия продукта: Fragment, Instance, Exchange: основные определения для пользователей, на которых строится остальная документация.
- Архитектура системы: роли FE/BE, BDBJE для достижения консенсуса FE и место Coordinator в топологии.
- Оптимизация соединений и стратегии перераспределения данных: сравнение стоимости Broadcast, Shuffle, Bucket Shuffle и Colocate Join с примерами.
- Механизм конвейерного выполнения (Pipeline Execution Engine): внутренний планировщик BE, которому MPP передаёт фрагменты. Прочитайте этот материал, чтобы разобраться в выполнении внутри отдельного BE.
- Настройка параллелизма: когда и как переопределять
parallel_pipeline_task_numдля конкретной рабочей нагрузки. - Эволюция движка выполнения Apache Doris: история архитектуры от volcano к Pipeline и PipelineX, включая сопутствующие изменения планировщика MPP.