Оптимизация чтения Parquet
Кратко Apache Doris включает нативный векторизованный модуль чтения Parquet на C++ для внешних каталогов и TVF, который обходится без промежуточных преобразований через Java или Arrow. Модуль отсекает целые группы строк и отдельные страницы по статистике самого файла, проверяет предикаты по ID элементов словаря и читает столбцы фильтрации перед столбцами с данными результата. Обращения к удалённому хранилищу объединяются, сокращая число запросов, поэтому большинство запросов завершается без декодирования ненужных столбцов.
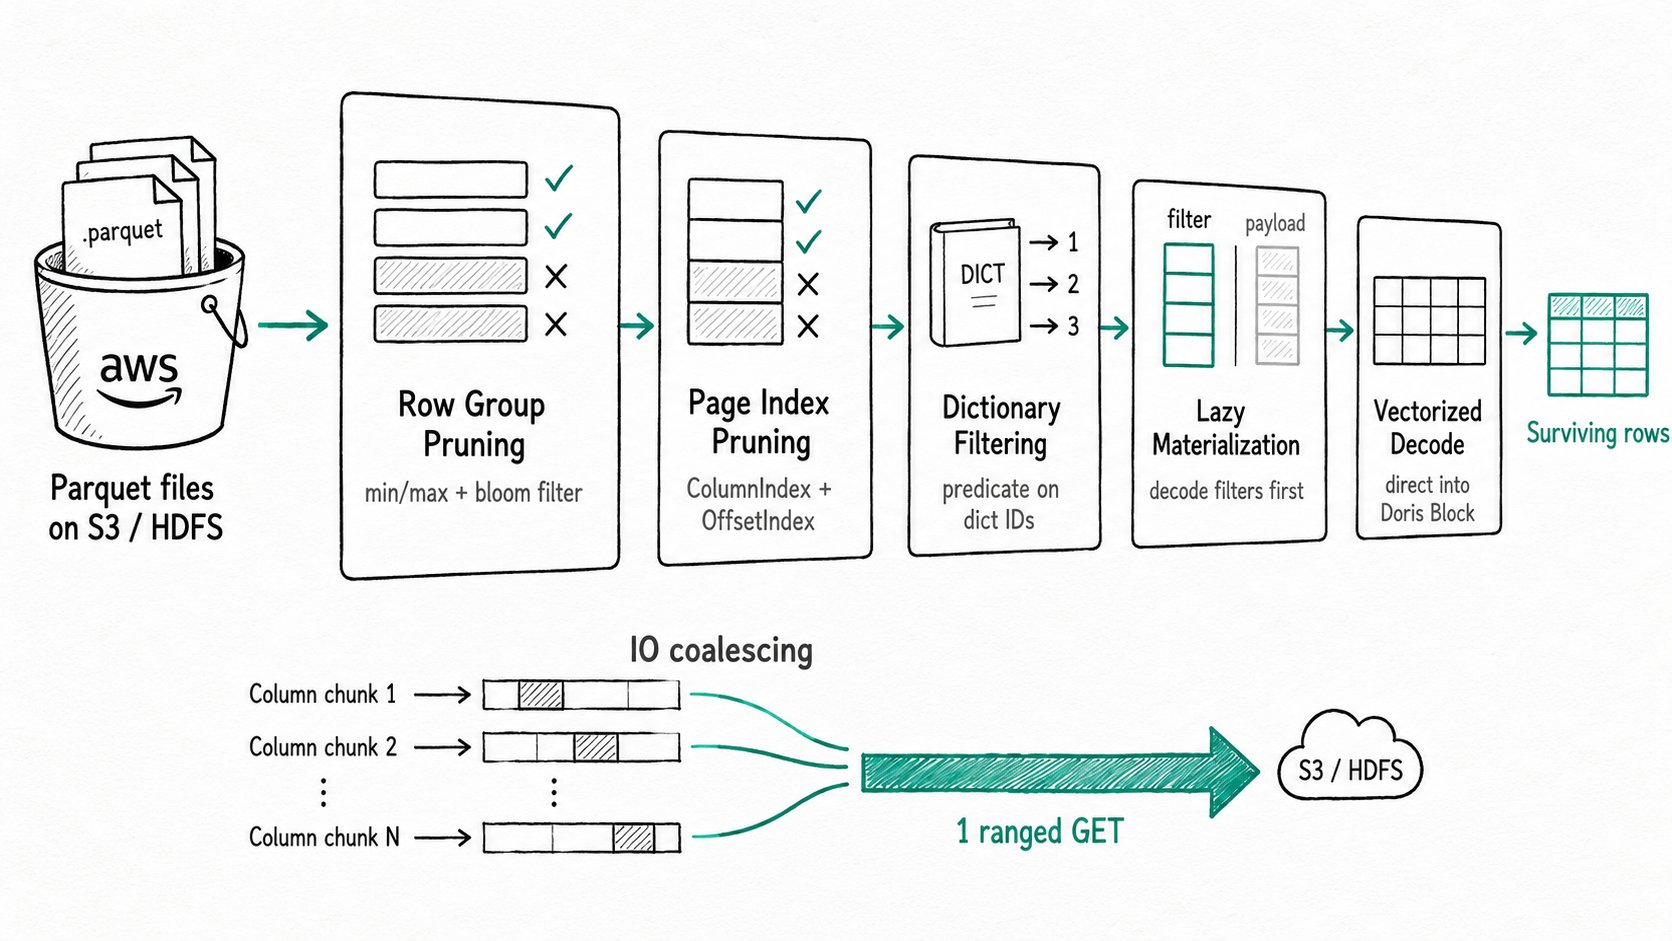
Зачем использовать модуль чтения Parquet в Apache Doris?
Нативный модуль чтения Parquet в Apache Doris сокращает три основные статьи затрат при сканировании данных в lakehouse: получение байтов из объектного хранилища, распаковку и декодирование страниц, а также преобразование значений в представление, используемое движком во время выполнения. Таблица Hive или Iceberg в S3 в конечном счёте представляет собой набор файлов Parquet, и наивная реализация чтения несёт все три вида затрат при каждом запросе.
Эти затраты проявляются в ситуациях, знакомых каждому, кто оптимизировал запросы к lakehouse:
- Фильтр
WHERE order_date >= '2026-04-01'сканирует каждую группу строк в каждом файле Parquet, поскольку модуль чтения не проверяет значения min/max для отдельных групп строк в файле. - Точечный поиск вида
WHERE user_id = 12345считывает весь столбецuser_id, хотя только одна группа строк потенциально может содержать этот ID. - Запрос
SELECT *к широкой таблице событий в S3 выполняет сотни небольших HTTP GET-запросов на файл, по одному на каждый блок столбца. - Предикат вида
country = 'JP'требует распаковки и декодирования UTF-8 для миллионов строк, хотя столбец использует словарное кодирование и для получения ответа достаточно одного сравнения целых чисел на строку.
Модуль чтения Parquet в Apache Doris спроектирован так, чтобы избежать каждой из этих проблем ещё до чтения страниц из хранилища.
Что такое модуль чтения Parquet в Apache Doris?
Модуль чтения Parquet в Apache Doris представляет собой нативный компонент на C++, который читает метаданные Parquet, отсекает данные на всех доступных уровнях детализации (группа строк, страница, словарь, столбец) и декодирует значения непосредственно в тот же формат Block, который использует векторизованный исполнитель. В этом процессе нет промежуточных преобразований через библиотеку Java или Arrow.
Основные термины
Row group: единица, на которую разбивается файл Parquet для параллельного чтения. Каждая группа содержит статистику min/max и количества значений NULL по каждому столбцу.PageIndex: необязательная структура Parquet (ColumnIndex + OffsetIndex), предоставляющая ту же статистику на уровне страниц, а также смещение каждой страницы в байтах, чтобы модуль чтения мог перейти прямо к ней.Lazy materialization: чтение в два прохода, при котором сначала декодируются столбцы фильтрации, а затем столбцы с данными результата считываются только для строк, прошедших фильтрацию.Dictionary filtering: однократная проверка предиката по странице словаря блока столбца с последующим сравнением строк с полученным набором ID элементов словаря.
Как работает модуль чтения Parquet в Apache Doris?
Модуль чтения Parquet в Apache Doris выполняет конвейер из пяти этапов, каждый из которых сокращает объём данных, обрабатываемых на следующем этапе.
- Отсечение групп строк. При открытии файла модуль чтения проверяет статистику столбцов каждой группы строк и отбрасывает всю группу, если предикат не может соответствовать её диапазону min/max. На этом же этапе проверяется фильтр Блума Parquet, если он есть в файле. Обе проверки выполняются только по метаданным, до считывания страниц столбцов. Управляется параметрами
enable_parquet_filter_by_min_maxиenable_parquet_filter_by_bloom_filter. - Отсечение страниц с помощью PageIndex. Для каждой оставшейся группы строк модуль чтения разбирает ColumnIndex и OffsetIndex, чтобы отбросить отдельные страницы, значения min/max которых не могут соответствовать предикату. OffsetIndex задаёт диапазон байтов каждой оставшейся страницы, поэтому модуль чтения переходит прямо к следующей странице, не сканируя отброшенные байты. Включается и отключается параметром конфигурации BE
enable_parquet_page_index. - Фильтрация по словарю. Если блок столбца использует словарное кодирование, а предикат представляет собой выражение с обращением к одному столбцу, модуль чтения декодирует только страницу словаря, проверяет по ней предикат и переписывает его для работы с ID элементов словаря. Обработка страниц данных после этого сводится к сравнению целых чисел в упакованном битовом представлении.
- Ленивая материализация. Строки, прошедшие фильтрацию, ещё нужно собрать. Модуль чтения разделяет столбцы на столбцы фильтрации (используемые в предикатах) и столбцы с данными результата, декодирует столбцы фильтрации для построения битовой карты отбора строк и только затем считывает столбцы с данными результата для строк, прошедших фильтрацию. Управляется переменной сеанса
enable_parquet_lazy_mat, включённой по умолчанию. - Объединение операций ввода-вывода и прямое декодирование. Соседние блоки столбцов внутри группы строк объединяются в одну операцию чтения диапазона байтов, поэтому движок выполняет один HTTP GET-запрос вместо нескольких. Декодированные значения попадают непосредственно в векторизованные столбцы Doris, без промежуточных преобразований через Arrow.
В результате для строк, дошедших до исполнителя, уже подтверждено соответствие условиям, а декодируются только столбцы, необходимые запросу.
Быстрый старт
SELECT region, count(*) AS orders, sum(amount) AS revenue
FROM s3(
  "uri"    = "s3://demo-bucket/orders/year=2026/*.parquet",
  "format" = "parquet",
  "s3.endpoint"   = "https://s3.us-east-1.amazonaws.com",
  "s3.access_key" = "AK...",
  "s3.secret_key" = "SK..."
)
WHERE order_date >= '2026-04-01' AND status = 'PAID'
GROUP BY region;
Ожидаемый результат (фрагмент профиля)
VFileScanNode
  FilteredRowGroups:           18 / 24
  FilteredPages:               210 / 980
  LazyReadFilteredRows:        92.1%
  RemoteIOMergedRanges:        14 (from 96 chunks)
Модуль чтения отбросил 18 из 24 групп строк по предикату даты, а затем отбросил 210 страниц в оставшихся группах с помощью PageIndex по столбцу status. Ленивая материализация позволила пропустить декодирование region и amount для 92.1% строк, не соответствующих условиям. Девяносто шесть блоков столбцов были объединены в 14 GET-запросов диапазонов байтов к S3.
Когда следует использовать модуль чтения Parquet в Apache Doris?
Модуль чтения Parquet в Apache Doris используется автоматически при любом запросе, читающем Parquet, поэтому вопрос в том, как обеспечить условия для его эффективной работы.
Подходит
- Каталоги Hive, Iceberg, Hudi и Paimon, файлы данных которых имеют формат Parquet.
- Прямой анализ файлов с помощью TVF s3() и
hdfs(). - Селективные запросы к широким таблицам: фильтры с большим числом предикатов позволяют ленивой материализации пропустить больше данных.
- Предикаты равенства и диапазона по столбцам, для которых записывающая система сохранила статистику.
- Строковые столбцы со словарным кодированием и точечными предикатами или предикатами
IN.
Не подходит
- Таблицы, хранящиеся в тысячах крошечных файлов Parquet. Для каждого файла нужно разобрать концевой блок метаданных, а для каждого блока столбца требуется как минимум одно чтение диапазона байтов; основную долю затрат составляют накладные расходы на обработку отдельных файлов. Укрупняйте файлы до размеров от 128 MB до 1 GB.
- Файлы, записанные без статистики столбцов или PageIndex. У модуля чтения нет данных для отсечения, и он переходит к полному сканированию. Включите сбор статистики в записывающей системе (Spark 3.2+ и parquet-mr 1.11+ записывают PageIndex).
- Селективные предикаты по глубоко вложенным полям структур. Некоторые оптимизации (индекс страниц, фильтрация по словарю) отключены для сложных типов; модуль чтения полностью обходит строки, прошедшие фильтрацию. По возможности сократите глубину вложенности при обращении к данным или используйте столбцы верхнего уровня.
- Столбцы DATETIME, записанные в формате INT96 старыми реализациями записи Hive. Статистика INT96 часто оказывается повреждённой, поэтому модуль чтения не выполняет для неё отсечение по min/max. Если вы управляете записывающей системой, записывайте временные метки в формате INT64. См. примечания об INT96 в документации по каталогу Hive.
Дополнительные материалы
- Справочник по формату файлов Parquet: доступные пользователю настройки (
enable_parquet_lazy_mat,enable_parquet_page_index, параметры конфигурации BE для размера буфера) и поддержка в разных версиях. - Анализ файлов в S3/HDFS: как напрямую запрашивать файлы Parquet с помощью TVF
s3()иhdfs(). - Отсечение данных: общее описание того, как Doris пропускает чтение данных; модуль чтения Parquet представляет собой один из уровней этого механизма.
- Векторизованное выполнение: движок, для которого модуль чтения декодирует данные, и причины, по которым важно избегать промежуточных преобразований через Arrow.
- Кеш данных: когда следует кешировать декодированные страницы Parquet локально, чтобы при повторных сканированиях полностью избежать чтения из удалённого хранилища.
- Кеш метаданных: кеш на стороне FE для схемы, разделов и списков файлов, от которого зависит отсечение данных в модуле чтения Parquet.
- Multi-Catalog: как таблицы Parquet в S3, HDFS, Hive, Iceberg и Paimon подключаются к Doris.
- Интеграции каталогов: справочник по коннекторам для отдельных источников каталогов, содержащих файлы Parquet.
- Построение lakehouse нового поколения (блог Apache Doris): исходная общедоступная публикация о нативном модуле чтения Parquet.
- Iceberg: формат таблиц lakehouse, сканирование файлов Parquet в котором эта оптимизация ускоряет наиболее непосредственно.