Партиционирование и бакетирование
Кратко Каждая таблица Apache Doris делится дважды: предложение
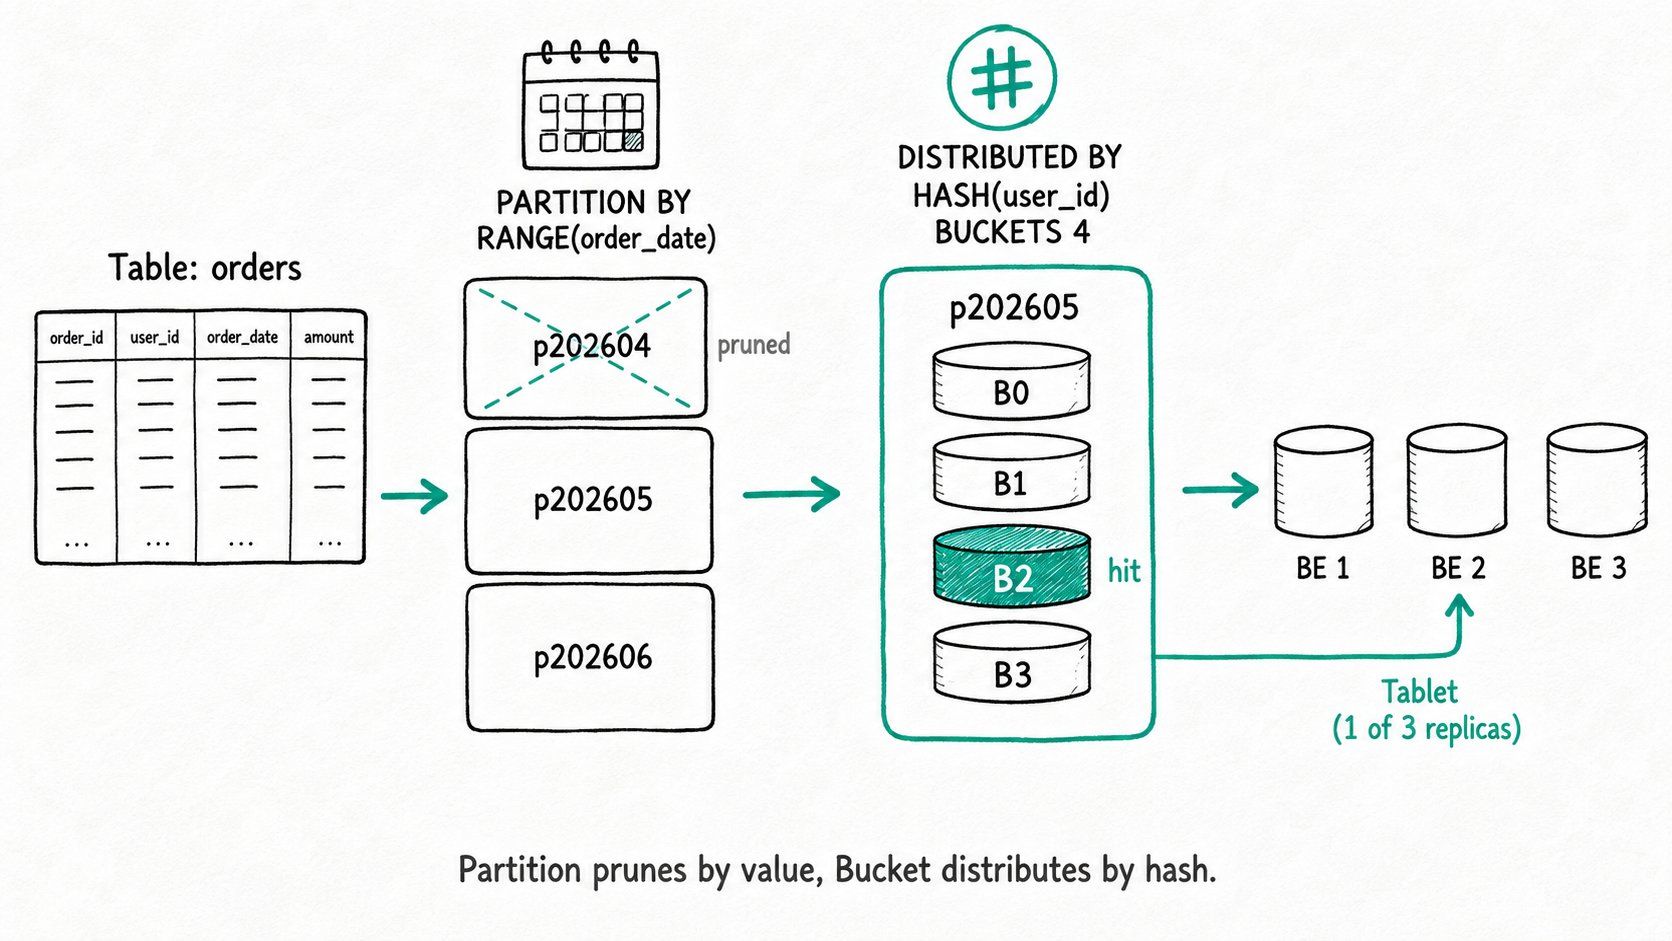
PARTITION BYразбивает строки по значению столбца (обычно даты), а предложениеDISTRIBUTED BYделит каждую партицию на N tablet. Партиции позволяют планировщику исключать из чтения крупные блоки данных, а администратору архивировать их; бакеты обеспечивают кластеру параллельное сканирование и запись. В качестве ключа партиционирования выберите столбец даты, по которому запросы фильтруют данные, а в качестве ключа бакетирования выберите столбец с высокой кардинальностью, по которому выполняется фильтрация на равенство. Остальное доверьтеBUCKETS AUTO.
Зачем использовать партиционирование и бакетирование в Apache Doris?
Партиционирование и бакетирование в Apache Doris решают три проблемы, возникающие, когда таблица перерастает возможности одной машины: запросы, сканирующие все данные, таблицы с единственным tablet, нагружающие один BE, и удаления, которые длятся часами.
- Запрос
WHERE date BETWEEN '2026-04-01' AND '2026-04-07'к таблице событий за 365 дней читает все строки за каждый день, пока планировщик не узнает, что остальные 358 дней можно пропустить. - Таблица объёмом 4 TB, загруженная в один tablet, нагружает один BE до 100% CPU, а остальные девять простаивают. Кластер способен выполнять работу параллельно, но структура таблицы не позволяет этим воспользоваться.
- Удаление данных за прошлый квартал превращается в многочасовое задание
DELETEвместо изменения метаданных.
Партиционирование решает первую и третью проблемы. Бакетирование решает вторую. Вместе они определяют, где хранится каждая строка и какие узлы BE обращаются к ней при выполнении запроса.
Что такое партиционирование и бакетирование в Apache Doris?
Партиционирование и бакетирование в Apache Doris задают двухуровневую физическую организацию каждой таблицы. Предложение PARTITION BY делит таблицу на непересекающиеся подмножества по значению столбца (Range или List), а DISTRIBUTED BY дополнительно делит каждую партицию на фиксированное число tablet, служащих единицами репликации и параллельного выполнения. Строка сначала попадает в свою партицию по значению, а затем в свой tablet по хешу (или путём случайного назначения).
Основные термины
Partition: подмножество строк, заданное диапазоном Range или списком List по одному или нескольким столбцам KEY. Единица отсечения данных, архивирования и TTL.Bucket: часть партиции, в которую строки назначаются по хешу или случайным образом. Каждому бакету соответствует один tablet для каждой реплики.Tablet: физический шард данных. Единица репликации, планирования задач и параллельного выполнения внутри BE.PARTITION BY RANGE / LIST: явное партиционирование, объявленное в DDL. Range подходит для временных и числовых диапазонов; List подходит для перечислимых измерений, например региона или арендатора.AUTO PARTITION: партиции создаются по мере необходимости при записи: поdate_trunc(col, 'month')для диапазонов или по значению перечислимого измерения для списков. Заменяет статический список партиций.DISTRIBUTED BY HASH(col) BUCKETS N: шарды с распределением по хешу. Бакет выбирается с помощьюcrc32(col) % N; предикаты равенства поcolпозволяют отсекать бакеты.DISTRIBUTED BY RANDOM BUCKETS N: строки распределяются по бакетам без ключа. Позволяет избежать перекоса данных, но не поддерживает отсечение бакетов. Доступно только для таблиц Duplicate-Key.BUCKETS AUTO: FE выбирает число бакетов на основеestimate_partition_size, количества узлов BE и дисков. Задаётся для каждой партиции.
Как работают партиционирование и бакетирование в Apache Doris?
Партиционирование и бакетирование в Apache Doris вместе определяют путь строки от INSERT до диска через два уровня: выбор партиции и выбор tablet.
- Определение партиции для строки. Планировщик вычисляет выражение партиционирования. Для партиций Range выполняется двоичный поиск в отсортированном списке интервалов; для партиций List значение ищется в хеш-таблице. Если подходящей партиции нет, Auto Partition создаёт её на лету.
- Определение бакета для строки. При распределении по хешу вычисляется
crc32(bucket_cols) % bucket_num; при случайном распределении tablet выбирается по кругу (либо весь пакет направляется в один tablet, еслиload_to_single_tablet = true). - Запись в реплики выбранного tablet. У каждого tablet есть N реплик (по умолчанию 3) на разных узлах BE. Coordinator передаёт строку потоком во все реплики.
- Отсечение данных при выполнении запроса (FE).
PruneOlapScanPartitionсопоставляет предикатыWHEREс деревом партиций;PruneOlapScanTabletизвлекает предикаты равенства по ключу бакетирования и определяет с помощьюHashDistributionPruner, в какие бакеты они попадают по хешу. EXPLAIN показывает оставшиеся партиции и tablet какpartitions=1/365иtablets=1/32. - Параллельное сканирование оставшихся tablet (BE). Каждый оставшийся tablet служит единицей параллельного сканирования. Конвейерный движок распределяет их по ядрам BE, поэтому запрос, обращающийся к 16 tablet на 4 узлах BE, выполняется в 16 параллельных потоках без настройки сеанса.
Иерархия хранения на диске выглядит так: Table → Partition → Tablet → Rowset → Segment. Compaction и репликация работают на уровне tablet, поэтому число партиций и бакетов определяет как параллелизм запросов, так и затраты на эксплуатацию. Подробнее о многоуровневой цепочке отсечения данных, которая выполняется после выбора планировщиком оставшихся партиций и tablet, см. в разделе Отсечение данных.
Быстрый старт
CREATE TABLE orders (
  order_id   BIGINT,
  user_id    BIGINT,
  order_date DATE NOT NULL,
  amount     DECIMAL(10,2)
)
DUPLICATE KEY(order_id, user_id)
AUTO PARTITION BY RANGE (date_trunc(order_date, 'month')) ()
DISTRIBUTED BY HASH(user_id) BUCKETS 16;

INSERT INTO orders VALUES
  (1, 100, '2026-04-15', 99.00),
  (2, 200, '2026-05-02', 50.00);

EXPLAIN SELECT SUM(amount) FROM orders
WHERE order_date >= '2026-05-01' AND user_id = 200;
Ожидаемый результат (фрагмент)
0:VOlapScanNode
  TABLE: orders
  PREDICATES: order_date >= '2026-05-01', user_id = 200
  partitions=1/2 (p20260501000000)
  tablets=1/16
Для данных за два месяца автоматически созданы две партиции. По предикату даты планировщик оставил одну из этих партиций, а по условию равенства для user_id оставил один tablet из шестнадцати, поэтому запрос читает 1/32 таблицы. Записи распределяются по всем шестнадцати tablet, поэтому одна загрузка использует шестнадцать рабочих потоков BE параллельно.
Когда следует использовать партиционирование и бакетирование в Apache Doris?
Партиционирование в Apache Doris подходит для таблиц временных рядов и таблиц с перечислимыми измерениями, которым нужно отсечение данных или архивирование; бакетирование подходит для любой таблицы, достаточно большой, чтобы один tablet не справлялся со сканированием или записью.
Подходящие сценарии
- Таблицы фактов с временными рядами (события, заказы, журналы). Range или Auto Range по временной метке позволяет планировщику пропускать почти все партиции при типичном запросе дашборда, а удаление данных за месяц сводится к изменению метаданных.
- Точечные запросы с высокой конкурентностью по
user_id,device_idили любому другому столбцу с высокой кардинальностью, по которому выполняется фильтрация на равенство. Выберите этот столбец в качестве ключа хеш-бакетирования, и отдельный запрос будет обращаться к одному tablet. - Таблицы для нескольких арендаторов или регионов со стабильным перечислимым измерением. Используйте партиционирование List по арендатору, а при отключении арендатора удаляйте его партицию.
- Таблицы, загружаемые инкрементально, для которых нельзя заранее предсказать диапазон значений.
AUTO PARTITION BY RANGE(date_trunc(...))создаёт партиции при первой записи, полностью избавляя от DDL для управления партициями. - Соединения двух больших таблиц по одному ключу, требующие обмена данными между многими узлами. Используйте одинаковый ключ бакетирования в обеих таблицах и включите Colocate Join, чтобы избежать перераспределения данных.
Неподходящие сценарии
- Партиционирование по столбцу с низкой кардинальностью, по которому запросы не фильтруют данные (флаг статуса, столбец страны с 5 значениями). Планировщику нечего отсекать, а вы тратите ресурсы на метаданные партиций, которые никогда не пропускаются.
- Бакетирование по столбцу, по которому вы не фильтруете данные. Вы несёте затраты на вычисление хеша при записи, но не получаете отсечения данных. Выберите столбец с наиболее селективным предикатом равенства или используйте
RANDOM, если такого столбца нет. - Бакетирование по столбцу с низкой кардинальностью (например,
gender). Два значения не могут распределиться по 16 бакетам; в результате одни tablet перегружены, а другие простаивают. Выберите столбец с высокой кардинальностью или объедините несколько столбцов в ключ бакетирования. - Сотни бакетов на партицию. В документации указан предел 128 бакетов на партицию; при его превышении пропускная способность записи падает, а потребление памяти FE растёт (практический ориентир: 100 GB памяти FE на 10 миллионов tablet). Сначала разбейте таблицу на партиции, затем на бакеты.
- Крошечные tablet объёмом в мегабайты. Каждый tablet требует метаданных в FE и отдельного цикла compaction. Ориентируйтесь на объём сжатых данных от 1 GB до 10 GB на tablet (для таблиц Unique-Key объём должен оставаться меньше 10 GB).
- Случайное бакетирование таблиц Unique или Aggregate. Случайное распределение нарушает корректность слияния; оно допускается только для таблиц Duplicate.
Дополнительные материалы
- Основные понятия: разбор партиций и бакетов со схемами
- Ручное партиционирование: Range, List и четыре формы Range
- Автоматическое партиционирование: создание партиций по мере необходимости при записи
- Бакетирование данных: выбор метода, ключа и числа бакетов
- Отсечение данных: многоуровневая цепочка отсечения после выбора партиций и tablet
- Справочник по
ALTER TABLE PARTITION - Архитектура MPP: Bucket Shuffle и Colocate Join используют выбранную здесь схему бакетирования, чтобы избежать перераспределения данных по сети.
- Unique Key: модель таблицы, в которой столбцы партиционирования должны входить в состав уникального ключа, иначе дедупликация работает некорректно.