Слияние обратных рангов (Reciprocal Rank Fusion)
Кратко В Apache Doris нет встроенной функции
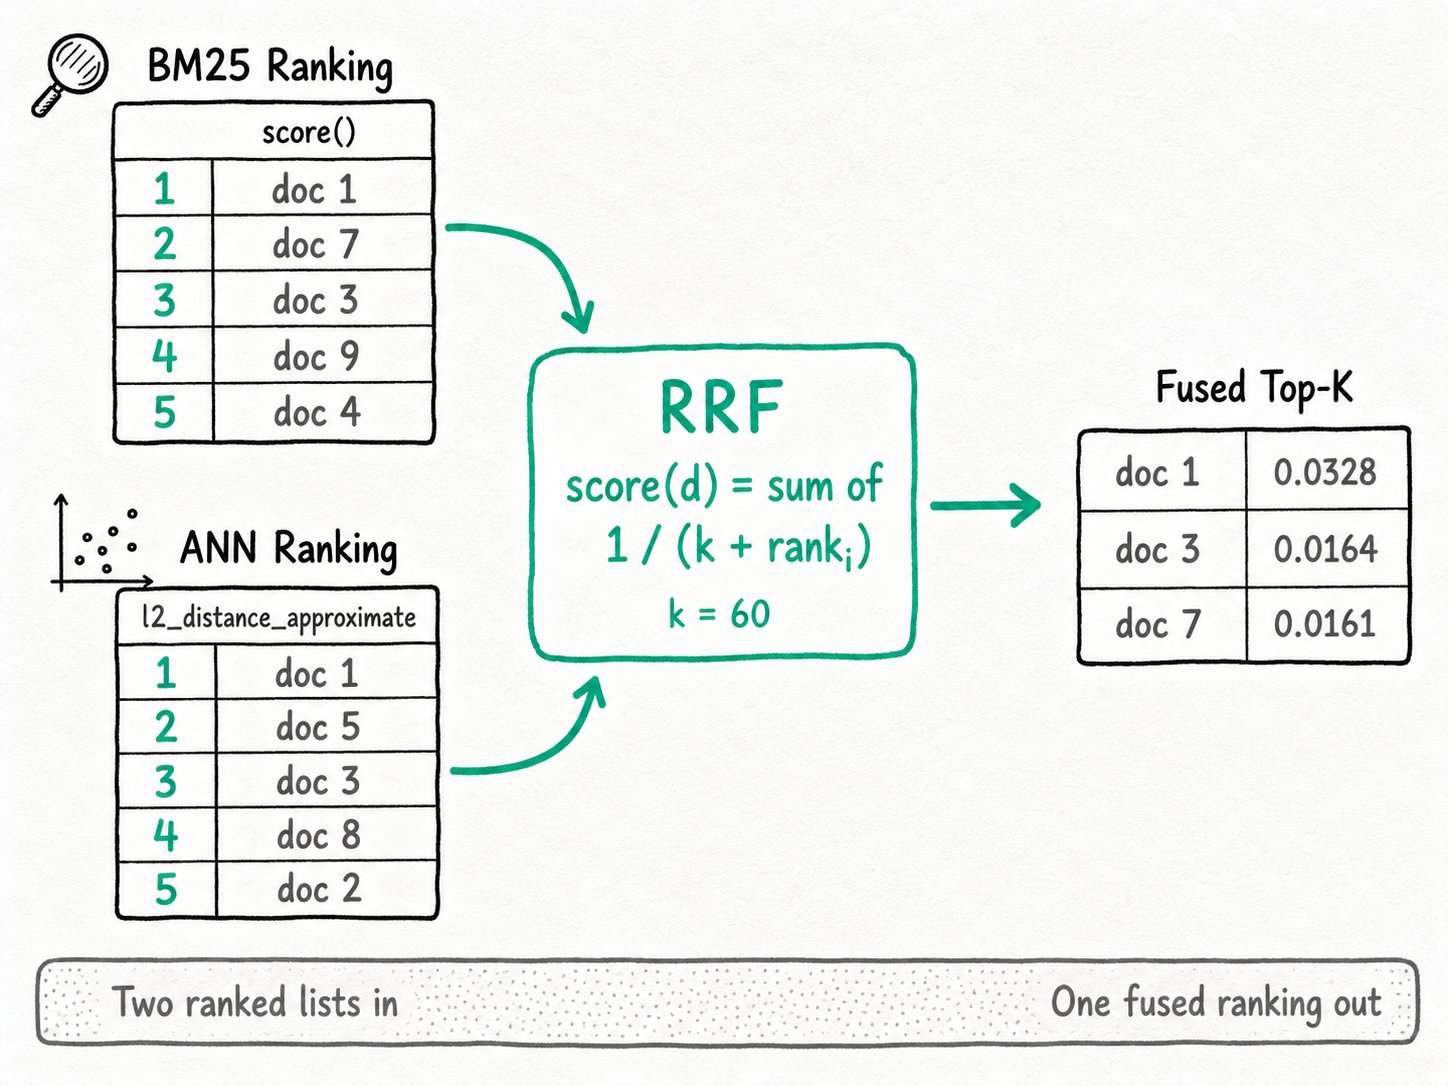
rrf(), но Reciprocal Rank Fusion можно реализовать на обычном SQL. В этом шаблонеROW_NUMBER()применяется к результатам ранжирования BM25 и векторного ранжирования, после чего значения1.0 / (60 + rank)суммируются по обоим спискам со стандартной константой сглаживанияk = 60. Результат представляет собой единый объединённый список top-K, порядок которого не зависит от согласования оценок BM25 с косинусным расстоянием.
Зачем использовать Reciprocal Rank Fusion в Apache Doris?
Reciprocal Rank Fusion даёт гибридному поиску Apache Doris обоснованный способ по умолчанию объединять результаты BM25 и векторного поиска без калибровки двух несовместимых шкал оценок. Гибридный поиск возвращает два ранжированных списка для одного и того же запроса: один получен при полнотекстовом сопоставлении (оценки BM25 через score()), другой при определении векторного сходства (l2_distance_approximate или inner_product_approximate). Эти оценки используют несовместимые шкалы. BM25 представляет собой положительное число без верхней границы, значение которого зависит от статистики корпуса; косинусное расстояние находится в диапазоне от 0 до 2; расстояние L2 вообще не имеет верхней границы. Сложение или усреднение этих оценок даёт число без обоснованной интерпретации, а нормализация min-max для каждого запроса ненадёжна: один выброс в любом из списков нарушает слияние.
Reciprocal Rank Fusion обходит эту проблему, отбрасывая оценки и оставляя только ранги. У алгоритма всего один настраиваемый параметр, и он хорошо показывает себя в тестах качества поиска с момента публикации Cormack, Clarke и Buettcher в 2009 году.
- BM25 и векторные расстояния используют разные шкалы; арифметические операции с ними небезопасны.
- Нормализация min-max перестаёт работать, когда запрос даёт распределение оценок с длинным хвостом.
- Сервис слияния на стороне приложения становится ещё одним компонентом, который нужно развёртывать и поддерживать в согласованном состоянии с базой данных.
Что такое Reciprocal Rank Fusion в Apache Doris?
Reciprocal Rank Fusion в Apache Doris представляет собой шаблон SQL, а не встроенную функцию: это алгоритм слияния на основе рангов, выраженный с помощью ROW_NUMBER, FULL OUTER JOIN и стандартной формулы 1/(k+rank). Для документа d, который встречается в ранжированных списках R_1, R_2, ..., R_n, объединённая оценка равна сумме обратных рангов по всем спискам, в которых он присутствует:
score(d) = Σ 1 / (k + rank_i(d))
rank_i(d) обозначает позицию документа d в списке i, отсчитываемую с 1. k задаёт константу сглаживания; значение, рекомендованное Cormack и соавторами и используемое в большинстве промышленных систем, равно 60. Документы, отсутствующие в списке, получают от него нулевой вклад. Затем результаты сортируются по объединённой оценке по убыванию, формируя итоговое ранжирование.
В Apache Doris реализация представляет собой шаблон SQL, а не функцию. Вы пишете два ранжированных подзапроса, один для BM25 и один для ANN, присваиваете каждой строке ROW_NUMBER(), затем выполняете FULL OUTER JOIN и суммируете обратные величины рангов.
Ключевые термины
score(): функция вычисления оценки BM25 в Doris для инвертированных индексов. Она работает только в запросе к одной таблице с предикатомMATCH_*, сортировкойORDER BYпо оценке и ограничениемLIMIT; в списке выбираемых выражений её нужно использовать без изменений (score() AS s). Ранжирование или округление оценки выполняется во внешнем запросе.l2_distance_approximate/inner_product_approximate: функции расстояния для ANN, использующие векторный индекс Doris (HNSW или IVF).ROW_NUMBER() OVER (ORDER BY ...): присваивает каждой строке набора результатов ранг с отсчётом от 1.k: константа сглаживания RRF. Меньшие значения (20–40) усиливают влияние строк с высокими позициями; большие значения (80+) сглаживают его.
Как работает Reciprocal Rank Fusion в Apache Doris?
Apache Doris реализует Reciprocal Rank Fusion следующим образом: выполняет два ранжированных поисковых запроса в виде подзапросов, присваивает строкам каждого ROW_NUMBER(), объединяет два списка по идентификатору документа с помощью FULL OUTER JOIN и суммирует 1/(k+rank), чтобы получить итоговый порядок. Следующая последовательность из пяти шагов охватывает поиск, ранжирование, соединение, слияние и ограничение результата.
- Выполните два ранжированных поисковых запроса. Подзапрос BM25 фильтрует данные с помощью
MATCH_ANYи сортирует их поscore()по убыванию. Подзапрос ANN сортирует данные по векторному расстоянию по возрастанию. Каждый ограничен с помощьюLIMIT N, гдеNзадаёт размер пула кандидатов (обычно 50–200). - Присвойте ранги в каждом списке.
ROW_NUMBER() OVER (ORDER BY ...)нумерует строки 1, 2, 3 внутри каждого подзапроса. Эти числа целочисленные, поэтому их можно безопасно объединять между результатами разных запусков. Для списка BM25 оконную функцию помещают на уровень выше запроса, вычисляющегоscore(): выражениеROW_NUMBER() OVER (ORDER BY score() DESC)в том жеSELECTотклоняется с ошибкойscore() function requires WHERE clause with MATCH function, ORDER BY and LIMIT for optimization. - Выполните внешнее соединение двух списков по идентификатору документа.
FULL OUTER JOINсохраняет документы, присутствующие хотя бы в одном списке. Если строка отсутствует с одной стороны, её ранг с этой стороны получает значениеNULL. - Сложите обратные величины рангов. Выражение
COALESCE(1.0/(60+bm25_rank), 0) + COALESCE(1.0/(60+ann_rank), 0)вычисляет объединённую оценку каждого документа. Отсутствующие ранги дают нулевой вклад, что соответствует исходному определению RRF. - Отсортируйте и ограничьте результат.
ORDER BY rrf_score DESC LIMIT Kвозвращает итоговый список top-K.
Размер пула N имеет значение. Если получать только первые 10 результатов от каждого поискового механизма, документ на 11-м месте в BM25 и на 1-м месте в ANN будет выглядеть как результат, найденный только векторным поиском. Получение 100 кандидатов с каждой стороны служит разумным вариантом по умолчанию; увеличивайте это значение для нагрузок, чувствительных к полноте поиска.
Быстрый старт
Те же четыре строки, что и в примерах Векторный индекс и Гибридный поиск, с текстом комментария в body:
CREATE TABLE docs (
  id INT NOT NULL,
  embedding ARRAY<FLOAT> NOT NULL,
  body STRING NOT NULL,
  INDEX idx_body(body) USING INVERTED PROPERTIES("parser"="english"),
  INDEX idx_vec(embedding) USING ANN
    PROPERTIES("index_type"="hnsw","metric_type"="l2_distance","dim"="8")
) DUPLICATE KEY(id) DISTRIBUTED BY HASH(id) BUCKETS 1;

INSERT INTO docs VALUES
  (1, [0.1,0.2,0.3,0.4,0.5,0.6,0.7,0.8], 'this is about music'),
  (2, [0.2,0.1,0.5,0.3,0.9,0.4,0.7,0.1], 'sports news today'),
  (3, [0.9,0.8,0.7,0.6,0.5,0.4,0.3,0.2], 'latest music trend'),
  (4, [0.05,0.06,0.07,0.08,0.09,0.1,0.2,0.3], 'politics update');

SELECT COALESCE(b.id, a.id) AS id,
       COALESCE(1.0 / (60 + b.r), 0) + COALESCE(1.0 / (60 + a.r), 0) AS rrf
FROM (
  -- BM25 list: score() stays plain here; ROW_NUMBER() ranks it one level up
  SELECT id, ROW_NUMBER() OVER (ORDER BY s DESC) AS r
  FROM (SELECT id, score() AS s FROM docs
        WHERE body MATCH_ANY 'music' ORDER BY s DESC LIMIT 100) bm25_hits
) b
FULL OUTER JOIN (
  -- ANN list
  SELECT id, ROW_NUMBER() OVER (ORDER BY dist ASC) AS r
  FROM (SELECT id, l2_distance_approximate(embedding, [0.1,0.1,0.2,0.2,0.3,0.3,0.4,0.4]) AS dist
        FROM docs ORDER BY dist ASC LIMIT 100) ann_hits
) a ON b.id = a.id
ORDER BY rrf DESC LIMIT 5;
Ожидаемый результат
+------+---------+
| id   | rrf     |
+------+---------+
|    1 | 0.03224 |
|    3 | 0.03201 |
|    4 | 0.01639 |
|    2 | 0.01587 |
+------+---------+
BM25 ставит документ 3 на первое место, а 1 на второе (только эти два документа содержат "music"); векторный список упорядочен так: 4, 1, 2, 3. Документ 1 занимает второе место в обоих списках, поэтому получает оценку 1/62 + 1/62 ≈ 0.0322 и немного опережает документ 3, который стоит первым по BM25, но последним по расстоянию (1/61 + 1/64 ≈ 0.0320). Документы 4 и 2 присутствуют только в векторном списке и располагаются следом.
Когда следует использовать Reciprocal Rank Fusion в Apache Doris?
Используйте Reciprocal Rank Fusion в Apache Doris для конвейеров RAG, поиска по Catalog и документам и любых нагрузок, объединяющих BM25 и векторный поиск, когда калибровка абсолютных оценок непрактична. Откажитесь от него при использовании единственного поискового механизма, очень небольших пулов кандидатов, необходимости в откалиброванных вероятностях и в часто выполняемых запросах, где дополнительное соединение увеличивает задержку.
Подходит
- Конвейеры RAG, которые ищут и по ключевым словам, и по сходству эмбеддингов и которым нужен единый объединённый список top-K для передачи в LLM.
- Поиск по Catalog или документам, где полнота поиска по ключевым словам и семантического поиска дополняют друг друга и требуется обоснованный вариант ранжирования по умолчанию.
- Нагрузки, где калибровка абсолютных оценок между поисковыми механизмами непрактична из-за изменений корпуса или распределения запросов.
- Случаи, когда иначе пришлось бы создавать сервис слияния на уровне приложения; перенос слияния в SQL сокращает путь обработки данных.
Не подходит
- Нагрузки с единственным поисковым механизмом. Если используется только BM25 или только ANN, сортируйте по исходной оценке и не выполняйте соединение. RRF для одного списка представляет собой лишь монотонное преобразование ранга.
- Очень небольшие пулы кандидатов (первые 5 или первые 10 результатов с каждой стороны). RRF повышает оценки документов, присутствующих в обоих списках, а для этого оба списка должны быть достаточно длинными. Получайте не менее 50 кандидатов от каждого поискового механизма.
- Нагрузки, которым нужны откалиброванные вероятности (для пороговой фильтрации, отказа от ответа или последующих моделей затрат). Оценки RRF не являются вероятностями и не имеют абсолютного смысла при сравнении разных запросов. Если нужна калибровка, используйте обученную модель ранжирования.
- Часто выполняемые запросы, в которых дополнительные подзапросы и соединение увеличивают задержку. Шаблон с предварительной фильтрацией (
MATCH_ANY+ORDER BY l2_distance_approximate) возвращает единый ранжированный список за один проход и используется по умолчанию в гибридном поиске.
Настройка k
Уменьшение k (в сторону 20) увеличивает разрыв между рангами 1 и 5, что полезно, когда один поисковый механизм явно надёжнее. Увеличение k (в сторону 100) делает кривую более пологой и повышает вклад документов, расположенных далеко от начала обоих списков. Измените k один раз, измерьте полноту поиска на размеченном наборе и остановитесь. Подстройка для каждого запроса указывает на необходимость обученной модели ранжирования.
Дополнительные материалы
- Гибридный поиск: стандартный для Doris шаблон, объединяющий фильтрацию по инвертированному индексу с ранжированием ANN за один проход; в этой карточке он рассматривается как альтернативный подход.
- Оценка релевантности (BM25): как вычисляется
score()и при каких условиях она применяется; эта оценка служит входными данными для одной из двух составляющих слияния. - Обзор инвертированных индексов: типы индексов, токенизаторы и операторы
MATCH_*, используемые в подзапросе BM25. - Обзор векторных индексов: реализации HNSW и IVF, функции расстояния и ограничения для подзапроса ANN.
- ROW_NUMBER: оконная функция, которая присваивает целочисленные ранги строкам каждого ранжированного подзапроса.
- Cormack, Clarke, Buettcher (2009): Reciprocal Rank Fusion превосходит метод Condorcet и отдельные методы обучения ранжированию: исходная статья и источник рекомендации
k = 60.