Resource Group
Кратко Apache Doris Resource Group объединяет узлы BE в именованные пулы с помощью тегов, размещает реплики таблиц в этих пулах и привязывает каждого пользователя к одному или нескольким пулам. Запрос выполняется только на BE из пулов пользователя и читает только размещённые там реплики. Поскольку пулы состоят из отдельных процессов BE, сбой или OOM в одной группе не может вывести из строя другую. Цена такой изоляции — место для хранения: каждому пулу, которому нужно читать таблицу, требуется собственная реплика.
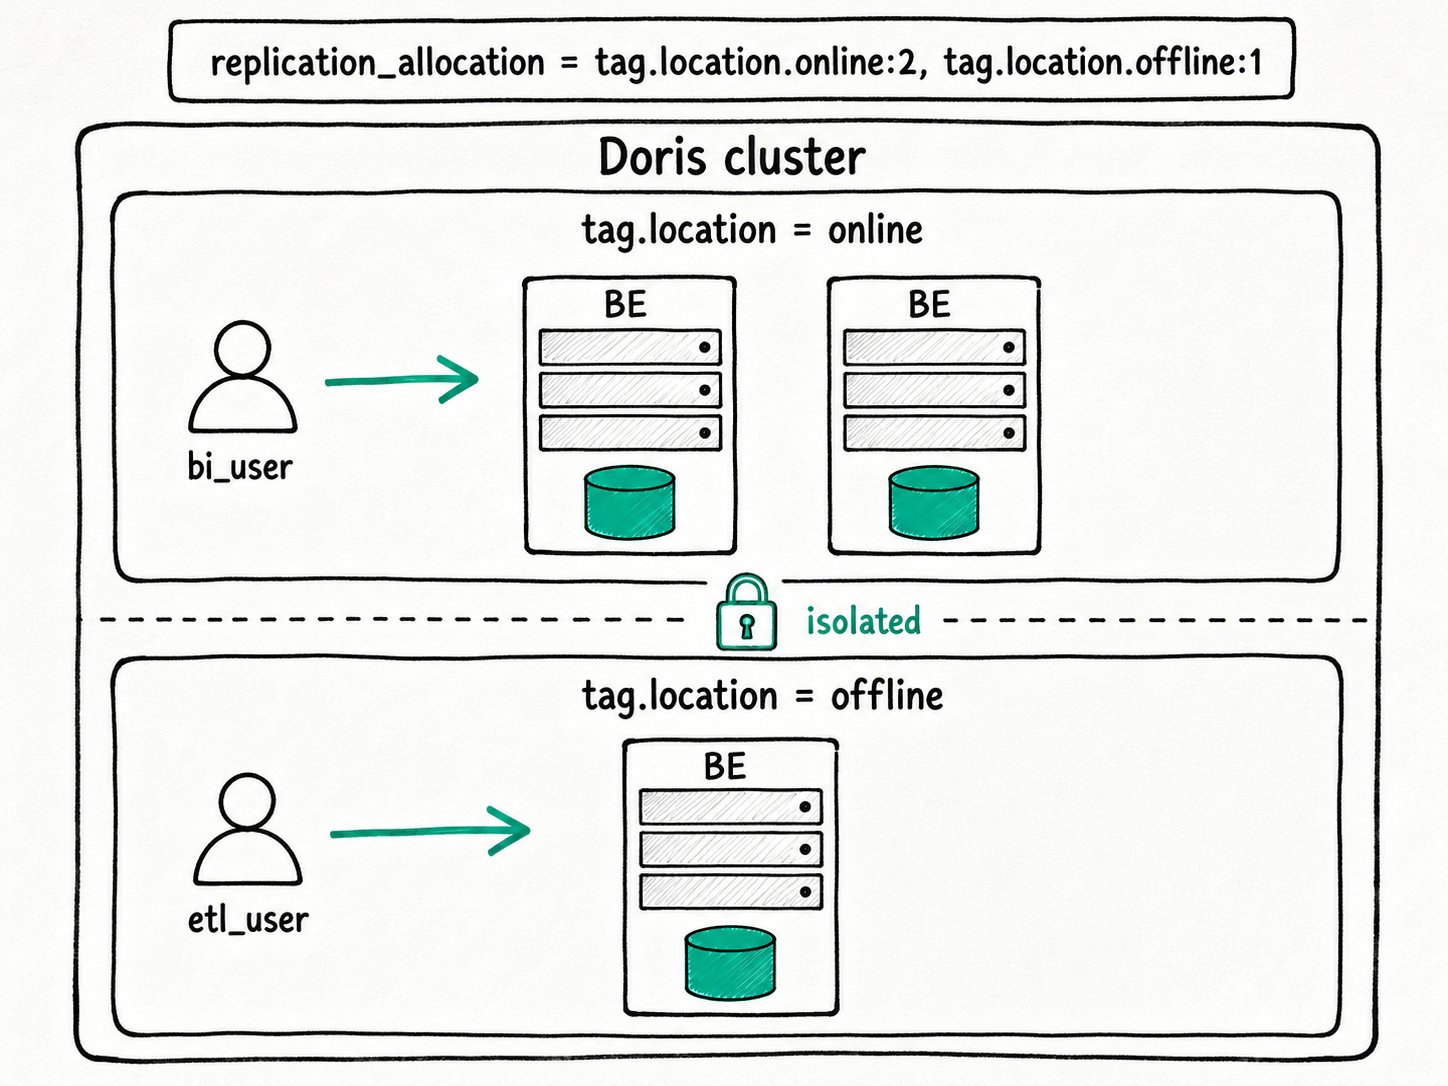
Зачем использовать Resource Group в Apache Doris?
Apache Doris Resource Group нужен потому, что один кластер обычно обслуживает несколько нагрузок, которые могут мешать друг другу. Задание ETL в 2 часа ночи перезаписывает вчерашние партиции на тех же BE, к которым днём каждые пятнадцать секунд обращается дашборд руководителя. Пакетное задание финансового отдела повторно запускает тяжёлый отчёт в 9 утра, пока аналитик выполняет неограниченный SELECT *.
Workload Group решает многие из этих задач внутри процесса: cgroups для CPU, отдельный трекер памяти и отдельная очередь для каждой группы. Этот механизм требует мало ресурсов и гибко настраивается. Однако он не защищает от сбоя BE. Если ядро завершает BE из-за OOM, вместе с ним останавливаются все группы на этом BE. Если во время выполнения запроса в BE возникает segfault, и дашборду, и заданию ETL приходится переподключаться. Для нагрузок, которым нужна изоляция друг от друга на уровне процессов, средств изоляции внутри процесса недостаточно.
Apache Doris Resource Group решает эту задачу без развёртывания второго кластера. Каждому BE назначается метка, каждая таблица задаёт количество реплик для каждого тега, а каждый пользователь привязывается к тегам, которые ему разрешено использовать. У кластера остаются единый кворум FE, единый Catalog схем и единый набор учётных данных, но BE теперь разделены на пулы, которые во время выполнения не используют общие ресурсы.
Что такое Apache Doris Resource Group?
Apache Doris Resource Group — это механизм размещения реплик и маршрутизации запросов, основанный на тегах ресурсов. Каждый BE относится ровно к одному тегу location. Каждая реплика каждой таблицы относится ровно к одному тегу, который определяется при создании с помощью replication_allocation. У каждого пользователя есть набор разрешённых тегов, заданный свойством resource_tags.location. Планировщик запросов находит пересечение этих условий: выбирает BE с тегами из набора пользователя и читает только реплики, размещённые на этих BE.
Основные термины
tag.location: метка на стороне BE. Задаётся командойALTER SYSTEM MODIFY BACKEND ... SET ("tag.location" = "<name>"). У BE может быть только один тег location; по умолчанию этоdefault.replication_allocation: свойство таблицы или базы данных, которое сопоставляет теги с количеством реплик и записывается в видеtag.location.<name>:<n>. Чтобы распределить реплики между пулами, перечислите записи через запятую, напримерtag.location.online:2, tag.location.offline:1.resource_tags.location: свойство пользователя со списком тегов, к которым ему разрешён доступ. Чтобы разрешить несколько тегов, перечислите их через запятую. Пустое значение означает поведение по умолчанию, описанное ниже.- Тег по умолчанию: встроенный тег
default. Изначально он назначен каждому BE, и удалить его нельзя. Начиная с 2.0.3 обычные пользователи без заданногоresource_tags.locationвидят толькоdefault;rootиadminвидят всё.
Как работает Apache Doris Resource Group?
Работа Apache Doris Resource Group состоит из пяти этапов: назначение тегов BE, распределение реплик между тегами, привязка пользователей к тегам, маршрутизация запроса и разделение пути загрузки.
- Назначьте теги BE.
ALTER SYSTEM MODIFY BACKEND "host:9050" SET ("tag.location" = "online"). FE записывает изменение в свой журнал изменений, поэтому назначение сохраняется после перезапусков.SHOW BACKENDSпоказывает тег в столбцеTag. - Распределите реплики между тегами. При создании таблицы с
replication_allocation = "tag.location.online:2, tag.location.offline:1"FE проверяет, достаточно ли BE с каждым тегом, а затем поручает планировщику tablet разместить по одной реплике на каждый слот. Если проверка не пройдена, появляется сообщение "Failed to find enough host with tag(...)", и выполнение DDL прерывается. Это свойство также можно задать на уровне базы данных, чтобы новые таблицы наследовали его. - Привяжите пользователей к тегам.
SET PROPERTY FOR 'bi_user' 'resource_tags.location' = 'online'. Изменение действует глобально, но пользователю нужно переподключиться, чтобы оно вступило в силу для его сессии. - Направьте запрос на нужные BE. Когда пользователь отправляет запрос, FE определяет по разрешённым ему тегам рабочий набор BE и строит план запроса только по репликам, размещённым на этих BE. Если у таблицы нет реплики ни на одном из разрешённых пользователю тегов, построение плана завершается ошибкой "no queryable replicas".
- Разделите загрузку на две части. Задание загрузки состоит из вычислительной части (чтение источника, преобразование, распределение) и части записи (кодирование, сжатие, сохранение). Вычислительная часть учитывает тег пользователя. Часть записи должна выполняться на тех BE, где находятся реплики таблицы, независимо от тега. Поэтому если Stream Load запускает пользователь, привязанный к
offline, вычисления выполняются на BE пула offline, но запись всё равно затрагивает все BE, на которых находятся реплики.
Быстрый старт
-- Tag two BEs into 'online', one into 'offline'
ALTER SYSTEM MODIFY BACKEND "be1:9050" SET ("tag.location" = "online");
ALTER SYSTEM MODIFY BACKEND "be2:9050" SET ("tag.location" = "online");
ALTER SYSTEM MODIFY BACKEND "be3:9050" SET ("tag.location" = "offline");

-- Place 2 replicas in 'online', 1 in 'offline'
CREATE TABLE orders (id BIGINT, region STRING, amount DECIMAL(18,2))
DISTRIBUTED BY HASH(id) BUCKETS 8
PROPERTIES ("replication_allocation" = "tag.location.online:2, tag.location.offline:1");

-- Bind users to their pools
SET PROPERTY FOR 'bi_user'  'resource_tags.location' = 'online';
SET PROPERTY FOR 'etl_user' 'resource_tags.location' = 'offline';
Ожидаемый результат
+----------+-------+---------+
| Host     | Alive | Tag     |
+----------+-------+---------+
| be1:9050 | true  | online  |
| be2:9050 | true  | online  |
| be3:9050 | true  | offline |
+----------+-------+---------+
SHOW BACKENDS подтверждает назначение тегов. После переподключения bi_user планы его запросов используют две реплики online и никогда не обращаются к be3. Запросы etl_user выполняются на be3 и читают единственную реплику offline. Сбой BE на be3 остаётся незаметным для bi_user.
Когда стоит использовать Apache Doris Resource Group?
Apache Doris Resource Group подходит для любого развёртывания, где требуется изоляция нагрузок на уровне процессов BE в одном кластере и допустимы дополнительные затраты на хранение одной реплики для каждого пула.
Подходящие сценарии
- Разделение чтения и записи в одном кластере: офлайн-пул для ETL, онлайн-пул для дашбордов и единый общий набор данных с одной репликой в каждом пуле.
- Кластеры с несколькими арендаторами, где сбой или OOM на BE одного арендатора не должен вызывать аварийные оповещения у остальных.
- Объединение нескольких физических кластеров в один с сохранением изоляции нагрузок от сбоев друг друга.
- Использование Workload Group внутри каждого пула для дальнейшего распределения CPU и памяти на уровне отдельных запросов. См. Workload Group.
Неподходящие сценарии
- Вам нужны только мягкие ограничения CPU и памяти, и вы допускаете, что сбой BE остановит все нагрузки. Используйте только Workload Group. Он также поддерживает запросы между группами, которые Resource Group выполнять не может.
- Расходы на хранение жёстко ограничены. Каждому пулу, который читает таблицу, нужна собственная реплика. Пять пулов означают пять реплик каждой общей таблицы; расходы на хранение растут линейно с количеством групп.
- Вы используете развёртывание с разделением хранения и вычислений (облачное). Его аналог — Compute Group, который обеспечивает такую же изоляцию на уровне узлов без увеличения числа реплик, поскольку хранилище общее.
- Ресурсоёмкая ad-hoc-аналитика, охватывающая несколько пулов. Планировщик не может объединить BE с разными тегами для выполнения одного запроса; при отсутствии реплик возникает ошибка "no queryable replicas", а резервный вариант выполнения не выбирается.
- Загрузки, для которых вы ожидаете изоляции и на этапе записи. Запись всегда выполняется на BE, где находятся реплики; тег учитывается только при вычислениях.
Дополнительные материалы
- Справочник по Resource Group: все команды SQL, правила проверки и подробности разделения загрузки.
- Обзор управления нагрузками: сравнение Resource Group, Workload Group и Compute Group.
- Workload Group: механизм изоляции внутри процесса, который обычно используют вместе с Resource Group.
- Compute Group: аналог для архитектуры с разделением хранения и вычислений, который не увеличивает объём хранимых данных.
- Изоляция нагрузок арендаторов в Apache Doris: статья об устройстве всех механизмов изоляции, в том числе о том, как Resource Group дополняет Workload Group.