Использование Doris и Iceberg
Новая открытая архитектура управления данными Data Lakehouse объединяет высокую производительность и возможности работы в реальном времени, присущие хранилищу данных, с низкой стоимостью и гибкостью озера данных, помогая пользователям удобнее решать различные задачи обработки и анализа данных. Эта архитектура всё шире применяется в корпоративных системах больших данных.
В последних версиях Apache Doris расширил интеграцию с озёрами данных и теперь предлагает зрелое решение Data Lakehouse.
- Начиная с версии 0.15, в Apache Doris появились внешние таблицы Hive и Iceberg, что позволило изучить возможности совместного использования с Apache Iceberg для озёр данных.
- Начиная с версии 1.2, в Apache Doris официально появилась функция Multi-Catalog, которая обеспечивает автоматическое сопоставление метаданных и доступ к данным из различных источников. Также были реализованы многочисленные оптимизации производительности чтения внешних данных и выполнения запросов. Теперь Doris полностью поддерживает построение быстрой и удобной архитектуры Lakehouse.
- В версии 2.1 Apache Doris дополнительно усовершенствовал архитектуру Data Lakehouse, расширив возможности чтения и записи распространённых форматов озёр данных (Hudi, Iceberg, Paimon и т. д.), добавив совместимость с несколькими диалектами SQL и возможность плавной миграции из существующих систем в Apache Doris. Для задач Data Science и чтения больших объёмов данных Doris интегрировал высокоскоростной интерфейс чтения Arrow Flight, повысив эффективность передачи данных в 100 раз.
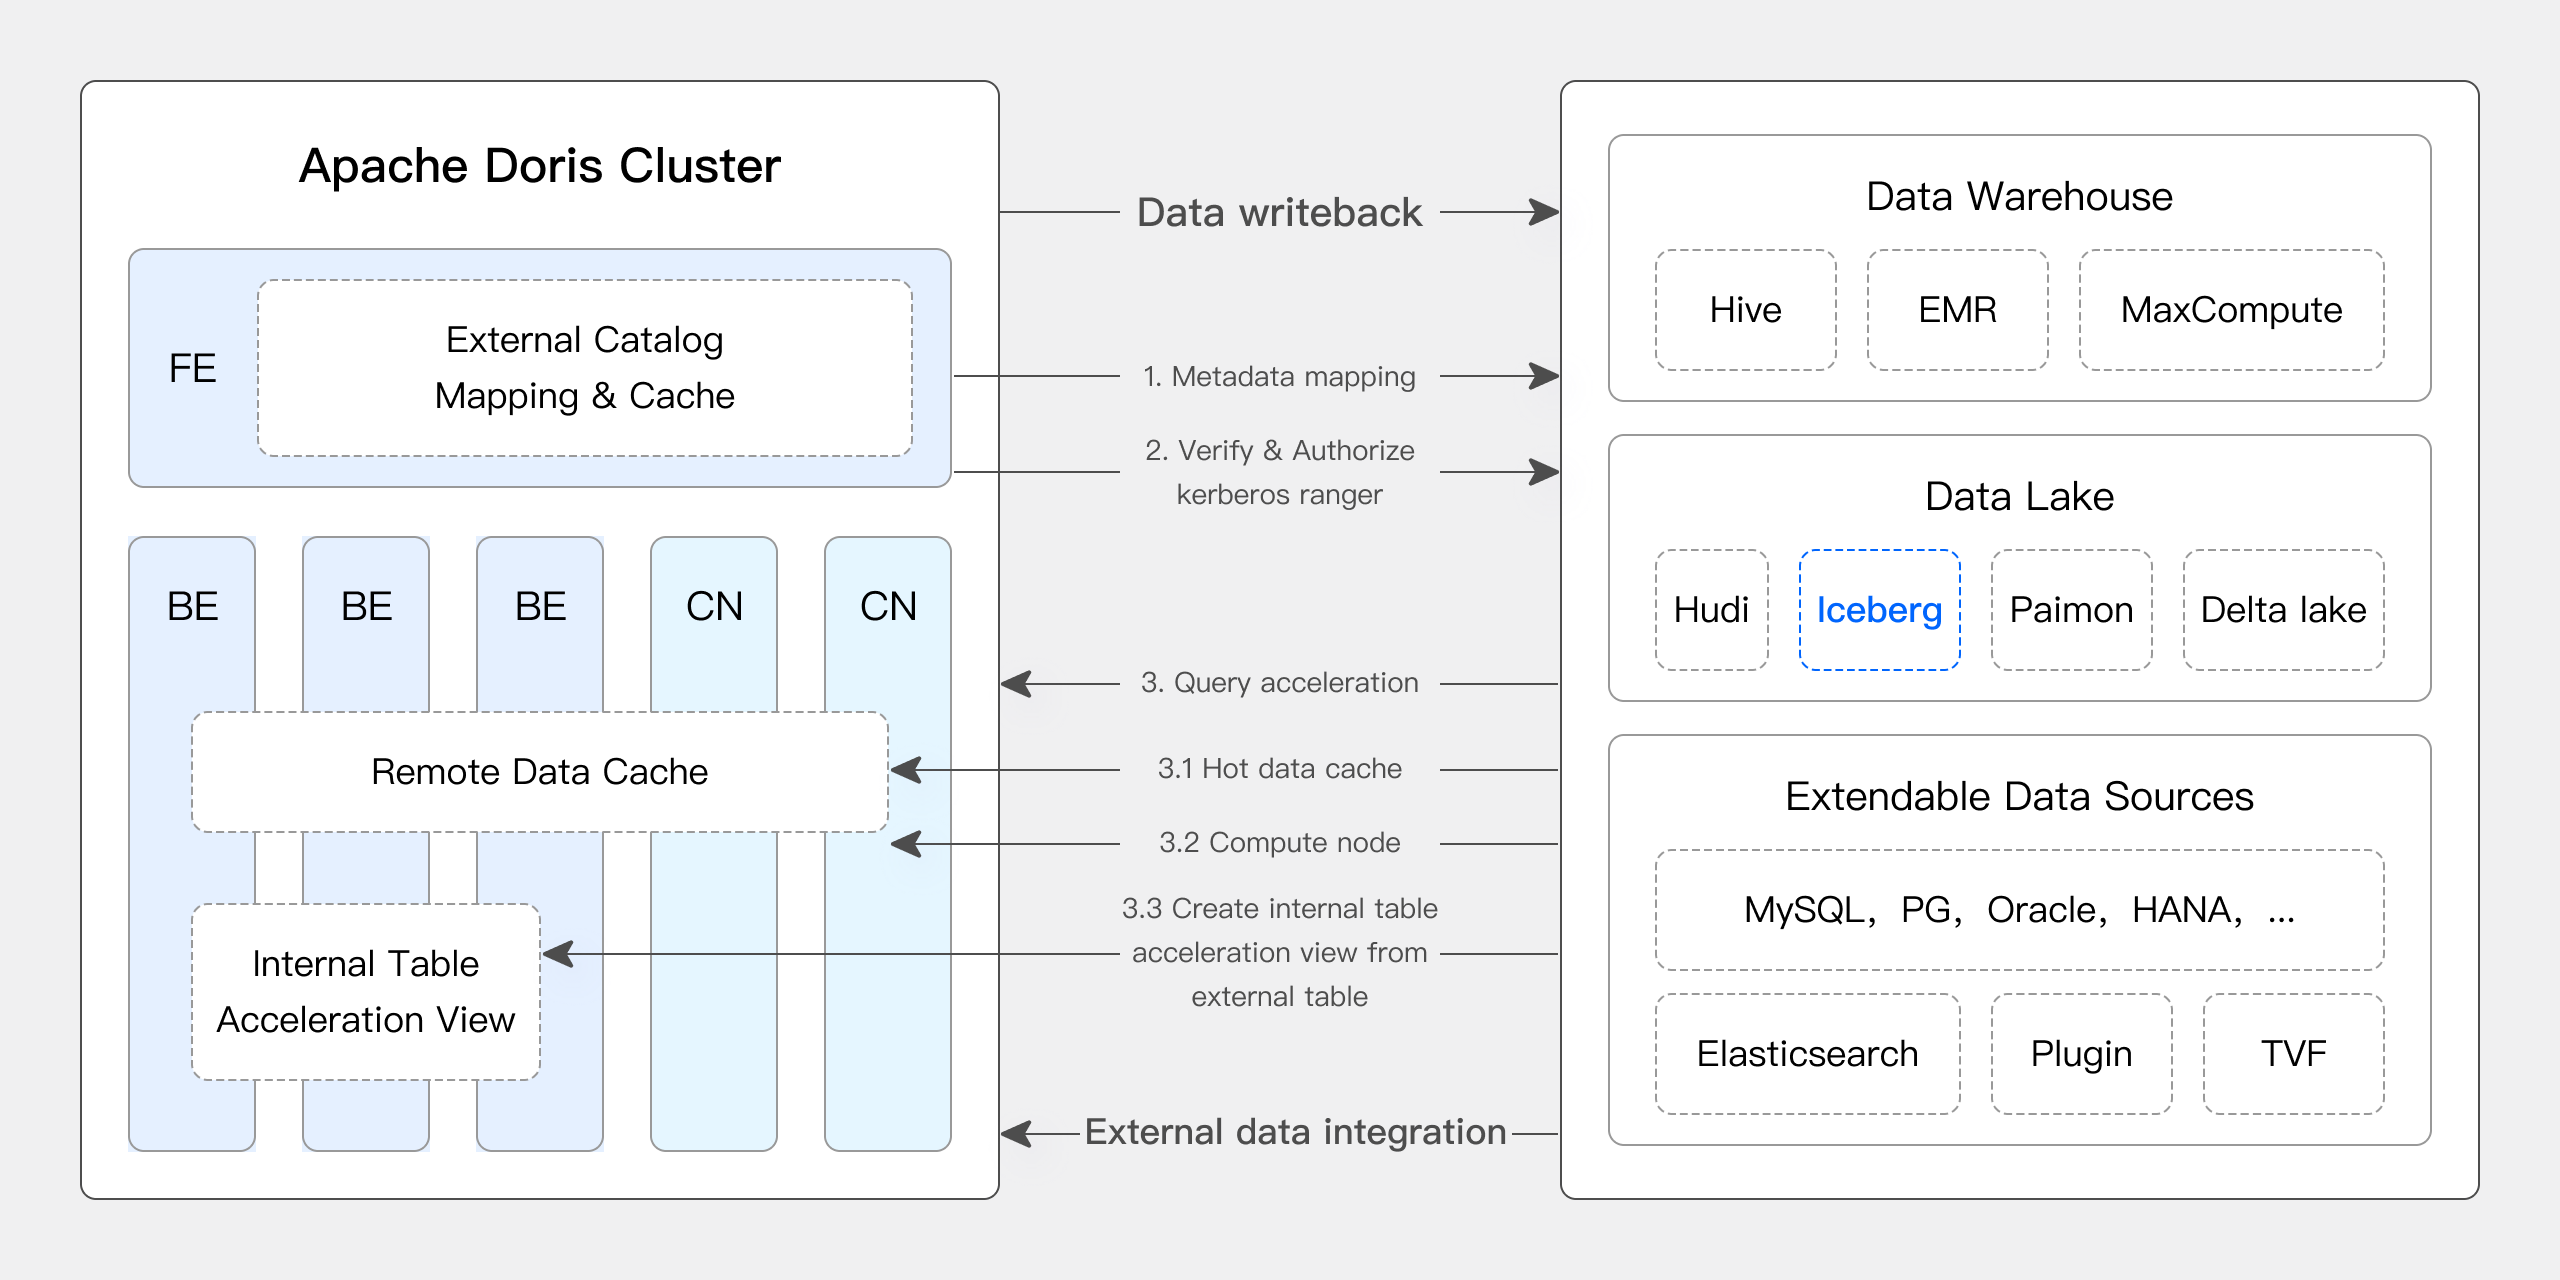
Apache Doris & Iceberg
Apache Iceberg представляет собой высокопроизводительный и надёжный формат таблиц озера данных с открытым исходным кодом, который позволяет анализировать огромные объёмы данных и управлять ими. Он поддерживает различные распространённые движки запросов, включая Apache Doris, совместим с HDFS и различными облачными объектными хранилищами, обеспечивает соответствие требованиям ACID, эволюцию схемы, расширенную фильтрацию, скрытое партиционирование и эволюцию схемы партиционирования. Эти возможности, наряду с Time Travel и откатом версий, обеспечивают высокую производительность запросов, надёжность, согласованность и гибкость данных.
Apache Doris предоставляет встроенную поддержку ряда основных возможностей Iceberg:
- Поддержка нескольких типов Iceberg Catalog, таких как Hive Metastore, Hadoop, REST, Glue, Google Dataproc Metastore, DLF и т. д.
- Встроенная поддержка форматов таблиц Iceberg V1/V2 и чтения файлов Position Delete и Equality Delete.
- Поддержка запросов к истории снимков таблиц Iceberg с помощью табличных функций.
- Поддержка функции Time Travel.
- Встроенная поддержка движка таблиц Iceberg. Она позволяет Apache Doris напрямую создавать таблицы Iceberg, управлять ими и записывать в них данные. Поддерживается полный набор функций Transform для партиционирования, обеспечивающий такие возможности, как скрытое партиционирование и эволюция схемы партиционирования.
- Поддержка DML на уровне строк для таблиц Iceberg V2, включая
UPDATE,DELETEиMERGE INTO.
Пользователи могут быстро создать эффективное решение Data Lakehouse на основе Apache Doris + Apache Iceberg, чтобы гибко решать различные задачи анализа и обработки данных в реальном времени.
- Используйте высокопроизводительный движок запросов Doris для анализа данных, объединяя данные таблиц Iceberg с другими источниками и создавая единую платформу федеративного анализа данных.
- Управляйте таблицами Iceberg и создавайте их непосредственно через Doris, выполняйте очистку, обработку и запись данных в таблицы Iceberg средствами Doris, создавая единую платформу обработки данных для озёр данных.
- Предоставляйте данные Doris другим системам, расположенным выше и ниже по цепочке обработки, для дальнейшей обработки через движок таблиц Iceberg, создавая единую открытую платформу хранения данных.
В будущем Apache Iceberg станет одним из встроенных движков таблиц Apache Doris, предоставляя более полный набор функций анализа данных в форматах озёр данных и управления ими. Apache Doris уже поддерживает основные операции DML на уровне строк в Iceberg, включая INSERT, UPDATE, DELETE и MERGE INTO, и продолжит совершенствовать такие возможности, как сортировка при записи, инкрементальное чтение данных и управление метаданными, чтобы совместно создать единую высокопроизводительную платформу озера данных, работающую в реальном времени.
Дополнительную информацию см. в разделе Iceberg Catalog
Руководство пользователя
В этом документе описано, как быстро развернуть тестовую и демонстрационную среду Apache Doris + Apache Iceberg с помощью Docker, а также показано использование различных функций.
Все скрипты и код, упомянутые в этом документе, доступны по адресу: https://github.com/apache/doris/tree/master/samples/datalake/iceberg_and_paimon
01 Подготовка среды
В этом документе для развёртывания используется Docker Compose со следующими компонентами и версиями:
| Компонент | Версия |
|---|---|
| Apache Doris | По умолчанию 2.1.5, можно изменить |
| Apache Iceberg | 1.4.3 |
| MinIO | RELEASE.2024-04-29T09-56-05Z |
02 Развёртывание среды
-
Запустите все компоненты
bash ./start_all.sh -
После запуска можно использовать следующий скрипт для входа в командную строку Doris:
-- login doris
bash ./start_doris_client.sh
03 Создание таблицы Iceberg
После входа в командную строку Doris вы обнаружите, что в кластере Doris уже создан Iceberg Catalog с именем Iceberg (его можно просмотреть с помощью SHOW CATALOGS/SHOW CREATE CATALOG iceberg). Ниже приведена инструкция создания этого Catalog:
-- Already created
CREATE CATALOG `iceberg` PROPERTIES (
    "type" = "iceberg",
    "iceberg.catalog.type" = "rest",
    "warehouse" = "s3://warehouse/",
    "uri" = "http://rest:8181",
    "s3.access_key" = "admin",
    "s3.secret_key" = "password",
    "s3.endpoint" = "http://minio:9000"
);
Создайте базу данных и таблицу Iceberg в Iceberg Catalog:
mysql> SWITCH iceberg;
Query OK, 0 rows affected (0.00 sec)

mysql> CREATE DATABASE nyc;
Query OK, 0 rows affected (0.12 sec)

mysql> CREATE TABLE iceberg.nyc.taxis
       (
           vendor_id BIGINT,
           trip_id BIGINT,
           trip_distance FLOAT,
           fare_amount DOUBLE,
           store_and_fwd_flag STRING,
           ts DATETIME
       )
       PARTITION BY LIST (vendor_id, DAY(ts)) ()
       PROPERTIES (
           "compression-codec" = "zstd",
           "write-format" = "parquet"
       );
Query OK, 0 rows affected (0.15 sec)
04 Вставка данных
Вставьте данные в таблицу Iceberg:
mysql> INSERT INTO iceberg.nyc.taxis
       VALUES
        (1, 1000371, 1.8, 15.32, 'N', '2024-01-01 9:15:23'),
        (2, 1000372, 2.5, 22.15, 'N', '2024-01-02 12:10:11'),
        (2, 1000373, 0.9, 9.01, 'N', '2024-01-01 3:25:15'),
        (1, 1000374, 8.4, 42.13, 'Y', '2024-01-03 7:12:33');
Query OK, 4 rows affected (1.61 sec)
{'status':'COMMITTED', 'txnId':'10085'}
Создайте таблицу Iceberg с помощью CREATE TABLE AS SELECT:
mysql> CREATE TABLE iceberg.nyc.taxis2 AS SELECT * FROM iceberg.nyc.taxis;
Query OK, 4 rows affected (0.25 sec)
{'status':'COMMITTED', 'txnId':'10088'}
05 Запросы к данным
-
Простой запрос
mysql> SELECT * FROM iceberg.nyc.taxis;
+-----------+---------+---------------+-------------+--------------------+----------------------------+
| vendor_id | trip_id | trip_distance | fare_amount | store_and_fwd_flag | ts                         |
+-----------+---------+---------------+-------------+--------------------+----------------------------+
|         1 | 1000374 |           8.4 |       42.13 | Y                  | 2024-01-03 07:12:33.000000 |
|         1 | 1000371 |           1.8 |       15.32 | N                  | 2024-01-01 09:15:23.000000 |
|         2 | 1000373 |           0.9 |        9.01 | N                  | 2024-01-01 03:25:15.000000 |
|         2 | 1000372 |           2.5 |       22.15 | N                  | 2024-01-02 12:10:11.000000 |
+-----------+---------+---------------+-------------+--------------------+----------------------------+
4 rows in set (0.37 sec)

mysql> SELECT * FROM iceberg.nyc.taxis2;
+-----------+---------+---------------+-------------+--------------------+----------------------------+
| vendor_id | trip_id | trip_distance | fare_amount | store_and_fwd_flag | ts                         |
+-----------+---------+---------------+-------------+--------------------+----------------------------+
|         1 | 1000374 |           8.4 |       42.13 | Y                  | 2024-01-03 07:12:33.000000 |
|         1 | 1000371 |           1.8 |       15.32 | N                  | 2024-01-01 09:15:23.000000 |
|         2 | 1000373 |           0.9 |        9.01 | N                  | 2024-01-01 03:25:15.000000 |
|         2 | 1000372 |           2.5 |       22.15 | N                  | 2024-01-02 12:10:11.000000 |
+-----------+---------+---------------+-------------+--------------------+----------------------------+
4 rows in set (0.35 sec) -
Отсечение партиций
mysql> SELECT * FROM iceberg.nyc.taxis where vendor_id = 2 and ts >= '2024-01-01' and ts < '2024-01-02';
+-----------+---------+---------------+-------------+--------------------+----------------------------+
| vendor_id | trip_id | trip_distance | fare_amount | store_and_fwd_flag | ts                         |
+-----------+---------+---------------+-------------+--------------------+----------------------------+
|         2 | 1000373 |           0.9 |        9.01 | N                  | 2024-01-01 03:25:15.000000 |
+-----------+---------+---------------+-------------+--------------------+----------------------------+
1 row in set (0.06 sec)

mysql> EXPLAIN VERBOSE SELECT * FROM iceberg.nyc.taxis where vendor_id = 2 and ts >= '2024-01-01' and ts < '2024-01-02';

....
|   0:VICEBERG_SCAN_NODE(71)
|      table: taxis
|      predicates: (ts[#5] < '2024-01-02 00:00:00'), (vendor_id[#0] = 2), (ts[#5] >= '2024-01-01 00:00:00')
|      inputSplitNum=1, totalFileSize=3539, scanRanges=1
|      partition=1/0
|      backends:
|        10002
|          s3://warehouse/wh/nyc/taxis/data/vendor_id=2/ts_day=2024-01-01/40e6ca404efa4a44-b888f23546d3a69c_5708e229-2f3d-4b68-a66b-44298a9d9815-0.zstd.parquet start: 0 length: 3539
|      cardinality=6, numNodes=1
|      pushdown agg=NONE
|      icebergPredicatePushdown=
|           ref(name="ts") < 1704153600000000
|           ref(name="vendor_id") == 2
|           ref(name="ts") >= 1704067200000000
....
Из результата инструкции
EXPLAIN VERBOSEвидно, что условие предикатаvendor_id = 2 and ts >= '2024-01-01' and ts < '2024-01-02'в итоге охватывает только одну партицию (partition=1/0).Также видно, что, поскольку при создании таблицы была указана функция Transform для партиционирования
DAY(ts), исходное значение данных2024-01-01 03:25:15.000000преобразуется в информацию о партиции в каталоге файловts_day=2024-01-01.
06 Time Travel
Вставим ещё несколько строк данных:
INSERT INTO iceberg.nyc.taxis VALUES (1, 1000375, 8.8, 55.55, 'Y', '2024-01-01 8:10:22'), (3, 1000376, 7.4, 32.35, 'N', '2024-01-02  1:14:45');
Query OK, 2 rows affected (0.17 sec)
{'status':'COMMITTED', 'txnId':'10086'}

mysql> SELECT * FROM iceberg.nyc.taxis;
+-----------+---------+---------------+-------------+--------------------+----------------------------+
| vendor_id | trip_id | trip_distance | fare_amount | store_and_fwd_flag | ts                         |
+-----------+---------+---------------+-------------+--------------------+----------------------------+
|         3 | 1000376 |           7.4 |       32.35 | N                  | 2024-01-02 01:14:45.000000 |
|         2 | 1000372 |           2.5 |       22.15 | N                  | 2024-01-02 12:10:11.000000 |
|         1 | 1000374 |           8.4 |       42.13 | Y                  | 2024-01-03 07:12:33.000000 |
|         1 | 1000371 |           1.8 |       15.32 | N                  | 2024-01-01 09:15:23.000000 |
|         1 | 1000375 |           8.8 |       55.55 | Y                  | 2024-01-01 08:10:22.000000 |
|         2 | 1000373 |           0.9 |        9.01 | N                  | 2024-01-01 03:25:15.000000 |
+-----------+---------+---------------+-------------+--------------------+----------------------------+
6 rows in set (0.11 sec)
Используйте системную таблицу $snapshots для запроса информации о снимках таблицы (до версии 4.1.4 также можно было использовать табличную функцию iceberg_meta(); начиная с версии 4.1.4 она удалена):
mysql> select * from iceberg.nyc.taxis$snapshots;
+---------------------+---------------------+---------------------+-----------+-----------------------------------------------------------------------------------------------------------+----------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------+
| committed_at        | snapshot_id         | parent_id           | operation | manifest_list                                                                                             | summary                                                                                                                                                                                                                                                        |
+---------------------+---------------------+---------------------+-----------+-----------------------------------------------------------------------------------------------------------+----------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------+
| 2024-07-29 03:38:22 | 8483933166442433486 |                  -1 | append    | s3://warehouse/wh/nyc/taxis/metadata/snap-8483933166442433486-1-5f7b7736-8022-4ba1-9db2-51ae7553be4d.avro | {"added-data-files":"4","added-records":"4","added-files-size":"14156","changed-partition-count":"4","total-records":"4","total-files-size":"14156","total-data-files":"4","total-delete-files":"0","total-position-deletes":"0","total-equality-deletes":"0"} |
| 2024-07-29 03:40:23 | 4726331391239920914 | 8483933166442433486 | append    | s3://warehouse/wh/nyc/taxis/metadata/snap-4726331391239920914-1-6aa3d142-6c9c-4553-9c04-08ad4d49a4ea.avro | {"added-data-files":"2","added-records":"2","added-files-size":"7078","changed-partition-count":"2","total-records":"6","total-files-size":"21234","total-data-files":"6","total-delete-files":"0","total-position-deletes":"0","total-equality-deletes":"0"}  |
+---------------------+---------------------+---------------------+-----------+-----------------------------------------------------------------------------------------------------------+----------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------+
2 rows in set (0.07 sec)
Выполните запрос к указанному снимку с помощью инструкции FOR VERSION AS OF:
mysql> SELECT * FROM iceberg.nyc.taxis FOR VERSION AS OF 8483933166442433486;
+-----------+---------+---------------+-------------+--------------------+----------------------------+
| vendor_id | trip_id | trip_distance | fare_amount | store_and_fwd_flag | ts                         |
+-----------+---------+---------------+-------------+--------------------+----------------------------+
|         1 | 1000371 |           1.8 |       15.32 | N                  | 2024-01-01 09:15:23.000000 |
|         1 | 1000374 |           8.4 |       42.13 | Y                  | 2024-01-03 07:12:33.000000 |
|         2 | 1000372 |           2.5 |       22.15 | N                  | 2024-01-02 12:10:11.000000 |
|         2 | 1000373 |           0.9 |        9.01 | N                  | 2024-01-01 03:25:15.000000 |
+-----------+---------+---------------+-------------+--------------------+----------------------------+
4 rows in set (0.05 sec)

mysql> SELECT * FROM iceberg.nyc.taxis FOR VERSION AS OF 4726331391239920914;
+-----------+---------+---------------+-------------+--------------------+----------------------------+
| vendor_id | trip_id | trip_distance | fare_amount | store_and_fwd_flag | ts                         |
+-----------+---------+---------------+-------------+--------------------+----------------------------+
|         1 | 1000374 |           8.4 |       42.13 | Y                  | 2024-01-03 07:12:33.000000 |
|         1 | 1000375 |           8.8 |       55.55 | Y                  | 2024-01-01 08:10:22.000000 |
|         3 | 1000376 |           7.4 |       32.35 | N                  | 2024-01-02 01:14:45.000000 |
|         2 | 1000372 |           2.5 |       22.15 | N                  | 2024-01-02 12:10:11.000000 |
|         2 | 1000373 |           0.9 |        9.01 | N                  | 2024-01-01 03:25:15.000000 |
|         1 | 1000371 |           1.8 |       15.32 | N                  | 2024-01-01 09:15:23.000000 |
+-----------+---------+---------------+-------------+--------------------+----------------------------+
6 rows in set (0.04 sec)
Выполните запрос к указанному снимку с помощью инструкции FOR TIME AS OF:
mysql> SELECT * FROM iceberg.nyc.taxis FOR TIME AS OF "2024-07-29 03:38:23";
+-----------+---------+---------------+-------------+--------------------+----------------------------+
| vendor_id | trip_id | trip_distance | fare_amount | store_and_fwd_flag | ts                         |
+-----------+---------+---------------+-------------+--------------------+----------------------------+
|         1 | 1000374 |           8.4 |       42.13 | Y                  | 2024-01-03 07:12:33.000000 |
|         1 | 1000371 |           1.8 |       15.32 | N                  | 2024-01-01 09:15:23.000000 |
|         2 | 1000372 |           2.5 |       22.15 | N                  | 2024-01-02 12:10:11.000000 |
|         2 | 1000373 |           0.9 |        9.01 | N                  | 2024-01-01 03:25:15.000000 |
+-----------+---------+---------------+-------------+--------------------+----------------------------+
4 rows in set (0.04 sec)

mysql> SELECT * FROM iceberg.nyc.taxis FOR TIME AS OF "2024-07-29 03:40:22";
+-----------+---------+---------------+-------------+--------------------+----------------------------+
| vendor_id | trip_id | trip_distance | fare_amount | store_and_fwd_flag | ts                         |
+-----------+---------+---------------+-------------+--------------------+----------------------------+
|         2 | 1000373 |           0.9 |        9.01 | N                  | 2024-01-01 03:25:15.000000 |
|         1 | 1000374 |           8.4 |       42.13 | Y                  | 2024-01-03 07:12:33.000000 |
|         2 | 1000372 |           2.5 |       22.15 | N                  | 2024-01-02 12:10:11.000000 |
|         1 | 1000371 |           1.8 |       15.32 | N                  | 2024-01-01 09:15:23.000000 |
+-----------+---------+---------------+-------------+--------------------+----------------------------+
4 rows in set (0.05 sec)
07 DML на уровне строк в Iceberg
Для DML на уровне строк (UPDATE, DELETE и MERGE INTO) целевая таблица должна использовать Iceberg V2. Чтобы сохранить состояние iceberg.nyc.taxis из раздела Time Travel без изменений, в следующем примере отдельная таблица инициализируется данными из iceberg.nyc.taxis2.
mysql> CREATE TABLE iceberg.nyc.taxis_dml
       (
           vendor_id BIGINT,
           trip_id BIGINT,
           trip_distance FLOAT,
           fare_amount DOUBLE,
           store_and_fwd_flag STRING,
           ts DATETIME
       )
       PARTITION BY LIST (vendor_id, DAY(ts)) ()
       PROPERTIES (
           "format-version" = "2",
           "compression-codec" = "zstd",
           "write-format" = "parquet"
       );
Query OK, 0 rows affected (0.18 sec)

mysql> INSERT INTO iceberg.nyc.taxis_dml SELECT * FROM iceberg.nyc.taxis2;
Query OK, 4 rows affected (0.32 sec)
{'status':'COMMITTED', 'txnId':'10089'}
Обновите строки в таблице Iceberg:
mysql> UPDATE iceberg.nyc.taxis_dml
       SET fare_amount = fare_amount + 3,
           store_and_fwd_flag = 'Y'
       WHERE trip_id = 1000371;
Query OK, 1 row affected (0.44 sec)
{'status':'COMMITTED', 'txnId':'10090'}

mysql> SELECT trip_id, fare_amount, store_and_fwd_flag
       FROM iceberg.nyc.taxis_dml
       WHERE trip_id = 1000371;
+---------+-------------+--------------------+
| trip_id | fare_amount | store_and_fwd_flag |
+---------+-------------+--------------------+
| 1000371 |       18.32 | Y                  |
+---------+-------------+--------------------+
1 row in set (0.07 sec)
Удалите строки из таблицы Iceberg:
mysql> DELETE FROM iceberg.nyc.taxis_dml
       WHERE trip_id = 1000373;
Query OK, 1 row affected (0.31 sec)
{'status':'COMMITTED', 'txnId':'10091'}

mysql> SELECT trip_id
       FROM iceberg.nyc.taxis_dml
       ORDER BY trip_id;
+---------+
| trip_id |
+---------+
| 1000371 |
| 1000372 |
| 1000374 |
+---------+
3 rows in set (0.06 sec)
Используйте MERGE INTO, чтобы обновить существующие строки и вставить новые одной инструкцией:
mysql> MERGE INTO iceberg.nyc.taxis_dml t
       USING (
           SELECT 2 AS vendor_id, 1000372 AS trip_id, 2.5 AS trip_distance,
                  30.00 AS fare_amount, 'Y' AS store_and_fwd_flag,
                  CAST('2024-01-02 12:10:11' AS DATETIME) AS ts
           UNION ALL
           SELECT 3, 1000380, 6.7, 28.50, 'N', CAST('2024-01-04 10:20:00' AS DATETIME)
       ) s
       ON t.trip_id = s.trip_id
       WHEN MATCHED THEN UPDATE SET
           fare_amount = s.fare_amount,
           store_and_fwd_flag = s.store_and_fwd_flag
       WHEN NOT MATCHED THEN INSERT
           (vendor_id, trip_id, trip_distance, fare_amount, store_and_fwd_flag, ts)
       VALUES
           (s.vendor_id, s.trip_id, s.trip_distance, s.fare_amount, s.store_and_fwd_flag, s.ts);
Query OK, 2 rows affected (0.53 sec)
{'status':'COMMITTED', 'txnId':'10092'}

mysql> SELECT vendor_id, trip_id, fare_amount, store_and_fwd_flag
       FROM iceberg.nyc.taxis_dml
       ORDER BY trip_id;
+-----------+---------+-------------+--------------------+
| vendor_id | trip_id | fare_amount | store_and_fwd_flag |
+-----------+---------+-------------+--------------------+
|         1 | 1000371 |       18.32 | Y                  |
|         2 | 1000372 |       30.00 | Y                  |
|         1 | 1000374 |       42.13 | Y                  |
|         3 | 1000380 |       28.50 | N                  |
+-----------+---------+-------------+--------------------+
4 rows in set (0.09 sec)
08 Взаимодействие с PyIceberg
Используйте Doris 2.1.8/3.0.4 или более позднюю версию.
Чтобы сохранить предыдущие примеры без изменений, в примерах ниже используется nyc.taxis2.
Загрузите таблицу Iceberg:
from pyiceberg.catalog import load_catalog

catalog = load_catalog(
	"iceberg",
	**{
		"warehouse" = "warehouse",
		"uri" = "http://rest:8181",
		"s3.access-key-id" = "admin",
		"s3.secret-access-key" = "password",
		"s3.endpoint" = "http://minio:9000"
	},
)
table = catalog.load_table("nyc.taxis2")
Прочитайте таблицу как Arrow Table:
print(table.scan().to_arrow())

pyarrow.Table
vendor_id: int64
trip_id: int64
trip_distance: float
fare_amount: double
store_and_fwd_flag: large_string
ts: timestamp[us]
----
vendor_id: [[1],[1],[2],[2]]
trip_id: [[1000371],[1000374],[1000373],[1000372]]
trip_distance: [[1.8],[8.4],[0.9],[2.5]]
fare_amount: [[15.32],[42.13],[9.01],[22.15]]
store_and_fwd_flag: [["N"],["Y"],["N"],["N"]]
ts: [[2024-01-01 09:15:23.000000],[2024-01-03 07:12:33.000000],[2024-01-01 03:25:15.000000],[2024-01-02 12:10:11.000000]]
Прочитайте таблицу как Pandas DataFrame:
print(table.scan().to_pandas())

vendor_id  trip_id  trip_distance  fare_amount store_and_fwd_flag                    ts
0          1  1000371            1.8        15.32                  N   2024-01-01 09:15:23
1          1  1000374            8.4        42.13                  Y   2024-01-03 07:12:33
2          2  1000373            0.9         9.01                  N   2024-01-01 03:25:15
3          2  1000372            2.5        22.15                  N   2024-01-02 12:10:11
Прочитайте таблицу как Polars DataFrame:
import polars as pl

print(pl.scan_iceberg(table).collect())

shape: (4, 6)
┌───────────┬─────────┬───────────────┬─────────────┬────────────────────┬─────────────────────┐
│ vendor_id ┆ trip_id ┆ trip_distance ┆ fare_amount ┆ store_and_fwd_flag ┆ ts                  │
│ ---       ┆ ---     ┆ ---           ┆ ---         ┆ ---                ┆ ---                 │
│ i64       ┆ i64     ┆ f32           ┆ f64         ┆ str                ┆ datetime[μs]        │
╞═══════════╪═════════╪═══════════════╪═════════════╪════════════════════╪═════════════════════╡
│ 1         ┆ 1000371 ┆ 1.8           ┆ 15.32       ┆ N                  ┆ 2024-01-01 09:15:23 │
│ 1         ┆ 1000374 ┆ 8.4           ┆ 42.13       ┆ Y                  ┆ 2024-01-03 07:12:33 │
│ 2         ┆ 1000373 ┆ 0.9           ┆ 9.01        ┆ N                  ┆ 2024-01-01 03:25:15 │
│ 2         ┆ 1000372 ┆ 2.5           ┆ 22.15       ┆ N                  ┆ 2024-01-02 12:10:11 │
└───────────┴─────────┴───────────────┴─────────────┴────────────────────┴─────────────────────┘
О записи в таблицу Iceberg с помощью PyIceberg см. инструкцию
09 Приложение
Запись в таблицу Iceberg с помощью PyIceberg
Загрузите таблицу Iceberg:
from pyiceberg.catalog import load_catalog

catalog = load_catalog(
	"iceberg",
	**{
		"warehouse" = "warehouse",
		"uri" = "http://rest:8181",
		"s3.access-key-id" = "admin",
		"s3.secret-access-key" = "password",
		"s3.endpoint" = "http://minio:9000"
	},
)
table = catalog.load_table("nyc.taxis2")
Запишите данные в таблицу с помощью Arrow Table:
import pyarrow as pa

df = pa.Table.from_pydict(
	{
		"vendor_id": pa.array([1, 2, 2, 1], pa.int64()),
		"trip_id": pa.array([1000371, 1000372, 1000373, 1000374], pa.int64()),
		"trip_distance": pa.array([1.8, 2.5, 0.9, 8.4], pa.float32()),
		"fare_amount": pa.array([15.32, 22.15, 9.01, 42.13], pa.float64()),
		"store_and_fwd_flag": pa.array(["N", "N", "N", "Y"], pa.string()),
		"ts": pa.compute.strptime(
			["2024-01-01 9:15:23", "2024-01-02 12:10:11", "2024-01-01 3:25:15", "2024-01-03 7:12:33"],
			"%Y-%m-%d %H:%M:%S",
			"us",
		),
	}
)
table.append(df)
Запишите данные в таблицу с помощью Pandas DataFrame:
import pyarrow as pa
import pandas as pd

df = pd.DataFrame(
	{
		"vendor_id": pd.Series([1, 2, 2, 1]).astype("int64[pyarrow]"),
		"trip_id": pd.Series([1000371, 1000372, 1000373, 1000374]).astype("int64[pyarrow]"),
		"trip_distance": pd.Series([1.8, 2.5, 0.9, 8.4]).astype("float32[pyarrow]"),
		"fare_amount": pd.Series([15.32, 22.15, 9.01, 42.13]).astype("float64[pyarrow]"),
		"store_and_fwd_flag": pd.Series(["N", "N", "N", "Y"]).astype("string[pyarrow]"),
		"ts": pd.Series(["2024-01-01 9:15:23", "2024-01-02 12:10:11", "2024-01-01 3:25:15", "2024-01-03 7:12:33"]).astype("timestamp[us][pyarrow]"),
	}
)
table.append(pa.Table.from_pandas(df))
Запишите данные в таблицу с помощью Polars DataFrame:
import polars as pl

df = pl.DataFrame(
	{
		"vendor_id": [1, 2, 2, 1],
		"trip_id": [1000371, 1000372, 1000373, 1000374],
		"trip_distance": [1.8, 2.5, 0.9, 8.4],
		"fare_amount": [15.32, 22.15, 9.01, 42.13],
		"store_and_fwd_flag": ["N", "N", "N", "Y"],
		"ts": ["2024-01-01 9:15:23", "2024-01-02 12:10:11", "2024-01-01 3:25:15", "2024-01-03 7:12:33"],
	},
	{
		"vendor_id": pl.Int64,
		"trip_id": pl.Int64,
		"trip_distance": pl.Float32,
		"fare_amount": pl.Float64,
		"store_and_fwd_flag": pl.String,
		"ts": pl.String,
	},
).with_columns(pl.col("ts").str.strptime(pl.Datetime, "%Y-%m-%d %H:%M:%S"))
table.append(df.to_arrow())