Движок выполнения Pipeline
Определение в одном предложении
Движок выполнения Pipeline представляет собой модель параллельного выполнения, которая начиная с версии 3.0 заменила в Doris модель volcano. Он опирается на реализацию Pipeline, описанную в статье Hyper, и разбивает запрос на Pipeline и PipelineTask, которые могут выполняться параллельно. Это позволяет полностью задействовать многоядерные CPU и ограничить число потоков запросов, решая проблему чрезмерного роста их количества.
Основные сведения
Прежде чем читать эту статью, следует ознакомиться со следующими положениями:
- Движок выполнения Pipeline полностью заменил исходную модель volcano начиная с Doris 3.0.
- На основе модели Pipeline Doris обеспечивает параллельную обработку запросов и операторов DDL и DML.
- Подробное описание архитектуры, реализации и результатов приведено в следующих двух DSIP:
Физический план
Чтобы понять модель выполнения Pipeline, сначала нужно разобраться с двумя основными понятиями физического плана запроса: PlanFragment и PlanNode. Для иллюстрации используется следующий пример SQL:
SELECT k1, SUM(v1) FROM A,B WHERE A.k2 = B.k2 GROUP BY k1 ORDER BY SUM(v1);
Логический план
FE сначала преобразует этот SQL в следующий логический план, где каждый узел представляет собой PlanNode. Описание каждого типа Node см. во введении к просмотру физического плана.
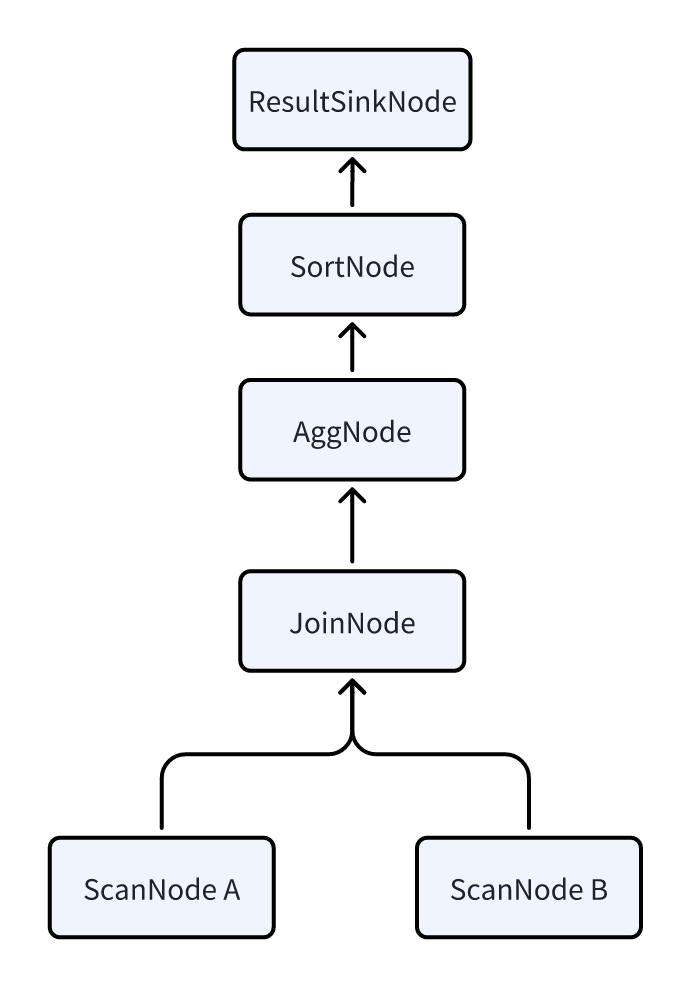
Физический план
Поскольку Doris использует архитектуру MPP, при выполнении каждого запроса система старается задействовать все BE параллельно, чтобы сократить задержку выполнения запроса. Поэтому логический план необходимо разделить, сформировав физический план:
- В логический план добавляются
DataSinkиExchangeNode. Эти два узла обеспечивают Shuffle данных между несколькими BE. - После разделения каждый PlanFragment содержит часть PlanNode и может быть отправлен на BE как независимая задача.
- Завершив вычисления для PlanNode внутри PlanFragment, BE перераспределяет данные на другие BE через
DataSinkиExchangeNodeдля продолжения вычислений.
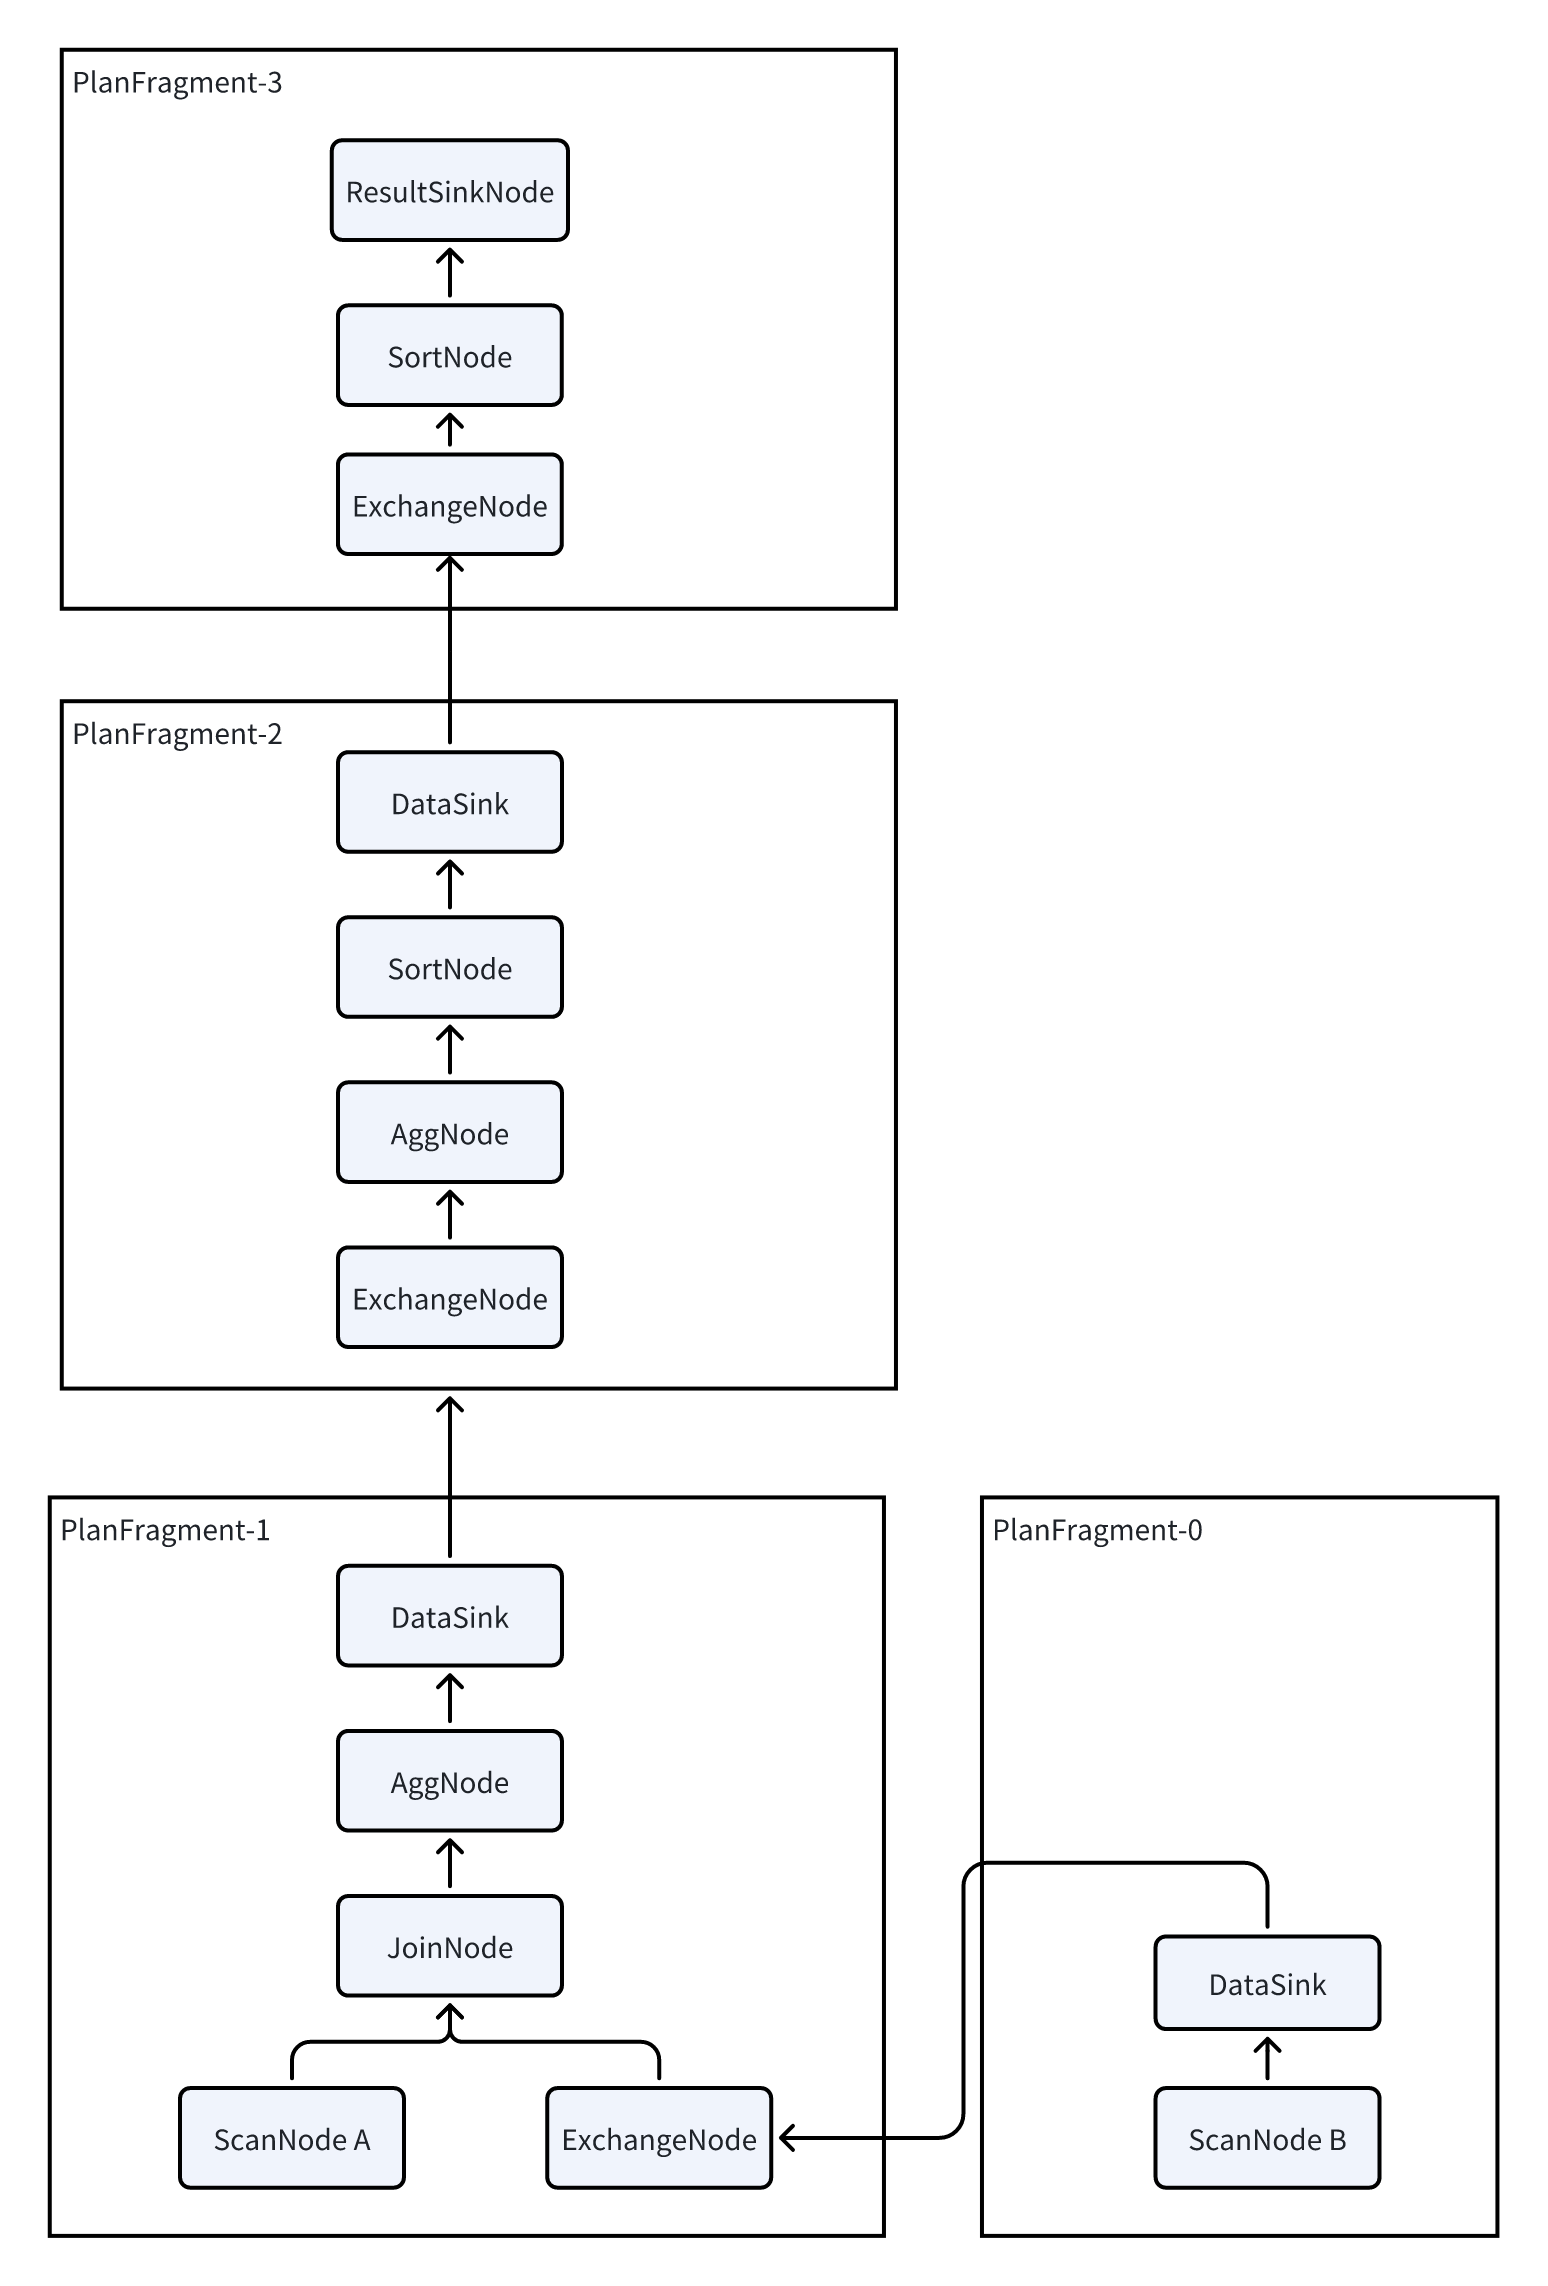
Трёхуровневая структура планирования
Планирование в Doris разделено на следующие 3 уровня:
| Уровень | Название | Описание |
|---|---|---|
| 1 | PLAN (план выполнения) | Планировщик выполнения преобразует оператор SQL в план выполнения, который затем выполняется движком выполнения. |
| 2 | FRAGMENT (фрагмент выполнения) | Doris представляет собой распределённый движок выполнения. Полный план выполнения разбивается на несколько фрагментов, каждый из которых выполняется на отдельном узле. FRAGMENT представляет собой полный фрагмент выполнения на одном узле, а несколько FRAGMENT вместе образуют полный PLAN. |
| 3 | PLAN NODE (оператор) | Наименьшая единица плана выполнения. FRAGMENT состоит из нескольких операторов, каждый из которых отвечает за определённую логику выполнения, например агрегацию или соединение. |
Модель выполнения Pipeline
PlanFragment представляет собой минимальную единицу задачи выполнения, которую FE отправляет на BE. BE может получить несколько разных PlanFragment, относящихся к одному запросу, и каждый PlanFragment обрабатывается независимо.
Получив PlanFragment, BE обрабатывает его следующим образом:
- Разбивает PlanFragment на несколько Pipeline.
- Запускает несколько PipelineTask для параллельного выполнения.
- Повышает эффективность выполнения запроса.
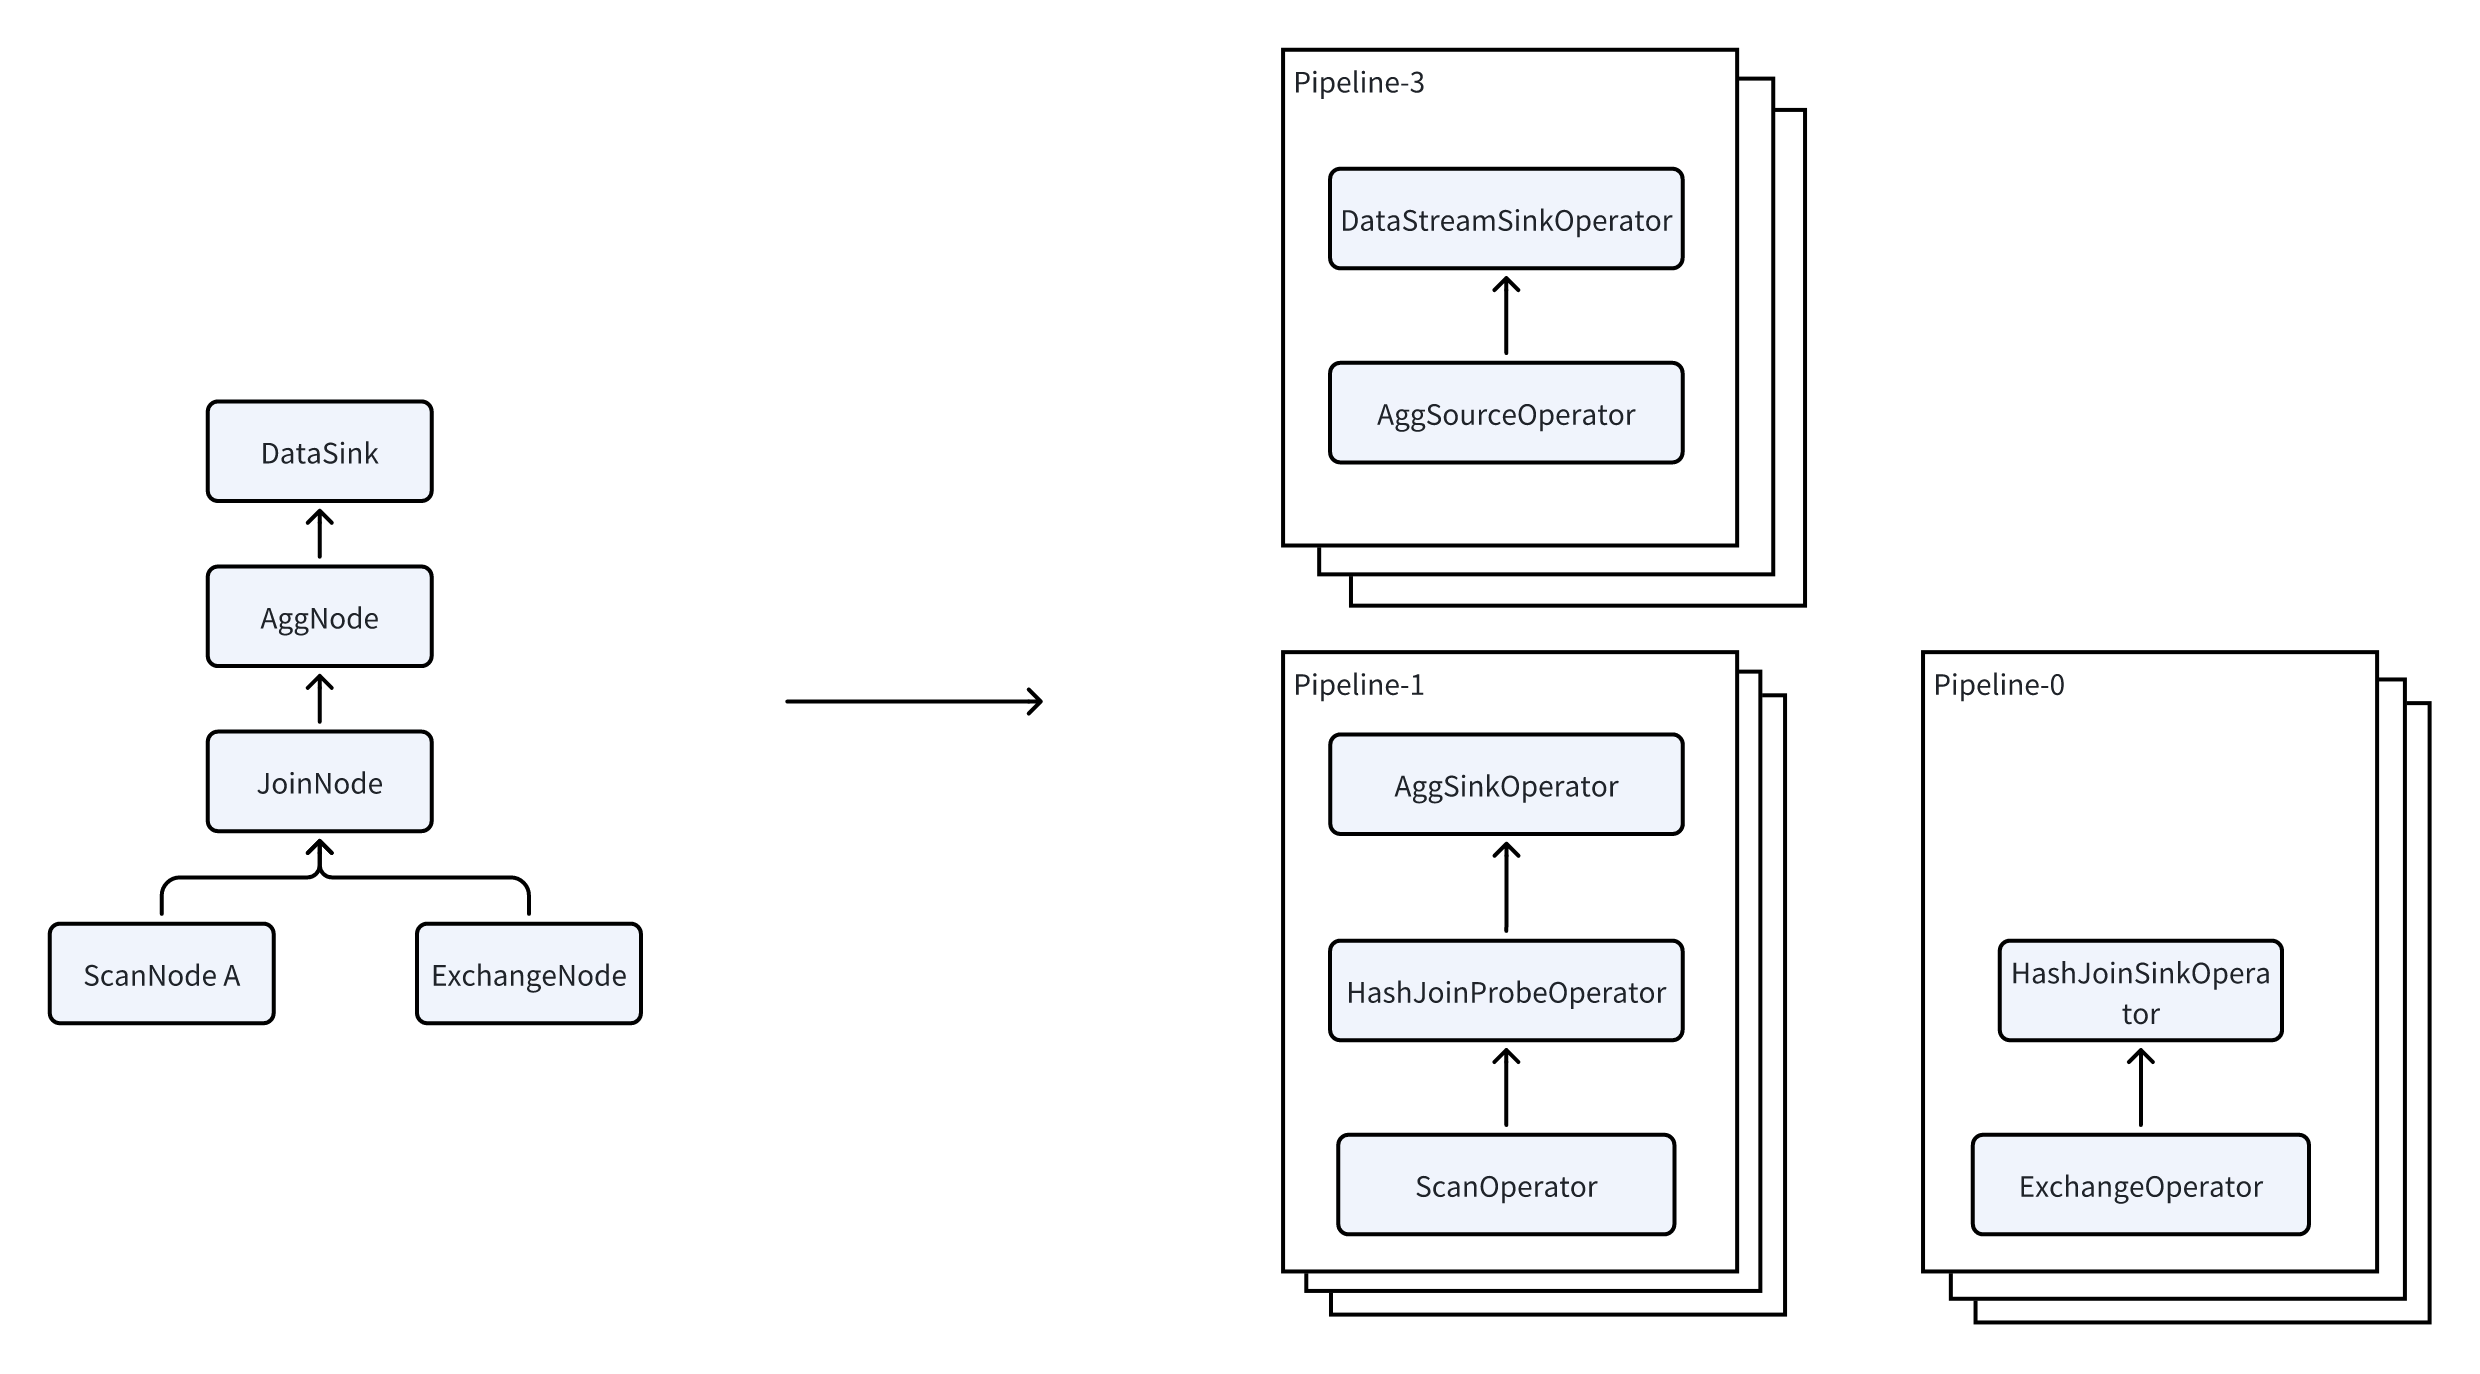
Pipeline
Pipeline состоит из следующих частей:
- Один SourceOperator: отвечает за чтение данных извне. Источником может быть таблица (OlapTable) или буфер (Exchange).
- Несколько других Operators в середине.
- Один SinkOperator: отвечает за вывод данных. Это может быть перераспределение данных по сети на другой узел (например,
DataStreamSinkOperator) или вывод в HashTable (например,JoinBuildHashTableдля оператора Agg).
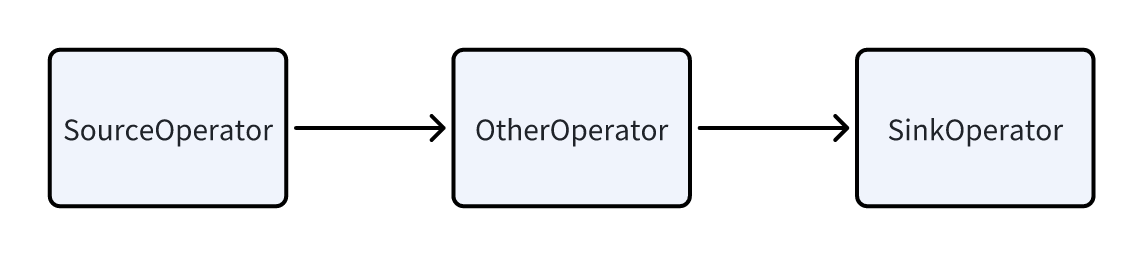
Зависимости между Pipeline (Dependency)
Между Pipeline существуют зависимости. Например, JoinNode фактически разбивается на 2 Pipeline:
- Pipeline-0: читает данные из Exchange для построения HashTable.
- Pipeline-1: читает данные из таблицы для выполнения Probe.
Эти два Pipeline связаны следующим образом:
- Выполнение Pipeline-1 зависит от завершения Pipeline-0.
- Такая связь называется Dependency.
- После завершения выполнения Pipeline-0 вызывает метод
set_readyобъекта Dependency, чтобы уведомить Pipeline-1 о возможности начать выполнение.
PipelineTask
По сути, Pipeline остаётся логическим понятием, а не исполняемой сущностью. Для фактического выполнения нужно создать на его основе несколько экземпляров PipelineTask:
- Данные для чтения распределяются между разными PipelineTask, что в итоге обеспечивает параллельную обработку.
- У всех PipelineTask одного Pipeline набор Operator полностью совпадает. Они различаются состоянием Operator (например, читают разные данные, строят разные HashTable и так далее). Эти различающиеся состояния называются LocalState.
- Каждый PipelineTask в итоге передаётся в пул потоков для выполнения как независимая задача.
Такой механизм, управляемый Dependency, позволяет эффективнее использовать многоядерные CPU и обеспечивает полноценный параллелизм.
Operator
В большинстве случаев каждый Operator в Pipeline соответствует одному PlanNode, однако для некоторых особых операторов это правило не действует:
| Исходный PlanNode | Операторы после разделения |
|---|---|
| JoinNode | JoinBuildOperator + JoinProbeOperator |
| AggNode | AggSinkOperator + AggSourceOperator |
| SortNode | SortSinkOperator + SortSourceOperator |
Принцип разделения: Для некоторых блокирующих операторов (операторов, которым нужно собрать все данные до начала вычислений) часть, принимающая данные, выделяется в Sink, а часть, извлекающая данные из этого оператора, называется Source.
Параллелизация сканирования
Сканирование данных представляет собой очень ресурсоёмкую операцию IO. При этом требуется читать большие объёмы данных с локального диска (в сценариях с озером данных приходится читать данные из HDFS или S3, где задержка ещё выше). Для повышения эффективности сканирования Doris использует в ScanOperator технологию параллельного сканирования:
- ScanOperator динамически создаёт несколько Scanner.
- Каждый Scanner сканирует примерно от 1 миллиона до 2 миллионов строк данных.
- Во время сканирования каждый Scanner выполняет соответствующие задачи распаковки данных, фильтрации и других вычислений.
- Scanner отправляет данные в DataQueue, откуда их читает ScanOperator.
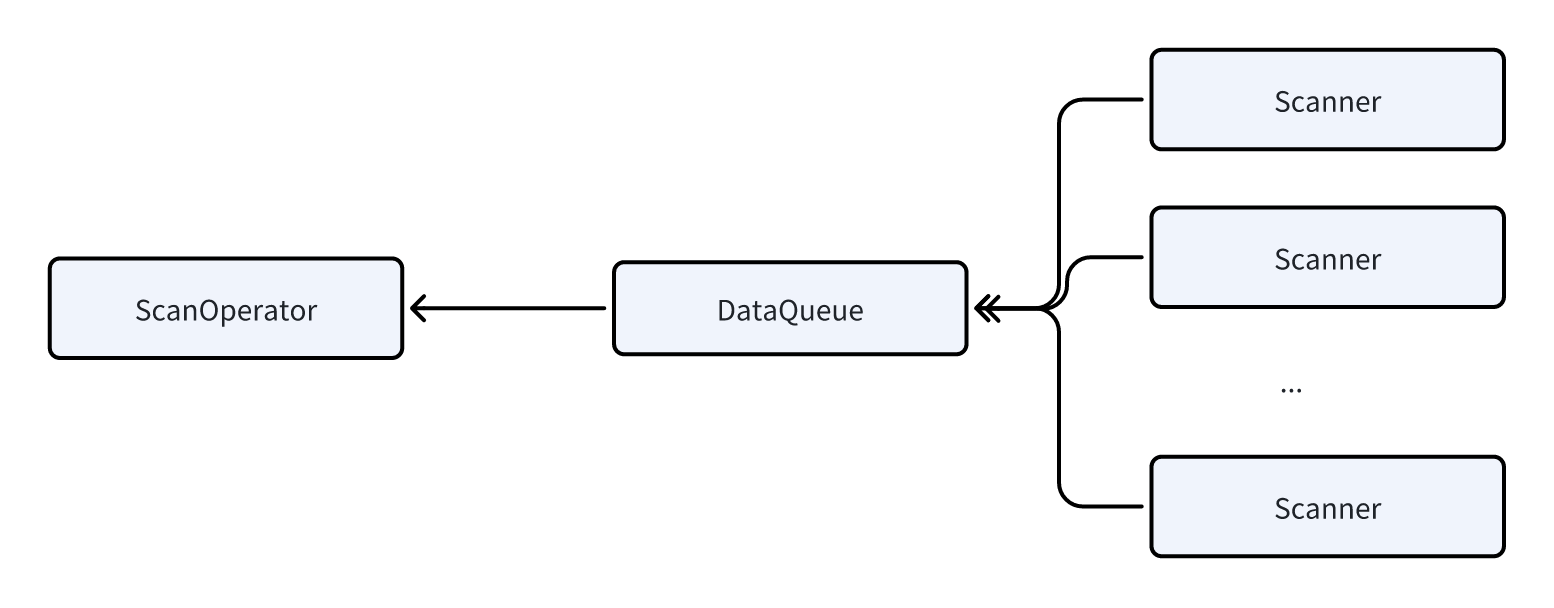
Преимущество: Параллельное сканирование эффективно предотвращает ситуацию, когда отдельные ScanOperator выполняются слишком долго из-за нерационального распределения по бакетам или перекоса данных, что увеличивает задержку выполнения всего запроса.
Local Shuffle
В модели выполнения Pipeline механизм Local Exchange выступает в роли Pipeline Breaker. Он локально перераспределяет данные между всеми задачами выполнения.
Он решает следующие задачи:
- Равномерно распределяет все выходные данные вышестоящего Pipeline между всеми Task нижестоящего Pipeline заданным способом (HASH или Round Robin).
- Устраняет перекос данных во время выполнения.
- Избавляет модель выполнения от ограничений, связанных с хранением данных и планом.
Пример работы
На примере Pipeline-1 из предыдущего раздела ниже показано, как Local Exchange позволяет избежать перекоса данных.
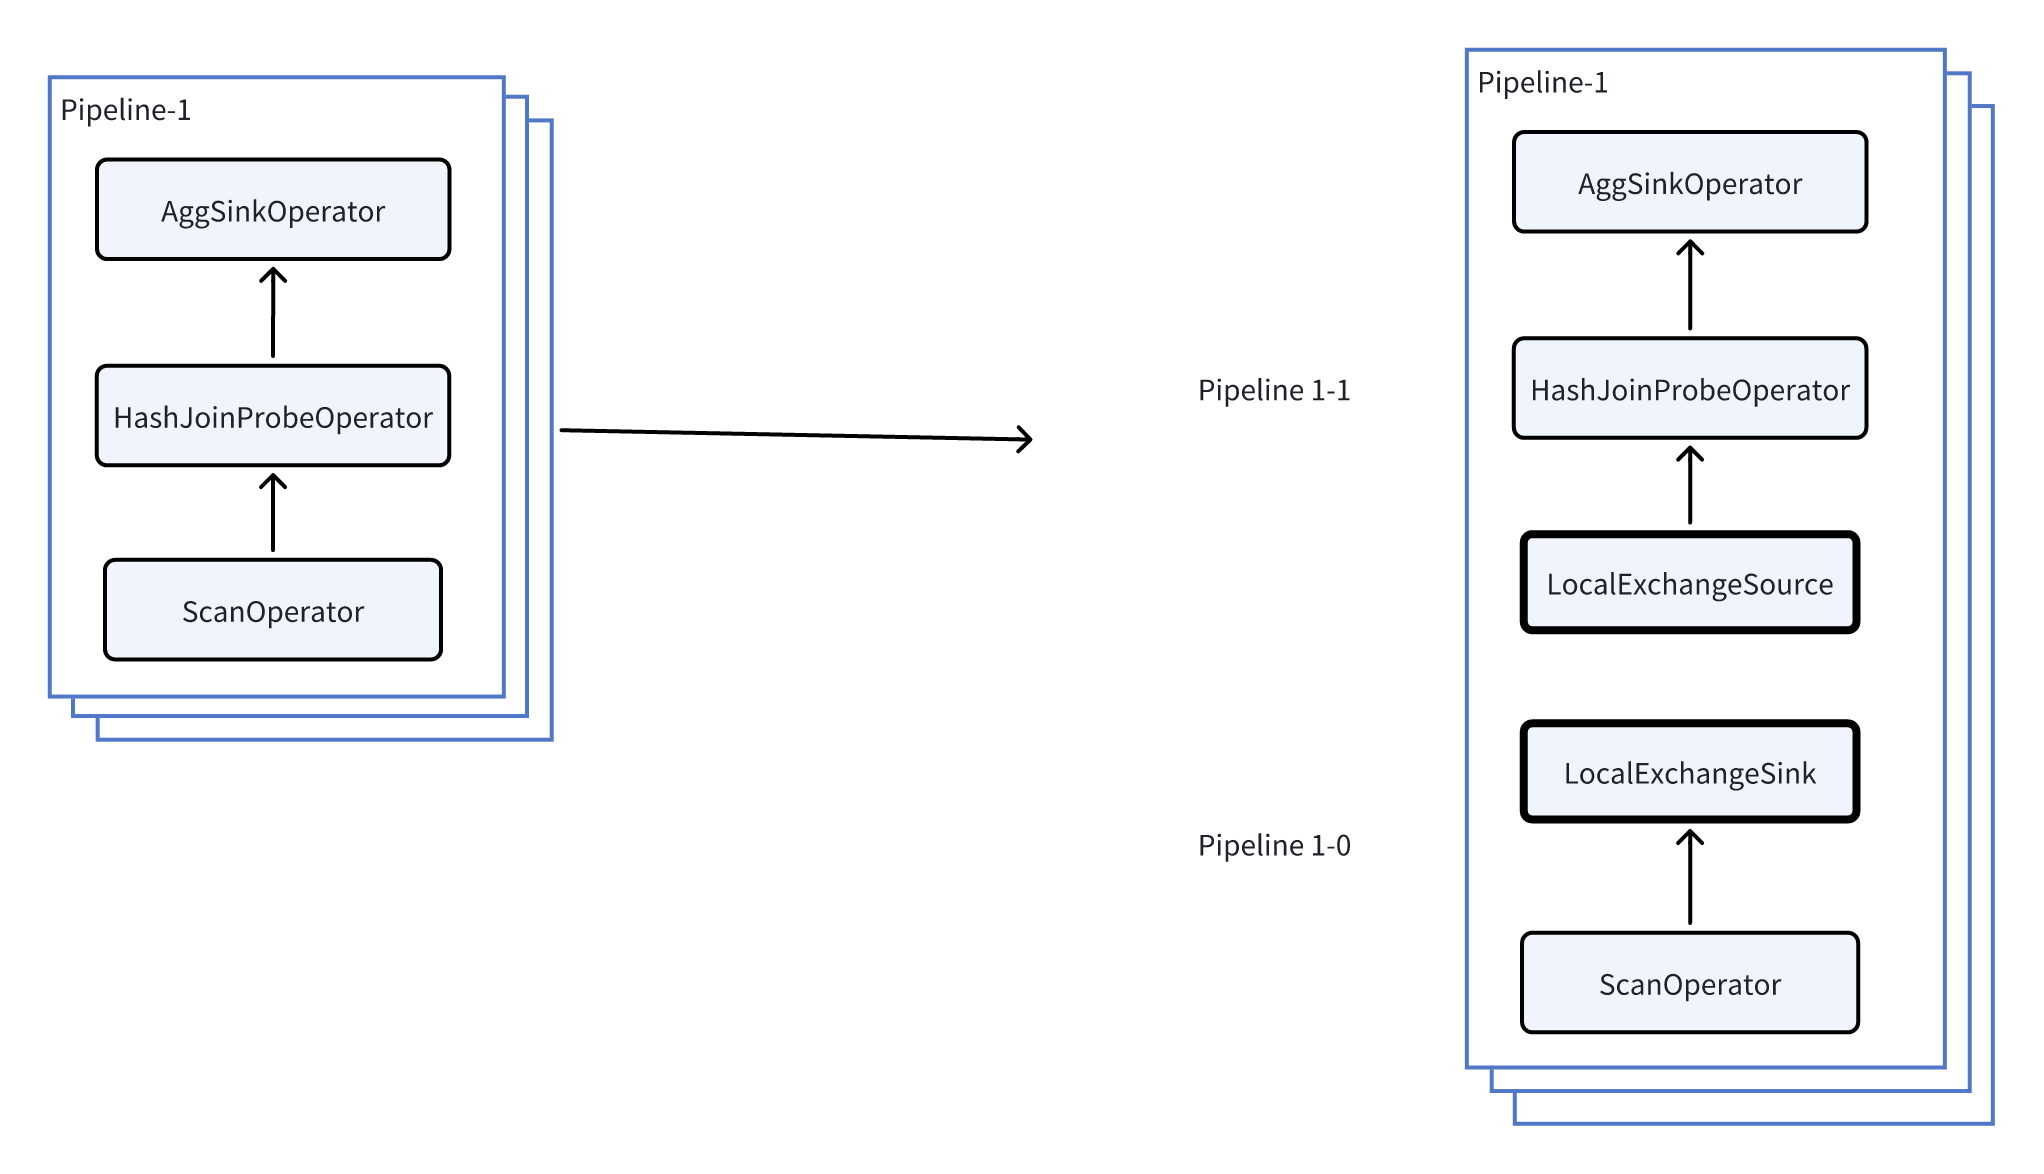
Как показано на рисунке выше, после добавления Local Exchange в Pipeline 1 этот Pipeline 1 дополнительно разбивается на:
- Pipeline 1-0
- Pipeline 1-1
Предположим, что текущая степень параллелизма равна 3 (в каждом Pipeline есть 3 задачи), каждая задача читает один бакет с уровня хранения, а количество строк в 3 бакетах составляет 1, 1 и 7 соответственно. Изменения в выполнении до и после добавления Local Exchange показаны ниже:
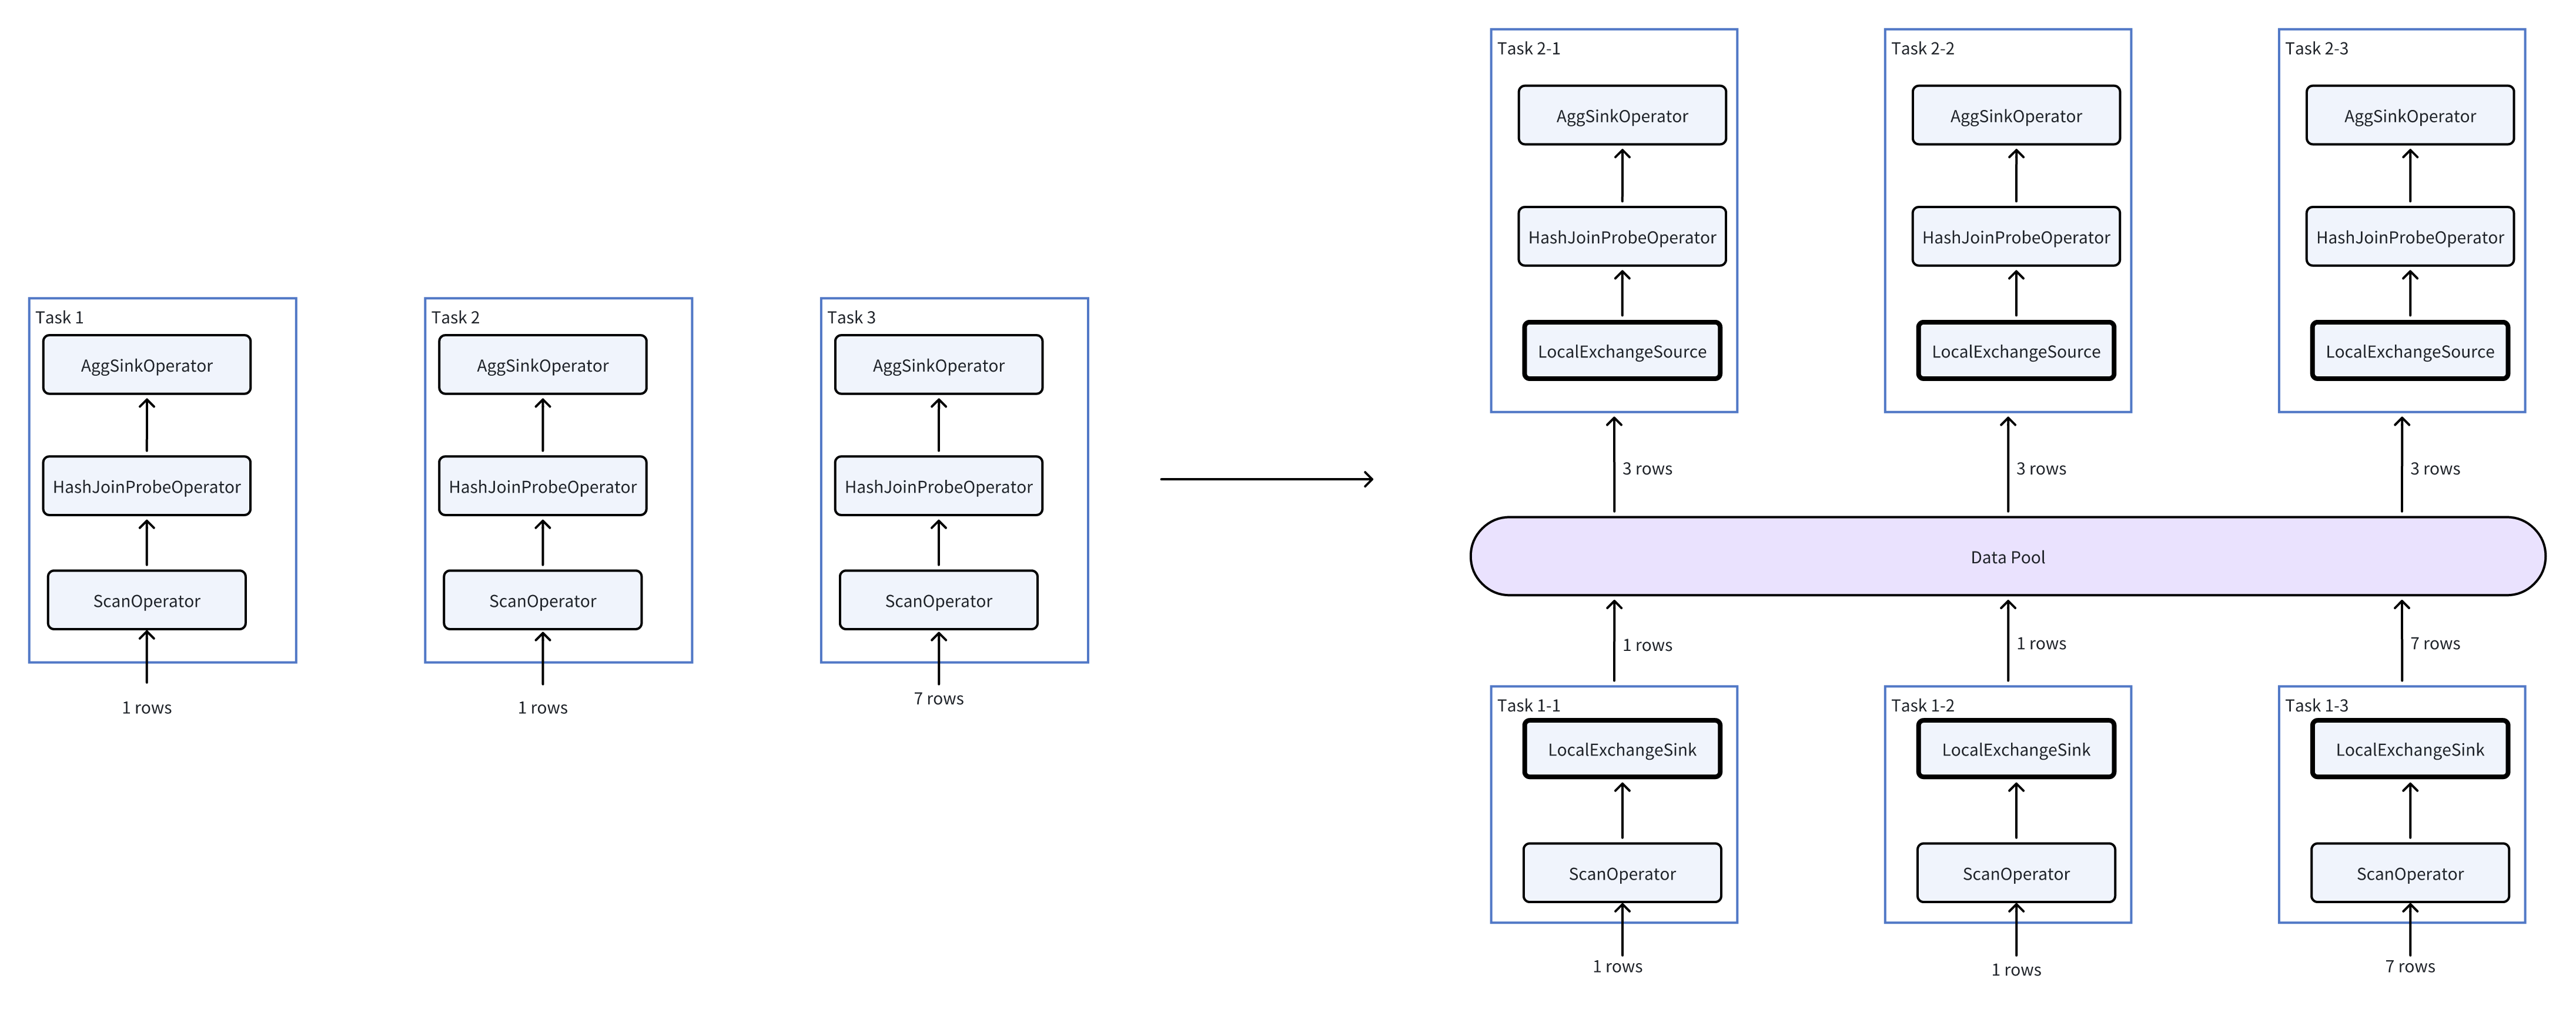
Как показано в правой части рисунка, объём данных, обрабатываемых операторами HashJoin и Agg, меняется с (1, 1, 7) на (3, 3, 3), что позволяет избежать перекоса данных.
Правила планирования
В Doris решение о включении Local Exchange в план определяется набором правил. Например, если запрос содержит трудоёмкие операторы, такие как Join, агрегация или оконные функции, Local Exchange используется, чтобы по возможности избежать перекоса данных.