Принципы работы и настройка Runtime Filter
Runtime Filter представляет собой условие фильтрации, которое Doris динамически формирует на основе данных во время выполнения запроса, чтобы сократить объём сканируемых данных и сетевой передачи. Doris поддерживает два типа Runtime Filter: Join Runtime Filter (JRF) и TopN Runtime Filter.
Что нужно знать перед чтением
- Понимаете ли вы, как выполняется Join в Doris и как работает узел Scan.
- Различаете ли вы режимы выполнения Hash Join и Shuffle Join.
- Знакомы ли вы со способами просмотра
EXPLAIN,EXPLAIN SHAPE PLANи Profile. - Можете ли вы определить, относится ли целевой сценарий к фильтрации Join или к раннему отсечению данных TopN.
Join Runtime Filter
Join Runtime Filter (далее JRF) представляет собой метод оптимизации во время выполнения: в узле Join Doris динамически формирует фильтр на основе данных правой таблицы и проталкивает его в Scan левой таблицы, чтобы уменьшить объём Probe, IO и сетевой передачи.
Принципы работы
Ниже работа JRF показана на примере Join со схемой, похожей на TPC-H.
Предположим, в базе данных есть две таблицы:
- Таблица заказов (orders): 100 миллионов строк, содержащих номер заказа
o_orderkey, идентификатор клиентаo_custkeyи другие данные. - Таблица клиентов (customer): 100,000 строк, содержащих идентификатор клиента
c_custkey, страну клиентаc_nationи другие данные; всего представлено 25 стран, примерно по 4,000 клиентов из каждой страны.
Подсчитаем количество заказов клиентов из Китая:
select count(*)
from orders join customer on o_custkey = c_custkey
where c_nation = "china"
Основу плана выполнения составляет Join:
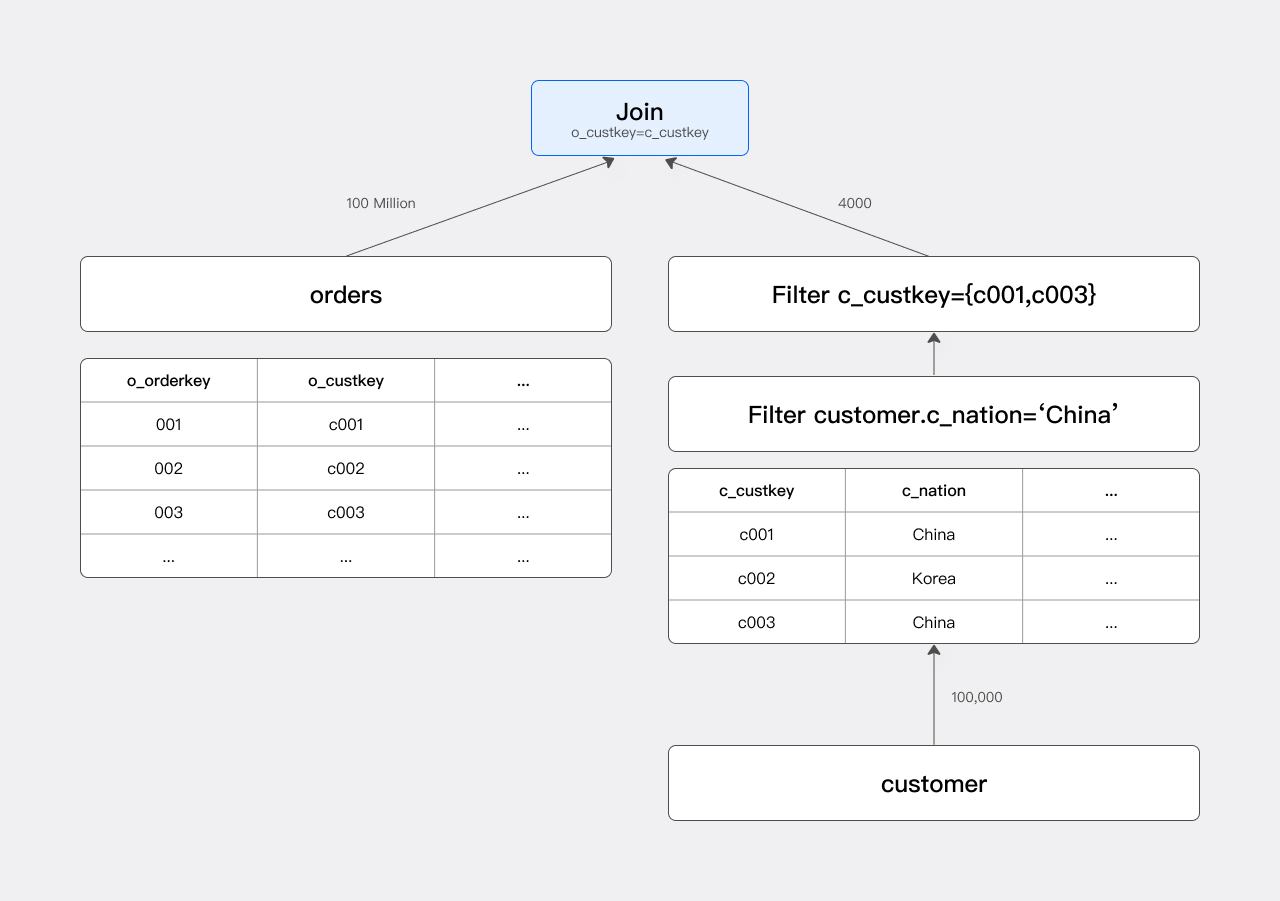
Без JRF узел Scan сканирует все 100 миллионов строк таблицы orders, а узел Join выполняет для них Hash Probe, чтобы получить результат.
1. Идея оптимизации
Условие фильтрации c_nation = "china" исключает всех клиентов, кроме китайских, поэтому в Join участвует лишь часть таблицы customer (примерно 1/25). Условие Join имеет вид o_custkey = c_custkey, поэтому нас интересует только множество значений c_custkey, прошедших фильтрацию. Обозначим его как множество A.
Множество A представляет собой именно множество значений
c_custkey, участвующих в Join.
Если протолкнуть множество A в таблицу orders в виде условия IN, узел Scan сможет предварительно отфильтровать заказы. Это равносильно добавлению c_custkey in (c001, c003):
select count(*)
from orders join customer on o_custkey = c_custkey
where c_nation = "china" and o_custkey in (c001, c003)
Оптимизированный план выполнения:
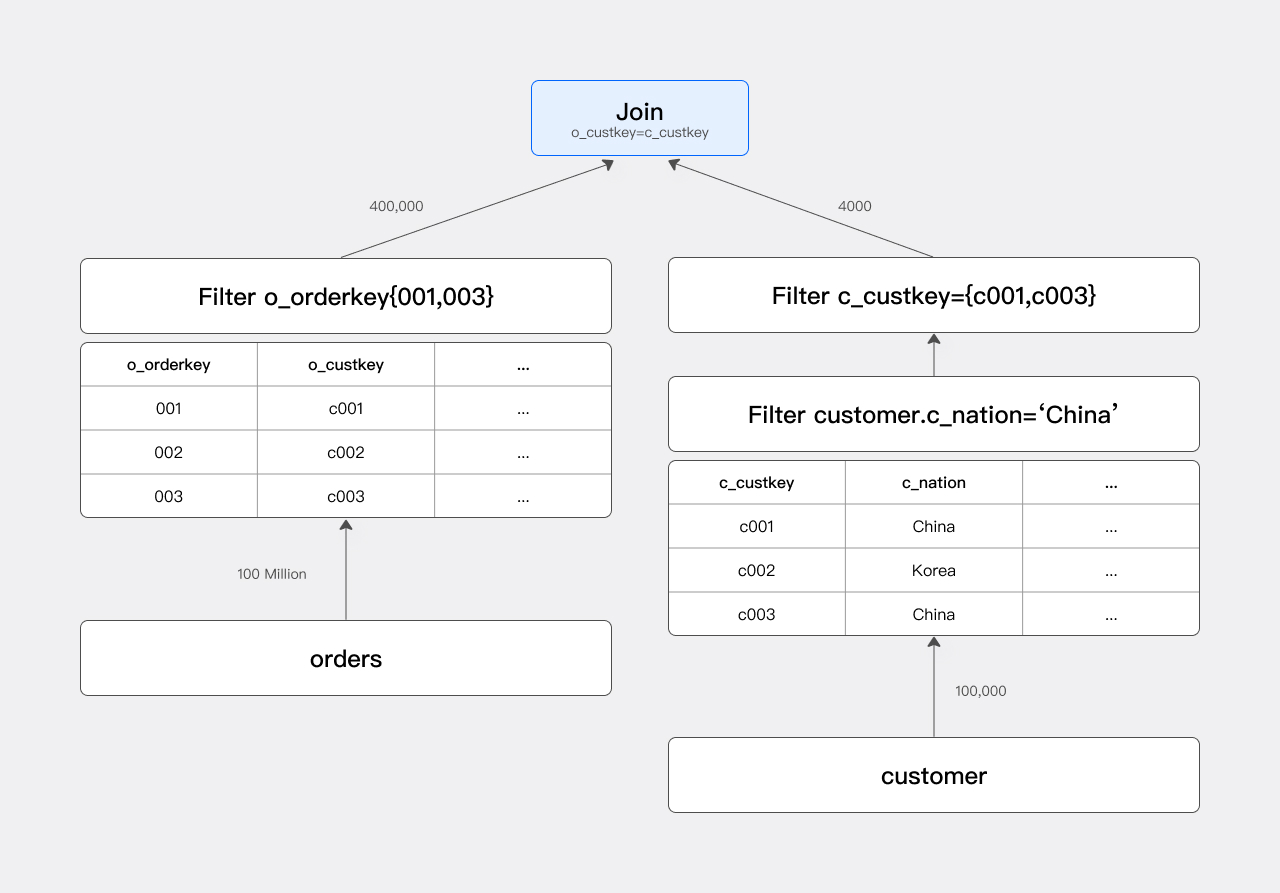
Количество строк orders, участвующих в Join, сокращается со 100 миллионов до 400,000, что значительно ускоряет запрос.
2. Способ реализации
При статическом анализе оптимизатор не может знать содержимое множества A, поэтому Doris формирует множество A во время выполнения, после сбора данных правой стороны в узле Join, и проталкивает его в узел Scan таблицы orders. Такой JRF обычно обозначается следующим образом: RF(c_custkey -> [o_custkey]).
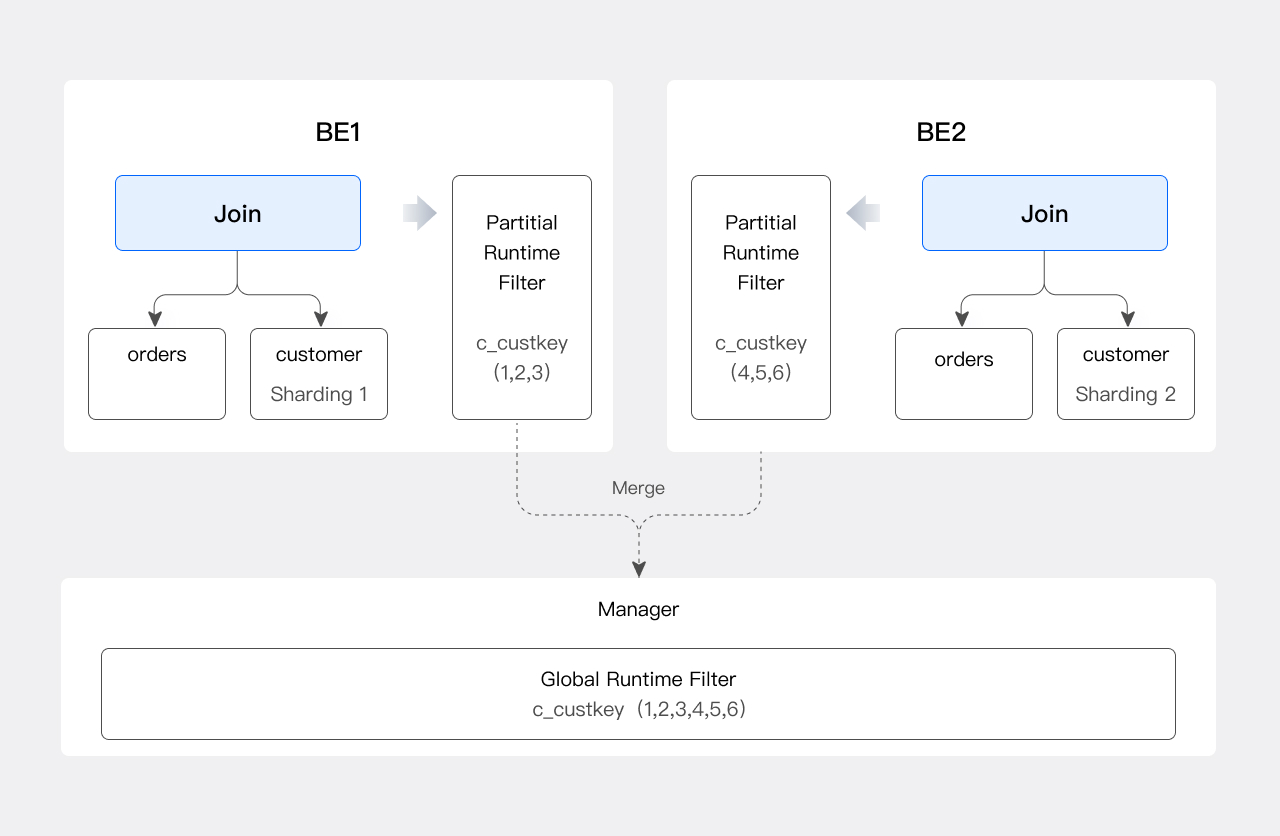
Поскольку Doris является распределённой базой данных, для JRF также требуется этап слияния:
| Шаг | Участник | Действие |
|---|---|---|
| 1 | Каждый экземпляр Join | Формирует Partial JRF на основе c_custkey локального шарда |
| 2 | Runtime Filter Manager (выбранный узел) | Собирает все Partial JRF |
| 3 | Менеджер | Объединяет их в Global JRF |
| 4 | Менеджер | Рассылает Global JRF экземплярам Scan таблицы orders |
Процесс формирования Global JRF:
Типы фильтров
У JRF есть несколько реализаций, различающихся затратами на формирование, слияние, передачу и применение.
| Тип | Сценарии применения | Точность фильтрации | Затраты |
|---|---|---|---|
| In Filter | Join по равенству с небольшим количеством элементов в множестве A | Точная | Высокие затраты на дедупликацию, передачу и Probe при большом количестве элементов |
| Bloom Filter | Join по равенству с большим количеством элементов в множестве A | Приближённая (возможны хеш-коллизии) | Средние, зависят от количества хеш-корзин |
| Min-Max Filter | Отсортированные данные или Join по неравенству | Приближённая | Наименьшие |
1. In Filter
Самая простая реализация JRF. В предыдущем примере движок выполнения формирует для левой таблицы предикат o_custkey in (...list of elements in A...), который используется для фильтрации. Это эффективно, когда множество A невелико.
При большом множестве A у In Filter возникают проблемы с производительностью:
- Высокие затраты на формирование: при слиянии значения
c_custkey, собранные с каждого шарда, необходимо дедуплицировать (еслиc_custkeyне является первичным ключом, повторяющихся значений будет много), что занимает значительное время. - Высокие затраты на передачу: передача большого количества элементов между узлом Join и узлом Scan требует значительных ресурсов.
- Высокие затраты на выполнение: само выполнение предиката IN в узле Scan занимает значительное время.
Для решения этой проблемы в Doris используется Bloom Filter.
2. Bloom Filter
Bloom Filter можно представить как группу наложенных друг на друга хеш-таблиц. Его фильтрация основана на следующем свойстве:
- Из множества A формируется хеш-таблица T; если элемента нет в T, его точно нет в A; обратное утверждение неверно.
- Поэтому для значения
o_orderkey, отсеянного Bloom Filter, на правой стороне Join заведомо нет равного значенияc_custkey; однако из-за хеш-коллизий некоторые не имеющие совпадений значенияo_custkeyтоже могут пройти фильтрацию. - Количество хеш-корзин определяет точность фильтрации: чем больше корзин, тем выше точность, но тем выше и затраты на формирование, передачу и вычисления.
При выборе размера Bloom Filter необходимо соблюдать баланс между эффективностью фильтрации и затратами. Максимальное и минимальное значения можно ограничить следующими параметрами:
| Параметр | Описание |
|---|---|
RUNTIME_BLOOM_FILTER_MIN_SIZE | Минимальный размер Bloom Filter в байтах |
RUNTIME_BLOOM_FILTER_MAX_SIZE | Максимальный размер Bloom Filter в байтах |
3. Min/Max Filter
Min-Max Filter также используется для приближённой фильтрации. Он хорошо работает, когда данные в столбце отсортированы, а затраты на его формирование, слияние и применение значительно ниже, чем у In Filter и Bloom Filter.
Для Join по неравенству ни In Filter, ни Bloom Filter не подходят, но Min-Max Filter по-прежнему эффективен:
select count(*)
from orders join customer on o_custkey > c_custkey
where c_name = "China"
Он может выбрать максимальное значение c_custkey после фильтрации, обозначить его как n и передать в узел Scan таблицы orders; узел Scan будет выдавать только строки, для которых o_custkey > n.
Проверка Join Runtime Filter
Проверить JRF можно следующими тремя способами:
| Способ | Команда | Описание |
|---|---|---|
| Текстовый план выполнения | EXPLAIN | Просмотр формирования на стороне Join и применения на стороне Scan |
| План выполнения в формате Shape | EXPLAIN SHAPE PLAN | Просмотр RF, запланированного Nereids Planner |
| Profile фактического выполнения | Выполнить запрос после SET enable_profile=true | Просмотр фактического количества отфильтрованных строк и состояния |
Следующий пример основан на схеме TPC-H:
select count(*) from orders join customer on o_custkey=c_custkey;
1. EXPLAIN
Информация о JRF распределена между узлом Join и узлом Scan:
4: VHASH JOIN(258)
| join op: INNER JOIN(PARTITIONED)[]
|  equal join conjunct: (o_custkey[#10] = c_custkey[#0])
|  runtime filters: RF000[bloom] <- c_custkey[#0] (150000000/134217728/16777216)
|  cardinality=1,500,000,000
|  vec output tuple id: 3
|  output tuple id: 3
|  vIntermediate tuple ids: 2
|  hash output slot ids: 10
|  final projections: o_custkey[#17]
|  final project output tuple id: 3
|  distribute expr lists: o_custkey[#10]
|  distribute expr lists: c_custkey[#0]
|
|---1: VEXCHANGE
|      offset: 0
|      distribute expr lists: c_custkey[#0]
3: VEXCHANGE
|  offset: 0
|  distribute expr lists:

PLAN FRAGMENT 2
| PARTITION: HASH_PARTITIONED: o_orderkey[#8]
| HAS_COLO_PLAN_NODE: false
| STREAM DATA SINK
|   EXCHANGE ID: 03
|   HASH_PARTITIONED: o_custkey[#10]

2: VOlapScanNode(242)
|  TABLE: regression_test_nereids_tpch_shape_sf1000_p0.orders(orders)
|  PREAGGREGATION: ON
|  runtime filters: RF000[bloom] -> o_custkey[#10]
|  partitions=1/1 (orders)
|  tablets=96/96, tabletList=54990,54992,54994 ...
|  cardinality=0, avgRowSize=0.0, numNodes=1
|  pushAggOp=NONE
Описание ключевых полей:
- Сторона Join:
runtime filters: RF000[bloom] <- c_custkey[#0] (150000000/134217728/16777216)Это означает, что формируется Bloom Filter с номером 000, принимающий полеc_custkeyв качестве входных данных. Три числа в скобках относятся к расчёту размера Bloom Filter; пока их можно не учитывать. - Сторона Scan:
runtime filters: RF000[bloom] -> o_custkey[#10]Это означает, что RF000 применяется к узлу Scan таблицы orders и выполняет фильтрацию по полюo_custkey.
2. EXPLAIN SHAPE PLAN
mysql> explain shape plan select count(*) from orders join customer on o_custkey=c_custkey where c_nationkey=5;
+--------------------------------------------------------------------------------------------------------------------------+
Explain String(Nereids Planner)                                                                                            |
+--------------------------------------------------------------------------------------------------------------------------+
PhysicalResultSink                                                                                                         |
--hashAgg[GLOBAL]                                                                                                          |
----PhysicalDistribute[DistributionSpecGather]                                                                             |
------hashAgg[LOCAL]                                                                                                       |
--------PhysicalProject                                                                                                    |
----------hashJoin[INNER_JOIN shuffle]                                                                                     |
------------hashCondition=((orders.o_custkey=customer.c_custkey)) otherCondition=() buildRFs:RF0 c_custkey->[o_custkey]    |
--------------PhysicalProject                                                                                              |
----------------Physical0lapScan[orders] apply RFs: RF0                                                                    |
--------------PhysicalProject                                                                                              |
----------------filter((customer.c_nationkey=5))                                                                           |
------------------Physical0lapScan[customer]                                                                               |
+--------------------------------------------------------------------------------------------------------------------------+
11 rows in set (0.02 sec)
Ключевые поля:
- Сторона Join:
buildRFs: RF0 c_custkey -> [o_custkey]означает, что формируется JRF с номером 0, который принимаетc_custkeyв качестве входных данных и применяется кo_custkey. - Сторона Scan:
PhysicalOlapScan[orders] apply RFs: RF0означает, что таблица orders фильтруется с помощью RF0.
3. Profile
Во время выполнения BE записывает сведения об использовании JRF в Profile (требуется set enable_profile=true).
Profile на стороне Join:
HASH_JOIN_SINK_OPERATOR  (id=3  ,  nereids_id=367):(ExecTime:  703.905us)
    -  JoinType:  INNER_JOIN
    ...
    -  BuildRows:  617
    ...
    -  RuntimeFilterComputeTime:  70.741us
    -  RuntimeFilterInitTime:  10.882us
В этом примере формирование JRF занимает 70.741us при 617 входных строках; размер и тип JRF показаны на стороне Scan.
Profile на стороне Scan:
OLAP_SCAN_OPERATOR  (id=2.  nereids_id=351.  table  name  =  orders(orders)):(ExecTime:  13.32ms)
              -  RuntimeFilters:  :  RuntimeFilter:  (id  =  0,  type  =  bloomfilter,  need_local_merge:  false,  is_broadcast:  true,  build_bf_cardinality:  false,
              ...
              -  RuntimeFilterInfo:
                  -  filter  id  =  0  filtered:  714.761K  (714761)
                  -  filter  id  =  0  input:  747.862K  (747862)
              ...
              -  WaitForRuntimeFilter:  6.317ms
            RuntimeFilter:  (id  =  0,  type  =  bloomfilter):
                  -  Info:  [IsPushDown  =  true,  RuntimeFilterState  =  READY,  HasRemoteTarget  =  false,  HasLocalTarget  =  true,  Ignored  =  false]
                  -  RealRuntimeFilterType:  bloomfilter
                  -  BloomFilterSize:  1024
Обратите внимание на следующие сведения:
| Что проверить | Поле | Значение |
|---|---|---|
| Эффективность фильтрации | filter id = 0 filtered / input | Чем больше значение Filtered, тем эффективнее фильтрация |
| Проталкивание на уровень хранения | IsPushDown = true | После проталкивания может задействоваться отложенная материализация, что сокращает IO |
| Применение фильтра | RuntimeFilterState = READY | Состояние, отличное от READY, означает, что Scan не дождался JRF |
| Размер фильтра | BloomFilterSize: 1024 | Размер Bloom Filter в байтах |
Настройка
В подавляющем большинстве случаев JRF адаптируется автоматически и не требует ручной настройки. Если настройка всё же необходима, можно использовать следующие переменные сессии:
| Переменная | Значение по умолчанию | Назначение |
|---|---|---|
runtime_filter_mode | GLOBAL | Включение JRF (GLOBAL включает / OFF отключает) |
runtime_filter_type | По умолчанию 12 в версии 2.1 | Задаёт сумму значений перечисления типов JRF |
runtime_filter_wait_time_ms | 1000 | Максимальное время ожидания JRF узлом Scan в миллисекундах |
enable_runtime_filter_prune | true | Отсекать ли JRF с низкой селективностью |
runtime_filter_broadcast_join_producer_num | 3 | Максимальное количество BE, формирующих каждый JRF при Broadcast Join. Значение меньше или равное 0 означает отсутствие ограничения. Поддерживается начиная с версии 4.1.4 |
runtime_filter_tree_publish_max_send_bytes | 268435456 (256 MB) | Максимальное количество байтов, передаваемых за один RPC при публикации глобального JRF. При превышении этого порога используется древовидная (многоуровневая) публикация, чтобы узел слияния не отправлял один и тот же большой фильтр каждому узлу Scan. Значение 0 отключает древовидную публикацию и возвращает прямую публикацию; значение должно быть больше или равно 0. Поддерживается начиная с версии 4.1.4 |
runtime_filter_broadcast_join_producer_num: при Broadcast Join каждый BE на стороне Build формирует и отправляет JRF с одинаковым содержимым. Эта переменная ограничивает количество BE, которые фактически его формируют (по умолчанию 3), что заметно сокращает накладные расходы на RPC в больших кластерах. Она действует только в ветке распределённого планировщика Nereids; в устаревшей ветке Coordinator сохраняется исходное поведение.runtime_filter_tree_publish_max_send_bytes: раньше большой глобальный JRF публиковался напрямую с узла слияния на каждый узел Scan, что приводило к повторной передаче больших вложений RPC. При древовидной публикации фильтр пересылается последовательно по уровням, что снижает нагрузку на пропускную способность отдельного узла.
1. Включение и отключение JRF
- Включить:
set runtime_filter_mode = GLOBAL - Отключить:
set runtime_filter_mode = OFF
2. Выбор типов JRF
runtime_filter_type задаёт значения перечисления типов JRF, которые можно объединять (суммировать), чтобы одновременно формировать несколько типов:
| Тип | Значение перечисления |
|---|---|
IN | 1 |
BLOOM | 2 |
MIN_MAX | 4 |
IN_OR_BLOOM | 8 |
IN_OR_BLOOM позволяет BE адаптивно выбирать IN или BLOOM в зависимости от фактического количества строк. Например:
set runtime_filter_type = 6: одновременно формирует BLOOM и MIN_MAX.- Значение по умолчанию 12 (4 + 8) в версии 2.1: одновременно формирует MIN_MAX и IN_OR_BLOOM.
3. Настройка времени ожидания
JRF использует механизм Try-best: перед началом работы Scan ожидает JRF; Doris автоматически оценивает время ожидания. В некоторых случаях недостаточное время ожидания приводит к тому, что JRF не применяется и Scan выдаёт больше строк, чем ожидалось.
Как это определить: в Profile у узла Scan указано RuntimeFilterState = NOT_READY.
Порядок настройки:
- Цель: увеличить время ожидания JRF узлом Scan.
- Команда:
set runtime_filter_wait_time_ms = <milliseconds> - Описание: по умолчанию 1000 миллисекунд.
4. Отсечение JRF
В некоторых сценариях JRF имеет низкую селективность. Например, если orders и customer связаны первичным и внешним ключами, а для customer нет условия фильтрации, на вход JRF поступают все значения custkey, что не позволяет отфильтровать строки orders. Оптимизатор оценивает эффективность на основе статистики столбцов и выполняет соответствующее отсечение.
- Цель: включить или отключить отсечение JRF.
- Команда:
set enable_runtime_filter_prune = true|false - Описание: по умолчанию
true.
TopN Runtime Filter
TopN Runtime Filter динамически формирует фильтр на основе текущего значения на вершине кучи при выполнении оператора topN, заранее отсекая данные Scan.
Принципы работы
Doris обрабатывает данные блоками в потоковом режиме. Если SQL содержит topN, Doris не вычисляет все результаты, а формирует динамический фильтр для предварительной фильтрации данных.
Пример:
select o_orderkey from orders order by o_orderdate limit 5;
План выполнения выглядит следующим образом:
mysql> explain select o_orderkey from orders order by o_orderdate limit 5;
+-----------------------------------------------------+
| Explain String(Nereids Planner)                     |
+-----------------------------------------------------+
| PLAN FRAGMENT 0                                     |
|   OUTPUT EXPRS:                                     |
|     o_orderkey[#11]                                 |
|   PARTITION: UNPARTITIONED                          |
|                                                     |
|   HAS_COLO_PLAN_NODE: false                         |
|                                                     |
|   VRESULT SINK                                      |
|      MYSQL_PROTOCAL                                 |
|                                                     |
|   2:VMERGING-EXCHANGE                               |
|      offset: 0                                      |
|      limit: 5                                       |
|      final projections: o_orderkey[#9]              |
|      final project output tuple id: 2               |
|      distribute expr lists:                         |
|                                                     |
| PLAN FRAGMENT 1                                     |
|                                                     |
|   PARTITION: HASH_PARTITIONED: O_ORDERKEY[#0]       |
|                                                     |
|   HAS_COLO_PLAN_NODE: false                         |
|                                                     |
|   STREAM DATA SINK                                  |
|     EXCHANGE ID: 02                                 |
|     UNPARTITIONED                                   |
|                                                     |
|   1:VTOP-N(119)                                     |
|   |  order by: o_orderdate[#10] ASC                 |
|   |  TOPN OPT                                       |
|   |  offset: 0                                      |
|   |  limit: 5                                       |
|   |  distribute expr lists: O_ORDERKEY[#0]          |
|   |                                                 |
|   0:VOlapScanNode(113)                              |
|      TABLE: tpch.orders(orders), PREAGGREGATION: ON |
|      TOPN OPT:1                                     |
|      partitions=1/1 (orders)                        |
|      tablets=3/3, tabletList=135112,135114,135116   |
|      cardinality=150000, avgRowSize=0.0, numNodes=1 |
|      pushAggOp=NONE                                 |
+-----------------------------------------------------+
41 rows in set (0.06 sec)
Процесс выполнения:
- Без TopN Filter узел Scan последовательно читает блоки данных и передаёт их в TopN, который с помощью пирамидальной сортировки поддерживает текущие 5 лучших значений.
- Блок данных Block содержит примерно 1024 строки; после обработки первого Block становится известно значение на 5-м месте в этом Block.
- Предположим, это значение
1995-01-01. Когда Scan выдаёт второй Block, строки сo_orderdate > 1995-01-01больше не нужно передавать в TopN. - Порог обновляется динамически: если последующие Block содержат меньшее значение
o_orderdate, TopN обновляет порог.
Проверка TopN Runtime Filter
Используйте EXPLAIN, чтобы просмотреть TopN Runtime Filter, запланированный оптимизатором:
1:VTOP-N(119)
| order by: o_orderdate[#10] ASC
| TOPN OPT
| offset: 0
| limit: 5
| distribute expr lists: O_ORDERKEY[#0]
|

0:VLapScanNode[113]
    TABLE: regression_test_nereids_tpch_p0.(orders), PREAGGREGATION: ON
    TOPN OPT: 1
    partitions=1/1 (orders)
    tablets=3/3, tabletList=135112,135114,135116
    cardinality=150000, avgRowSize=0.0, numNodes=1
    pushAggOp: NONE
Ключевые поля:
- Узел TopN: содержит
TOPN OPT, что указывает на формирование TopN Runtime Filter этим узлом TopN. - Узел Scan: указывает, какой узел TopN сформировал используемый TopN Runtime Filter. Например,
TOPN OPT: 1означает, что Scan таблицы orders использует Runtime Filter, сформированный узлом TopN с номером 1.
Будучи распределённой базой данных, Doris также учитывает физическое расположение TopN и Scan. Обмен данными между BE требует значительных ресурсов, поэтому BE адаптивно решает, включать ли фильтр и какой должна быть область его действия. В текущей реализации TopN Runtime Filter работает на уровне BE (TopN и Scan находятся в одном BE), используя только взаимодействие между потоками с низкими накладными расходами.
Настройка
Чем меньше limit, тем сильнее фильтрация TopN Runtime Filter. По умолчанию система включает его только тогда, когда limit меньше половины объёма данных таблицы.
| Переменная | Назначение |
|---|---|
topn_filter_ratio | Определяет, будет ли формироваться TopN Runtime Filter |
Например, после настройки set topn_filter_ratio=0 следующий запрос не формирует TopN Runtime Filter:
select o_orderkey from orders order by o_orderdate limit 20;
Сравнение типов Runtime Filter
| Критерий | Join Runtime Filter | TopN Runtime Filter |
|---|---|---|
| Сценарий применения | Запросы с Join | Запросы с ORDER BY ... LIMIT |
| Место формирования | Узел Join | Узел TopN |
| Цель проталкивания | Scan левой таблицы | Scan в том же BE |
| Работа между BE | Поддерживается (слияние Global JRF) | Не поддерживается (только внутри BE) |
| Адаптивность | Да | Да |
Частые вопросы и устранение неполадок
Вопрос 1: JRF не применяется, и Scan выдаёт значительно больше строк, чем ожидалось. Что делать?
Проверьте RuntimeFilterState в Profile: если значение отличается от READY, время ожидания у Scan истекло. Можно увеличить runtime_filter_wait_time_ms.
Вопрос 2: JRF формируется, но количество отфильтрованных строк Filtered невелико. Почему?
Входные данные JRF могут иметь низкую селективность (например, при Join по первичному и внешнему ключам без условия фильтрации для правой таблицы). Можно оставить enable_runtime_filter_prune = true, чтобы оптимизатор автоматически выполнял отсечение, или проверить, не отсутствует ли условие фильтрации для правой таблицы.
Вопрос 3: Как одновременно сформировать несколько типов JRF?
Задайте для runtime_filter_type сумму соответствующих значений перечисления. Например, set runtime_filter_type = 6 одновременно формирует BLOOM и MIN_MAX.
Вопрос 4: Можно ли использовать JRF для Join по неравенству? Можно использовать Min-Max Filter; In Filter и Bloom Filter поддерживают только Join по равенству.
Вопрос 5: TopN Runtime Filter не формируется. Почему?
Проверьте topn_filter_ratio: если значение равно 0, фильтр не формируется. По умолчанию система формирует фильтр только тогда, когда limit меньше половины объёма данных таблицы; ослабление ограничения limit или увеличение topn_filter_ratio может привести к его формированию.
Вопрос 6: Как управлять размером Bloom Filter?
Используйте RUNTIME_BLOOM_FILTER_MIN_SIZE и RUNTIME_BLOOM_FILTER_MAX_SIZE, чтобы ограничить минимальный и максимальный размер в байтах; при этом необходимо соблюдать баланс между точностью фильтрации и затратами.