Индекс NGram BloomFilter
Индекс NGram BloomFilter представляет собой Skip Index, специально разработанный для ускорения запросов нечеткого поиска LIKE '%pattern%' по строковым столбцам. Он построен на основе индекса BloomFilter и использует токенизацию N-Gram: перед записью в BloomFilter текст разбивается на группы из соседних символов. Это обеспечивает быструю фильтрацию при нечетком поиске.
Основное преимущество: В подходящих сценариях индекс NGram BloomFilter может ускорить запросы от нескольких раз до десяти по сравнению с полным сканированием без индекса (см. пример ускорения в 8 раз в разделе Пример использования).
Принцип работы индекса
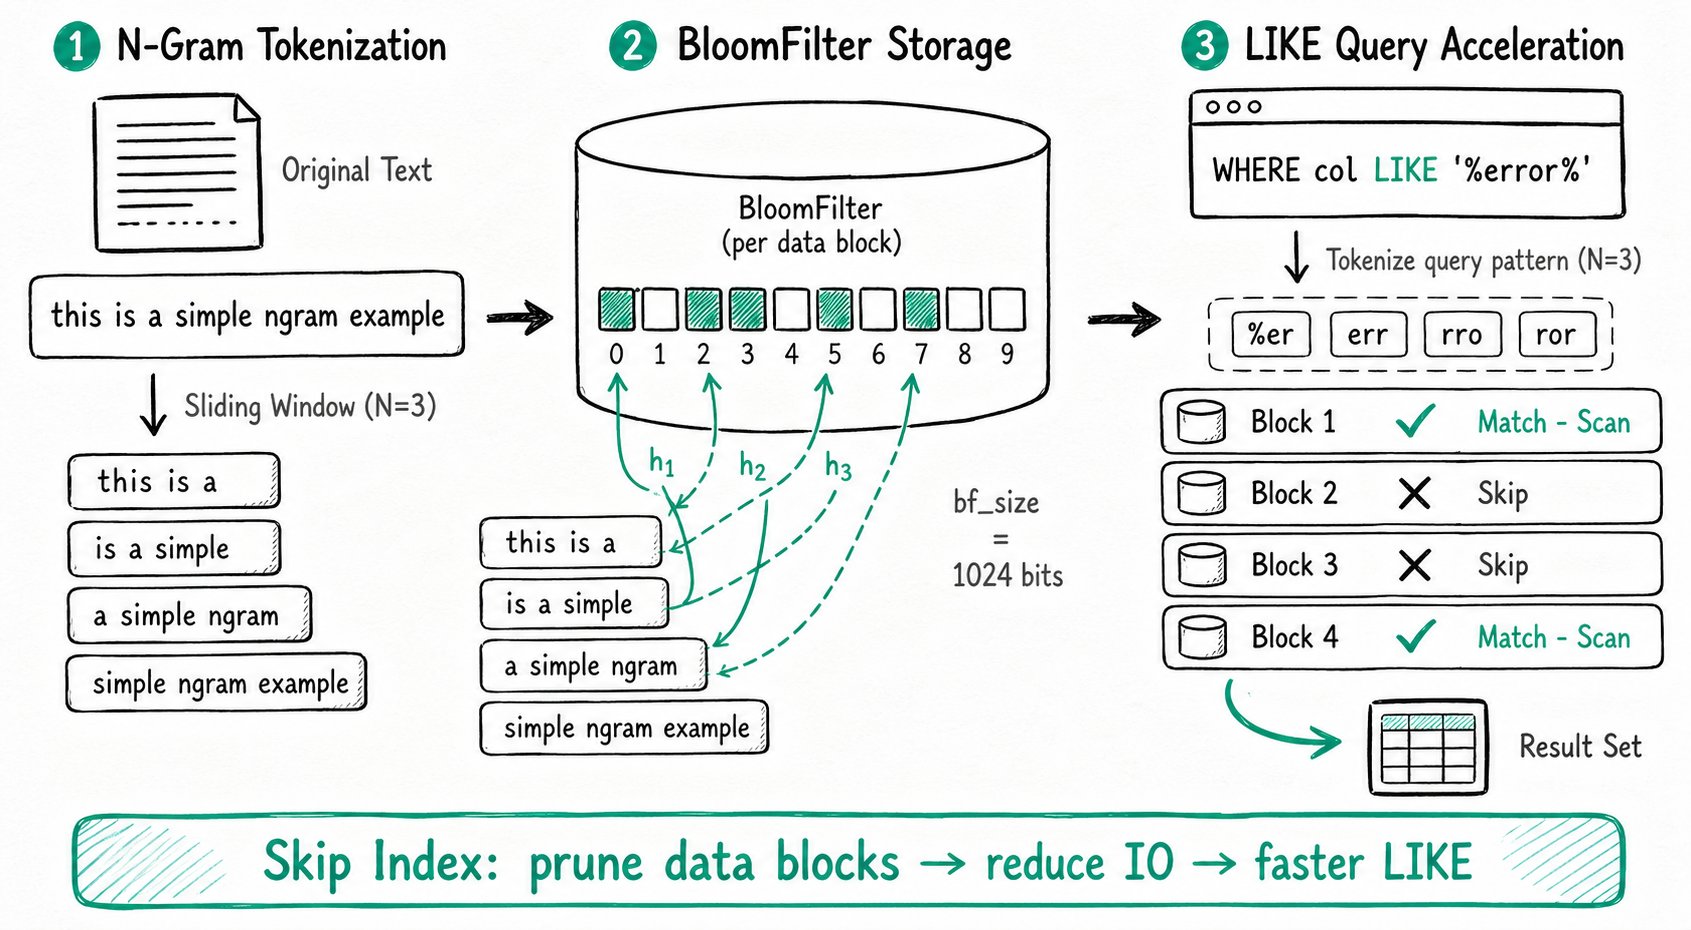
Токенизация N-Gram разбивает предложение или фрагмент текста на группы из соседних символов. Например, токенизация строки 'This is a simple ngram example' при N = 3 дает следующие 4 группы слов:
'This is a''is a simple''a simple ngram''simple ngram example'
Основные различия между индексом NGram BloomFilter и обычным индексом BloomFilter:
| Критерий сравнения | Индекс BloomFilter | Индекс NGram BloomFilter |
|---|---|---|
| Записываемое содержимое | Исходные значения столбца | Каждая группа, полученная при токенизации исходного текста методом N-Gram |
| Ускоряемые типы запросов | Запросы на равенство (=, IN) | Запросы нечеткого поиска LIKE '%pattern%' |
| Поддерживаемые типы столбцов | Различные типы данных | Только строковые столбцы |
Процесс ускорения запроса:
- К
patternв выраженииLIKE '%pattern%'применяется токенизация N-Gram. - Для каждой полученной группы последовательно проверяется ее наличие в BloomFilter.
- Если группа отсутствует в BloomFilter, соответствующий блок данных не может удовлетворять условию LIKE и его можно пропустить.
- Пропуск блоков данных, не соответствующих условию, сокращает IO и ускоряет запрос.
Сценарии использования
Индекс NGram BloomFilter подходит для следующих сценариев:
- Ускорение запросов нечеткого поиска
LIKE '%pattern%'по строковым столбцам. - Число последовательных символов в шаблоне
LIKEбольше либо равно значениюgram_size, заданному для индекса.
- Поддерживаются только строковые столбцы, а ускорение доступно только для запросов
LIKE. - Индекс NGram BloomFilter и обычный индекс BloomFilter взаимоисключающие. Для одного столбца можно выбрать только один из них.
- Эффективность индекса анализируется так же, как и для индекса BloomFilter.
Управление индексами
Создание индекса
Создание индекса при создании таблицы
Добавьте определение индекса после определения COLUMN в операторе создания таблицы:
INDEX `idx_column_name` (`column_name`) USING NGRAM_BF
PROPERTIES("gram_size"="3", "bf_size"="1024")
COMMENT 'username ngram_bf index'
Описание синтаксиса
| Параметр | Обязательность | Описание |
|---|---|---|
idx_column_name (column_name) | Обязательный | column_name — имя столбца, для которого создается индекс; столбец должен быть определен ранее. idx_column_name — имя индекса, которое должно быть уникальным в пределах таблицы |
USING NGRAM_BF | Обязательный | Задает тип индекса: NGram BloomFilter |
PROPERTIES | Необязательный | Задает дополнительные свойства индекса NGram BloomFilter. Подробности приведены в таблице ниже |
COMMENT | Необязательный | Задает комментарий к индексу |
Рекомендуется добавлять к именам индексов префикс idx_, например idx_review_body.
Параметры PROPERTIES
| Свойство | Описание |
|---|---|
gram_size | Значение N в N-Gram: каждые N последовательных символов образуют группу. Например, строка 'This is a simple ngram example' разбивается на 4 группы слов при N = 3. Рекомендуется задавать минимальную длину строки поиска в запросе LIKE, но не менее 2. |
bf_size | Размер BloomFilter в битах. Определяет размер индекса для каждого блока данных. Чем больше значение, тем больше требуется места для хранения, но тем ниже вероятность коллизий хешей. |
Рекомендуемая конфигурация: Обычно рекомендуется начать с "gram_size"="3" и "bf_size"="1024", а затем скорректировать параметры на основе Query Profile.
Просмотр индексов
-- Method 1: In the INDEX section of the table schema, USING NGRAM_BF marks an NGram BloomFilter index
SHOW CREATE TABLE table_name;

-- Method 2: An IndexType of NGRAM_BF marks an NGram BloomFilter index
SHOW INDEX FROM table_name;
Удаление индекса
ALTER TABLE table_ngrambf DROP INDEX idx_ngrambf;
Изменение индекса
Индекс NGram BloomFilter можно добавить в существующую таблицу двумя способами:
-- Method 1: Use CREATE INDEX
CREATE INDEX idx_column_name2(column_name2) ON table_ngrambf
USING NGRAM_BF
PROPERTIES("gram_size"="3", "bf_size"="1024")
COMMENT 'username ngram_bf index';

-- Method 2: Use ALTER TABLE ADD INDEX
ALTER TABLE table_ngrambf
ADD INDEX idx_column_name2(column_name2) USING NGRAM_BF
PROPERTIES("gram_size"="3", "bf_size"="1024")
COMMENT 'username ngram_bf index';
Использование индекса
Включение проталкивания функций
Перед использованием индекса NGram BloomFilter включите проталкивание функций (function pushdown; параметр enable_function_pushdown по умолчанию имеет значение false):
SET enable_function_pushdown = true;
Задействование индекса для ускорения
Индекс NGram BloomFilter автоматически используется для ускорения запросов LIKE, например:
SELECT count() FROM table1 WHERE message LIKE '%error%';
Анализ эффективности индекса
Эффект ускорения за счет индекса BloomFilter (включая NGram BloomFilter) можно оценить по следующим метрикам в Query Profile:
| Метрика | Значение |
|---|---|
RowsBloomFilterFiltered | Число строк, отфильтрованных индексом BloomFilter. Для оценки эффективности фильтрации можно сравнить его с другими метриками Rows |
BlockConditionsFilteredBloomFilterTime | Время, затраченное на работу индекса BloomFilter |
Пример использования
Ниже на примере набора данных с отзывами пользователей о товарах Amazon amazon_reviews показано, как использовать индекс NGram BloomFilter и какое ускорение он обеспечивает.
Шаг 1: Создание таблицы
CREATE TABLE `amazon_reviews` (
    `review_date` int(11) NULL,
    `marketplace` varchar(20) NULL,
    `customer_id` bigint(20) NULL,
    `review_id` varchar(40) NULL,
    `product_id` varchar(10) NULL,
    `product_parent` bigint(20) NULL,
    `product_title` varchar(500) NULL,
    `product_category` varchar(50) NULL,
    `star_rating` smallint(6) NULL,
    `helpful_votes` int(11) NULL,
    `total_votes` int(11) NULL,
    `vine` boolean NULL,
    `verified_purchase` boolean NULL,
    `review_headline` varchar(500) NULL,
    `review_body` string NULL
) ENGINE=OLAP
DUPLICATE KEY(`review_date`)
COMMENT 'OLAP'
DISTRIBUTED BY HASH(`review_date`) BUCKETS 16
PROPERTIES (
    "replication_allocation" = "tag.location.default: 1",
    "compression" = "ZSTD"
);
Шаг 2: Загрузка данных
1. Скачайте набор данных
Используйте wget или другой инструмент, чтобы скачать набор данных по следующим URL:
https://datasets-documentation.s3.eu-west-3.amazonaws.com/amazon_reviews/amazon_reviews_2010.snappy.parquet
https://datasets-documentation.s3.eu-west-3.amazonaws.com/amazon_reviews/amazon_reviews_2011.snappy.parquet
https://datasets-documentation.s3.eu-west-3.amazonaws.com/amazon_reviews/amazon_reviews_2012.snappy.parquet
https://datasets-documentation.s3.eu-west-3.amazonaws.com/amazon_reviews/amazon_reviews_2013.snappy.parquet
https://datasets-documentation.s3.eu-west-3.amazonaws.com/amazon_reviews/amazon_reviews_2014.snappy.parquet
https://datasets-documentation.s3.eu-west-3.amazonaws.com/amazon_reviews/amazon_reviews_2015.snappy.parquet
2. Загрузите данные через Stream Load
curl --location-trusted -u root: -T amazon_reviews_2010.snappy.parquet -H "format:parquet" http://127.0.0.1:8030/api/${DB}/amazon_reviews/_stream_load
curl --location-trusted -u root: -T amazon_reviews_2011.snappy.parquet -H "format:parquet" http://127.0.0.1:8030/api/${DB}/amazon_reviews/_stream_load
curl --location-trusted -u root: -T amazon_reviews_2012.snappy.parquet -H "format:parquet" http://127.0.0.1:8030/api/${DB}/amazon_reviews/_stream_load
curl --location-trusted -u root: -T amazon_reviews_2013.snappy.parquet -H "format:parquet" http://127.0.0.1:8030/api/${DB}/amazon_reviews/_stream_load
curl --location-trusted -u root: -T amazon_reviews_2014.snappy.parquet -H "format:parquet" http://127.0.0.1:8030/api/${DB}/amazon_reviews/_stream_load
curl --location-trusted -u root: -T amazon_reviews_2015.snappy.parquet -H "format:parquet" http://127.0.0.1:8030/api/${DB}/amazon_reviews/_stream_load
Размер указанных выше файлов может превышать 10 ГБ. Измените параметр streaming_load_max_mb в be.conf, чтобы не превысить ограничение размера загружаемого файла в Stream Load. Следующая команда применяет изменение динамически (выполните ее на каждом BE):
curl -X POST http://{be_ip}:{be_http_port}/api/update_config?streaming_load_max_mb=32768
3. Проверьте загрузку данных
Выполните SQL-запрос с count(), чтобы убедиться, что данные успешно загружены:
mysql> SELECT COUNT() FROM amazon_reviews;
+-----------+
| count(*)  |
+-----------+
| 135589433 |
+-----------+
Шаг 3: Сравнение производительности
Сценарий 1: Запрос без индекса (время выполнения 7.60 с)
SELECT
    product_id,
    any_value(product_title),
    AVG(star_rating) AS rating,
    COUNT() AS count
FROM
    amazon_reviews
WHERE
    review_body LIKE '%is super awesome%'
GROUP BY
    product_id
ORDER BY
    count DESC,
    rating DESC,
    product_id
LIMIT 5;
Результат запроса:
+------------+------------------------------------------+--------------------+-------+
| product_id | any_value(product_title)                 | rating             | count |
+------------+------------------------------------------+--------------------+-------+
| B00992CF6W | Minecraft                                | 4.8235294117647056 |    17 |
| B009UX2YAC | Subway Surfers                           | 4.7777777777777777 |     9 |
| B00DJFIMW6 | Minion Rush: Despicable Me Official Game |              4.875 |     8 |
| B0086700CM | Temple Run                               |                  5 |     6 |
| B00KWVZ750 | Angry Birds Epic RPG                     |                  5 |     6 |
+------------+------------------------------------------+--------------------+-------+
5 rows in set (7.60 sec)
Сценарий 2: После добавления индекса NGram BloomFilter (время выполнения 0.93 с)
Добавьте индекс:
ALTER TABLE amazon_reviews
ADD INDEX review_body_ngram_idx(review_body) USING NGRAM_BF
PROPERTIES("gram_size"="10", "bf_size"="10240");
Выполните тот же запрос еще раз:
+------------+------------------------------------------+--------------------+-------+
| product_id | any_value(product_title)                 | rating             | count |
+------------+------------------------------------------+--------------------+-------+
| B00992CF6W | Minecraft                                | 4.8235294117647056 |    17 |
| B009UX2YAC | Subway Surfers                           | 4.7777777777777777 |     9 |
| B00DJFIMW6 | Minion Rush: Despicable Me Official Game |              4.875 |     8 |
| B0086700CM | Temple Run                               |                  5 |     6 |
| B00KWVZ750 | Angry Birds Epic RPG                     |                  5 |     6 |
+------------+------------------------------------------+--------------------+-------+
5 rows in set (0.93 sec)
Сравнение производительности:
| Сценарий | Время | Прирост производительности |
|---|---|---|
| Без индекса | 7.60 с | Базовый уровень |
| После добавления индекса NGram BloomFilter | 0.93 с | Примерно в 8 раз |
Ограничения индекса для шаблонов LIKE с экранированием
Начиная с версии 4.1.5, запросы LIKE с пользовательским ESCAPE или обратной косой чертой в шаблоне не используют NGRAM Bloom Filter для отсечения блоков данных, чтобы избежать ошибочной фильтрации. Такие запросы по-прежнему поддерживаются и выполняются с обычным сканированием. Для шаблонов LIKE без экранирования индекс по-прежнему может использоваться при соблюдении существующих условий.