Тесты производительности на больших объёмах данных
В этом документе представлены результаты практического тестирования производительности загрузки и запросов с индексом ANN в Doris на наборах данных среднего и большого объёма, включая сотни миллионов записей. Документ поможет оценить производительность запросов при разных объёмах данных и понять, как плавно перейти от одноузлового к распределённому развёртыванию.
Быстрая навигация
Прочитав этот документ, вы сможете ответить на следующие вопросы:
- Может ли один узел BE обеспечивать поиск в реальном времени по десяткам миллионов векторов? Каких значений QPS и задержки можно ожидать?
- Как продолжить обслуживать векторные запросы к сотням миллионов векторов с помощью нескольких узлов BE, если памяти одного узла уже недостаточно?
- Как различается производительность при разной размерности векторов (768/1536) и разных метриках расстояния (
inner_product/l2_distance)? - Как воспроизвести результаты этих тестов?
Тестовая среда и наборы данных
Топология развёртывания
| Режим развёртывания | Узлы BE | Конфигурация узла | Подходящий объём данных |
|---|---|---|---|
| Один узел | 1 | 16C64GB | Десятки миллионов |
| Распределённый | 3 | 16C64GB | Сотни миллионов |
FE и BE развёрнуты отдельно. Во всех тестах используется инструмент VectorDBBench.
Обзор наборов данных
| Набор данных | Объём данных | Размерность вектора | Метрика расстояния | Топология развёртывания |
|---|---|---|---|---|
| Performance768D10M | 10M | 768 | inner_product | Один узел |
| Performance1536D5M | 5M | 1536 | inner_product | Один узел |
| Performance768D100M | 100M | 768 | l2_distance | Распределённая |
Тест производительности на одном узле (16C64GB)
Результаты тестирования на одном узле служат отправной точкой для оценки производительности ANN-запросов на наборах данных среднего и большого объёма.
Производительность загрузки
Показатели загрузки для двух наборов данных приведены ниже:
| Показатель | Performance768D10M | Performance1536D5M |
|---|---|---|
| Размерность вектора | 768 | 1536 |
metric_type | inner_product | inner_product |
| Объём данных | 10M строк | 5M строк |
| Параметры пакета загрузки | NUM_PER_BATCH=500000--stream-load-rows-per-batch 500000 | NUM_PER_BATCH=250000--stream-load-rows-per-batch 250000 |
| Время загрузки | 76m41s | 41m |
show data all | 56.498 GB (25.354 GB + 31.145 GB) | 55.223 GB (25.346 GB + 29.878 GB) |
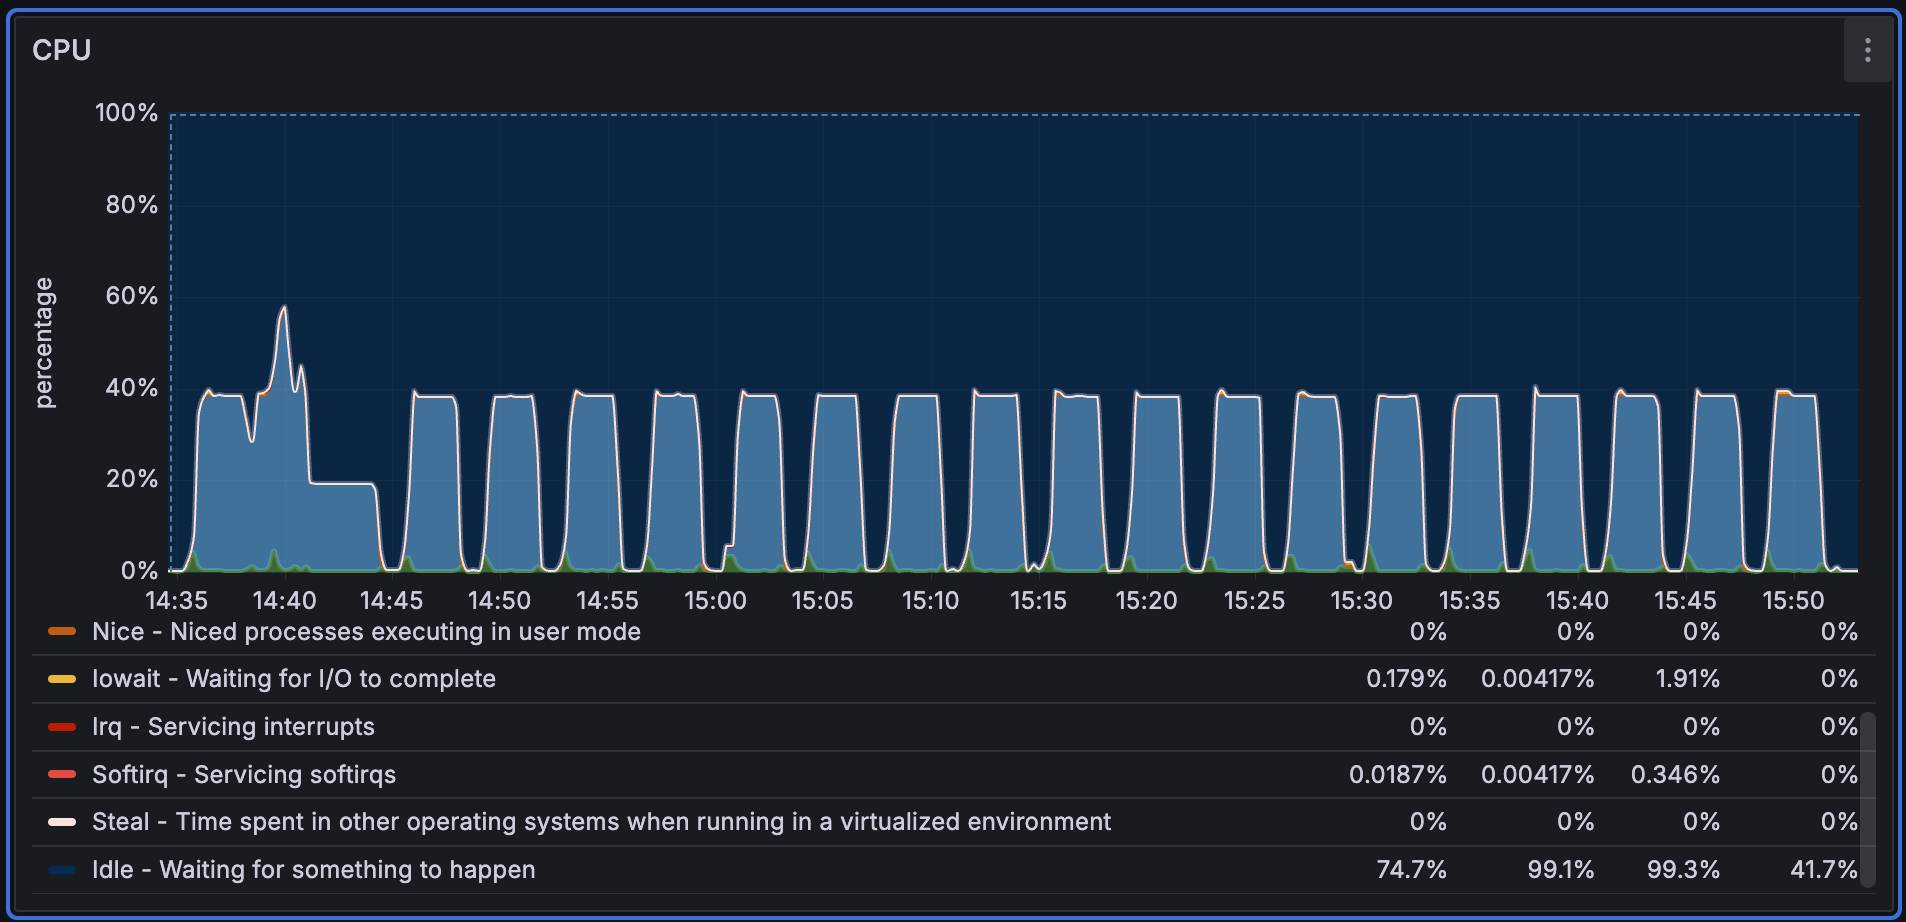
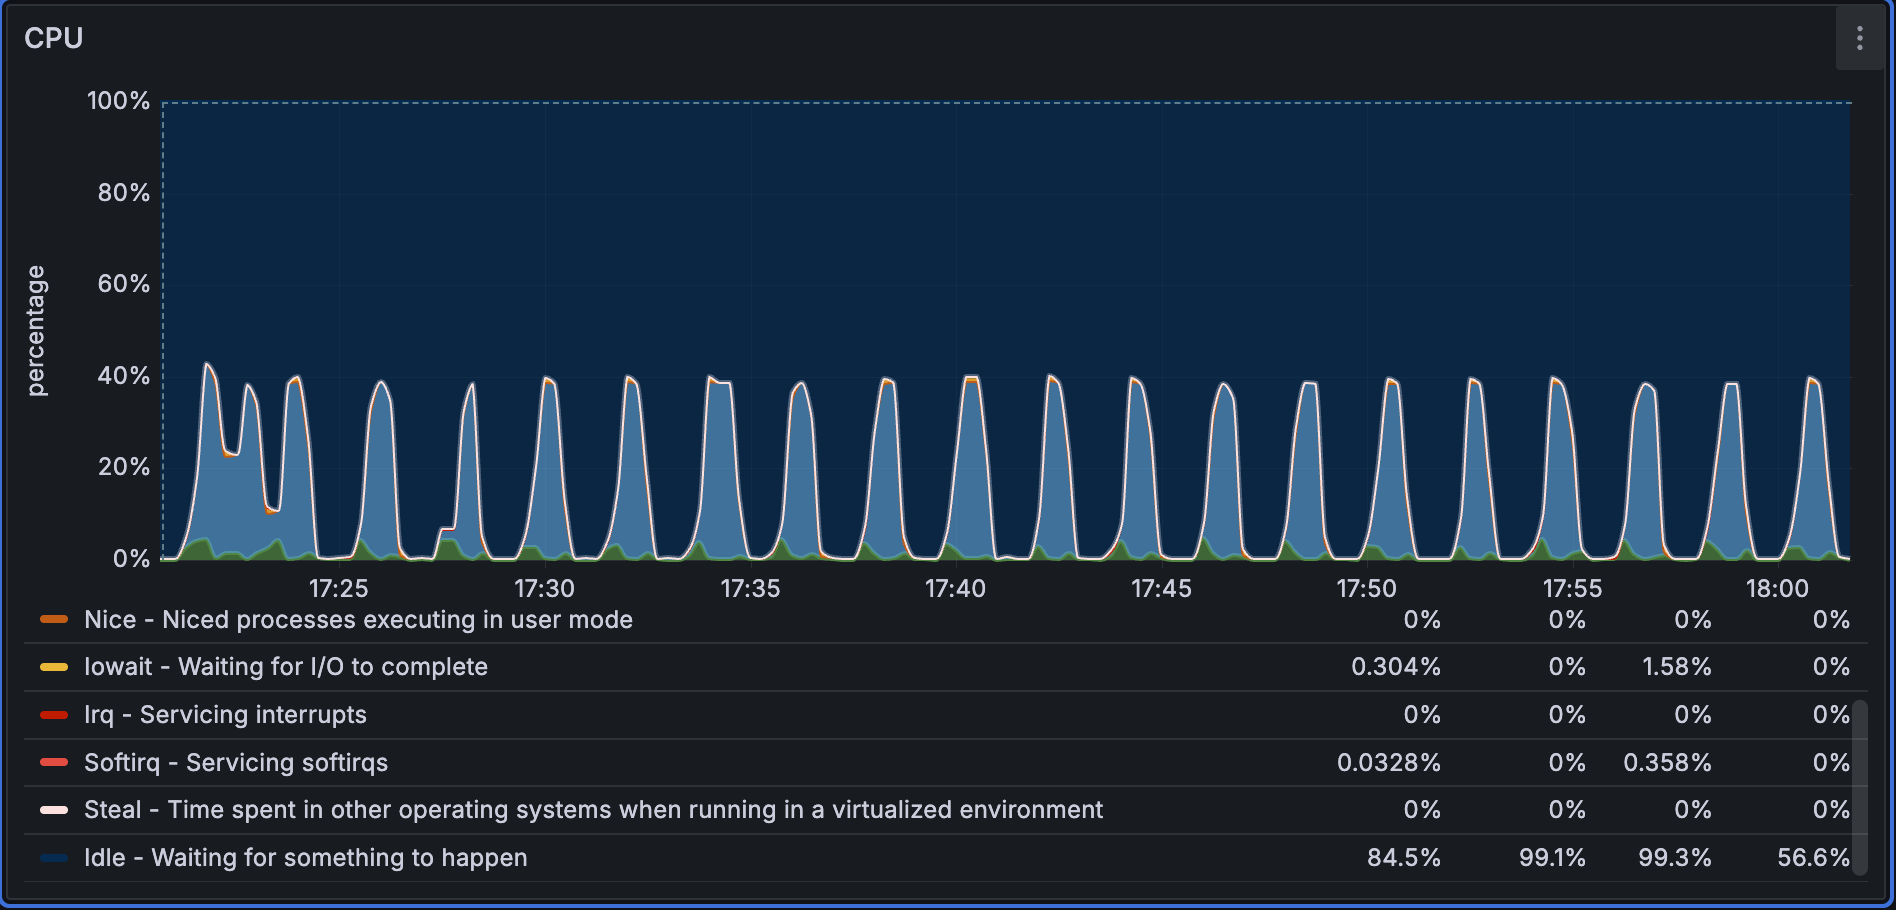
Использование CPU:
-
Во время загрузки Performance768D10M использование CPU в целом оставалось относительно стабильным.
-
Объём данных и размер пакета у Performance1536D5M меньше, поэтому во время загрузки использование CPU колеблется чаще.
Производительность запросов
При высокой полноте поиска одноузловое развёртывание позволяет достичь сотен QPS и поддерживать низкую задержку запросов.
Сводные показатели
| Набор данных | BestQPS | Recall@100 |
|---|---|---|
| Performance768D10M | 481.9356 | 0.9207 |
| Performance1536D5M | 414.7342 | 0.9677 |
Подробные результаты Performance768D10M (inner_product, 10M строк)
| Число одновременных запросов | QPS | Задержка P95 | Задержка P99 | Средняя задержка |
|---|---|---|---|---|
| 10 | 116.2000 | 0.0932 | 0.0933 | 0.0861 |
| 40 | 455.9485 | 0.1102 | 0.1225 | 0.0877 |
| 80 | 481.9356 | 0.2331 | 0.2674 | 0.1658 |
Подробные результаты Performance1536D5M (inner_product, 5M строк)
| Число одновременных запросов | QPS | Задержка P95 | Задержка P99 | Средняя задержка |
|---|---|---|---|---|
| 10 | 144.3221 | 0.0764 | 0.0800 | 0.0693 |
| 40 | 401.9732 | 0.1271 | 0.1404 | 0.0994 |
| 80 | 414.7342 | 0.2772 | 0.3222 | 0.1925 |
Мониторинг CPU
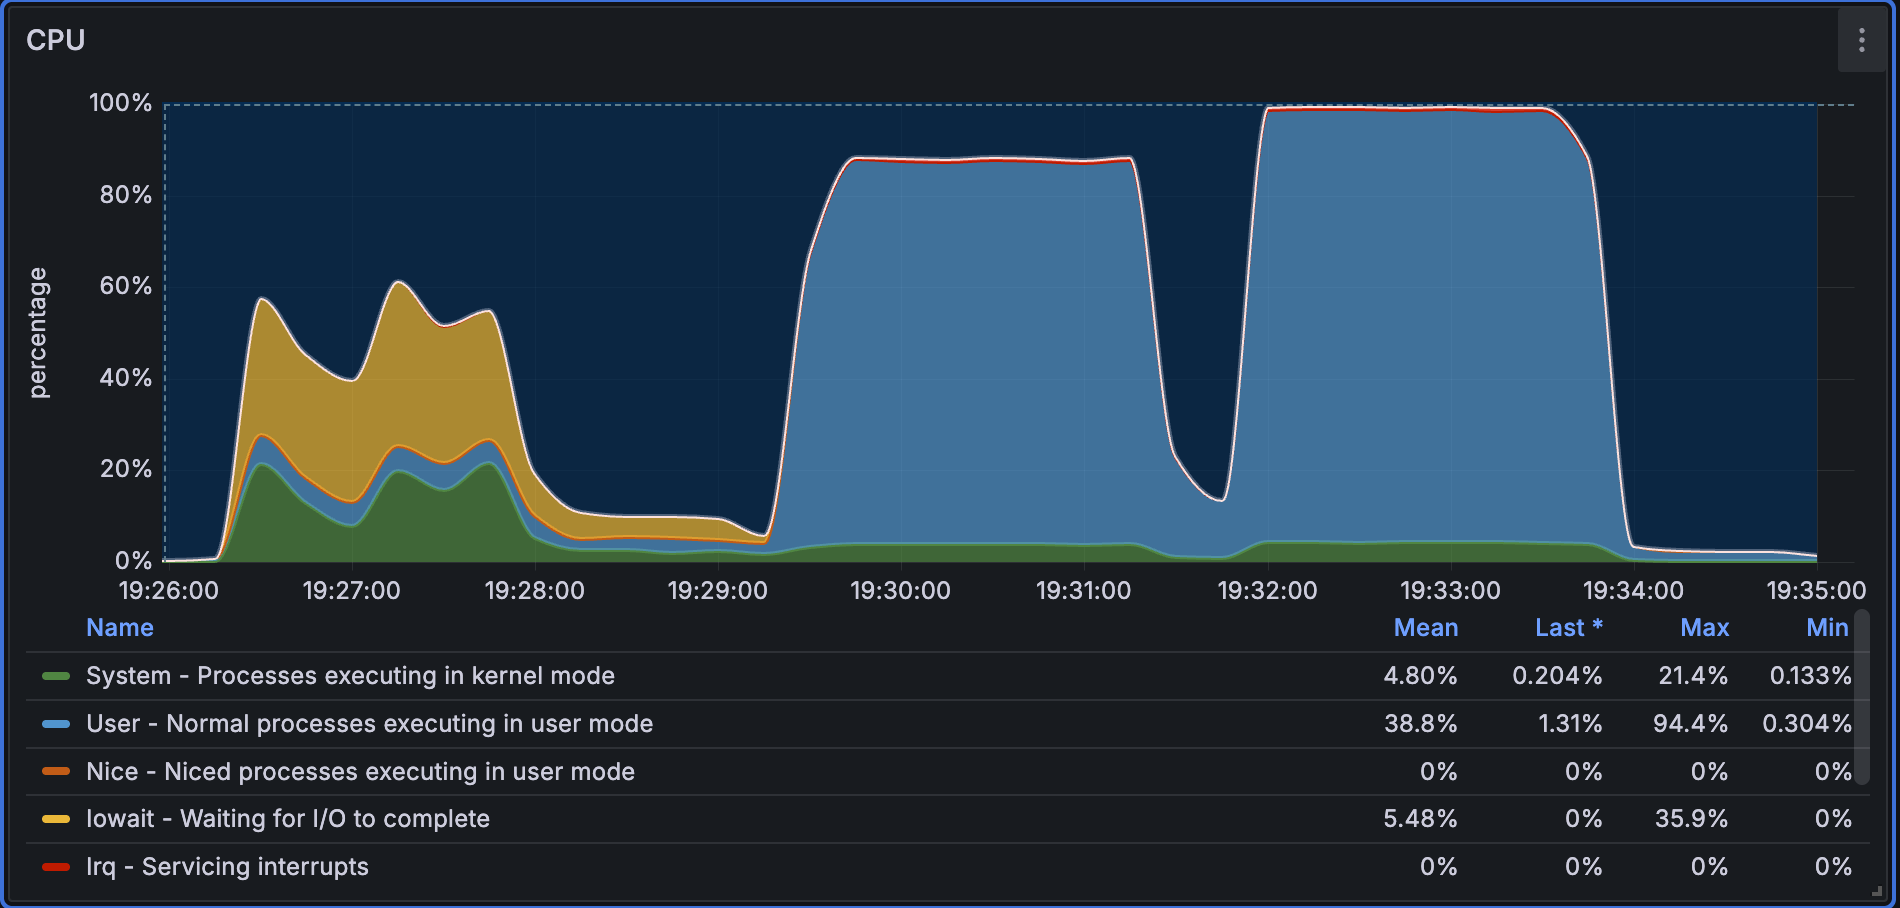
На этапе холодных запросов индекс необходимо загрузить в память, поэтому использование CPU относительно низкое, а система в основном ожидает завершения операций IO. После перехода к горячим запросам использование CPU значительно возрастает и приближается к 100%.
Тест производительности распределённого развёртывания (3 x 16C64GB)
Когда объём данных превышает объём, который можно обоснованно разместить в памяти одного узла с конфигурацией 16C64GB, можно масштабировать систему горизонтально, развернув несколько узлов BE. В этом разделе на примере набора данных Performance768D100M (100M строк, 768 измерений) показано, что Doris сохраняет возможность выполнять векторные запросы в реальном времени и при объёме 100M.
Результаты этого теста не предназначены для прямого сравнения абсолютных значений с результатами одноузловых тестов на меньших объёмах данных. Они лучше подходят для оценки того, как меняется производительность с ростом объёма данных.
Загрузка и построение индекса
Поскольку объём памяти каждого узла ограничен 64GB, в этом тесте для уменьшения потребления памяти используется сжатие с помощью векторного квантования.
| Показатель | Значение |
|---|---|
| Набор данных | Performance768D100M |
| Объём данных | 100M строк |
| Размерность вектора | 768 |
| Параметры пакета | NUM_PER_BATCH=500000--stream-load-rows-per-batch 500000 |
| Параметры индекса | "dim"="768", "index_type"="hnsw", "metric_type"="l2_distance", "pq_m"="384", "pq_nbits"="8", "quantizer"="pq" |
| Время построения индекса | 4h5min |
show data all | 198.809 GB (137.259 GB + 61.550 GB) |
Распределение данных после построения индекса:
- Всего 3 бакета
- Каждый бакет содержит 34 rowset размером около 1.99 GB каждый
- Каждый rowset содержит 6 сегментов
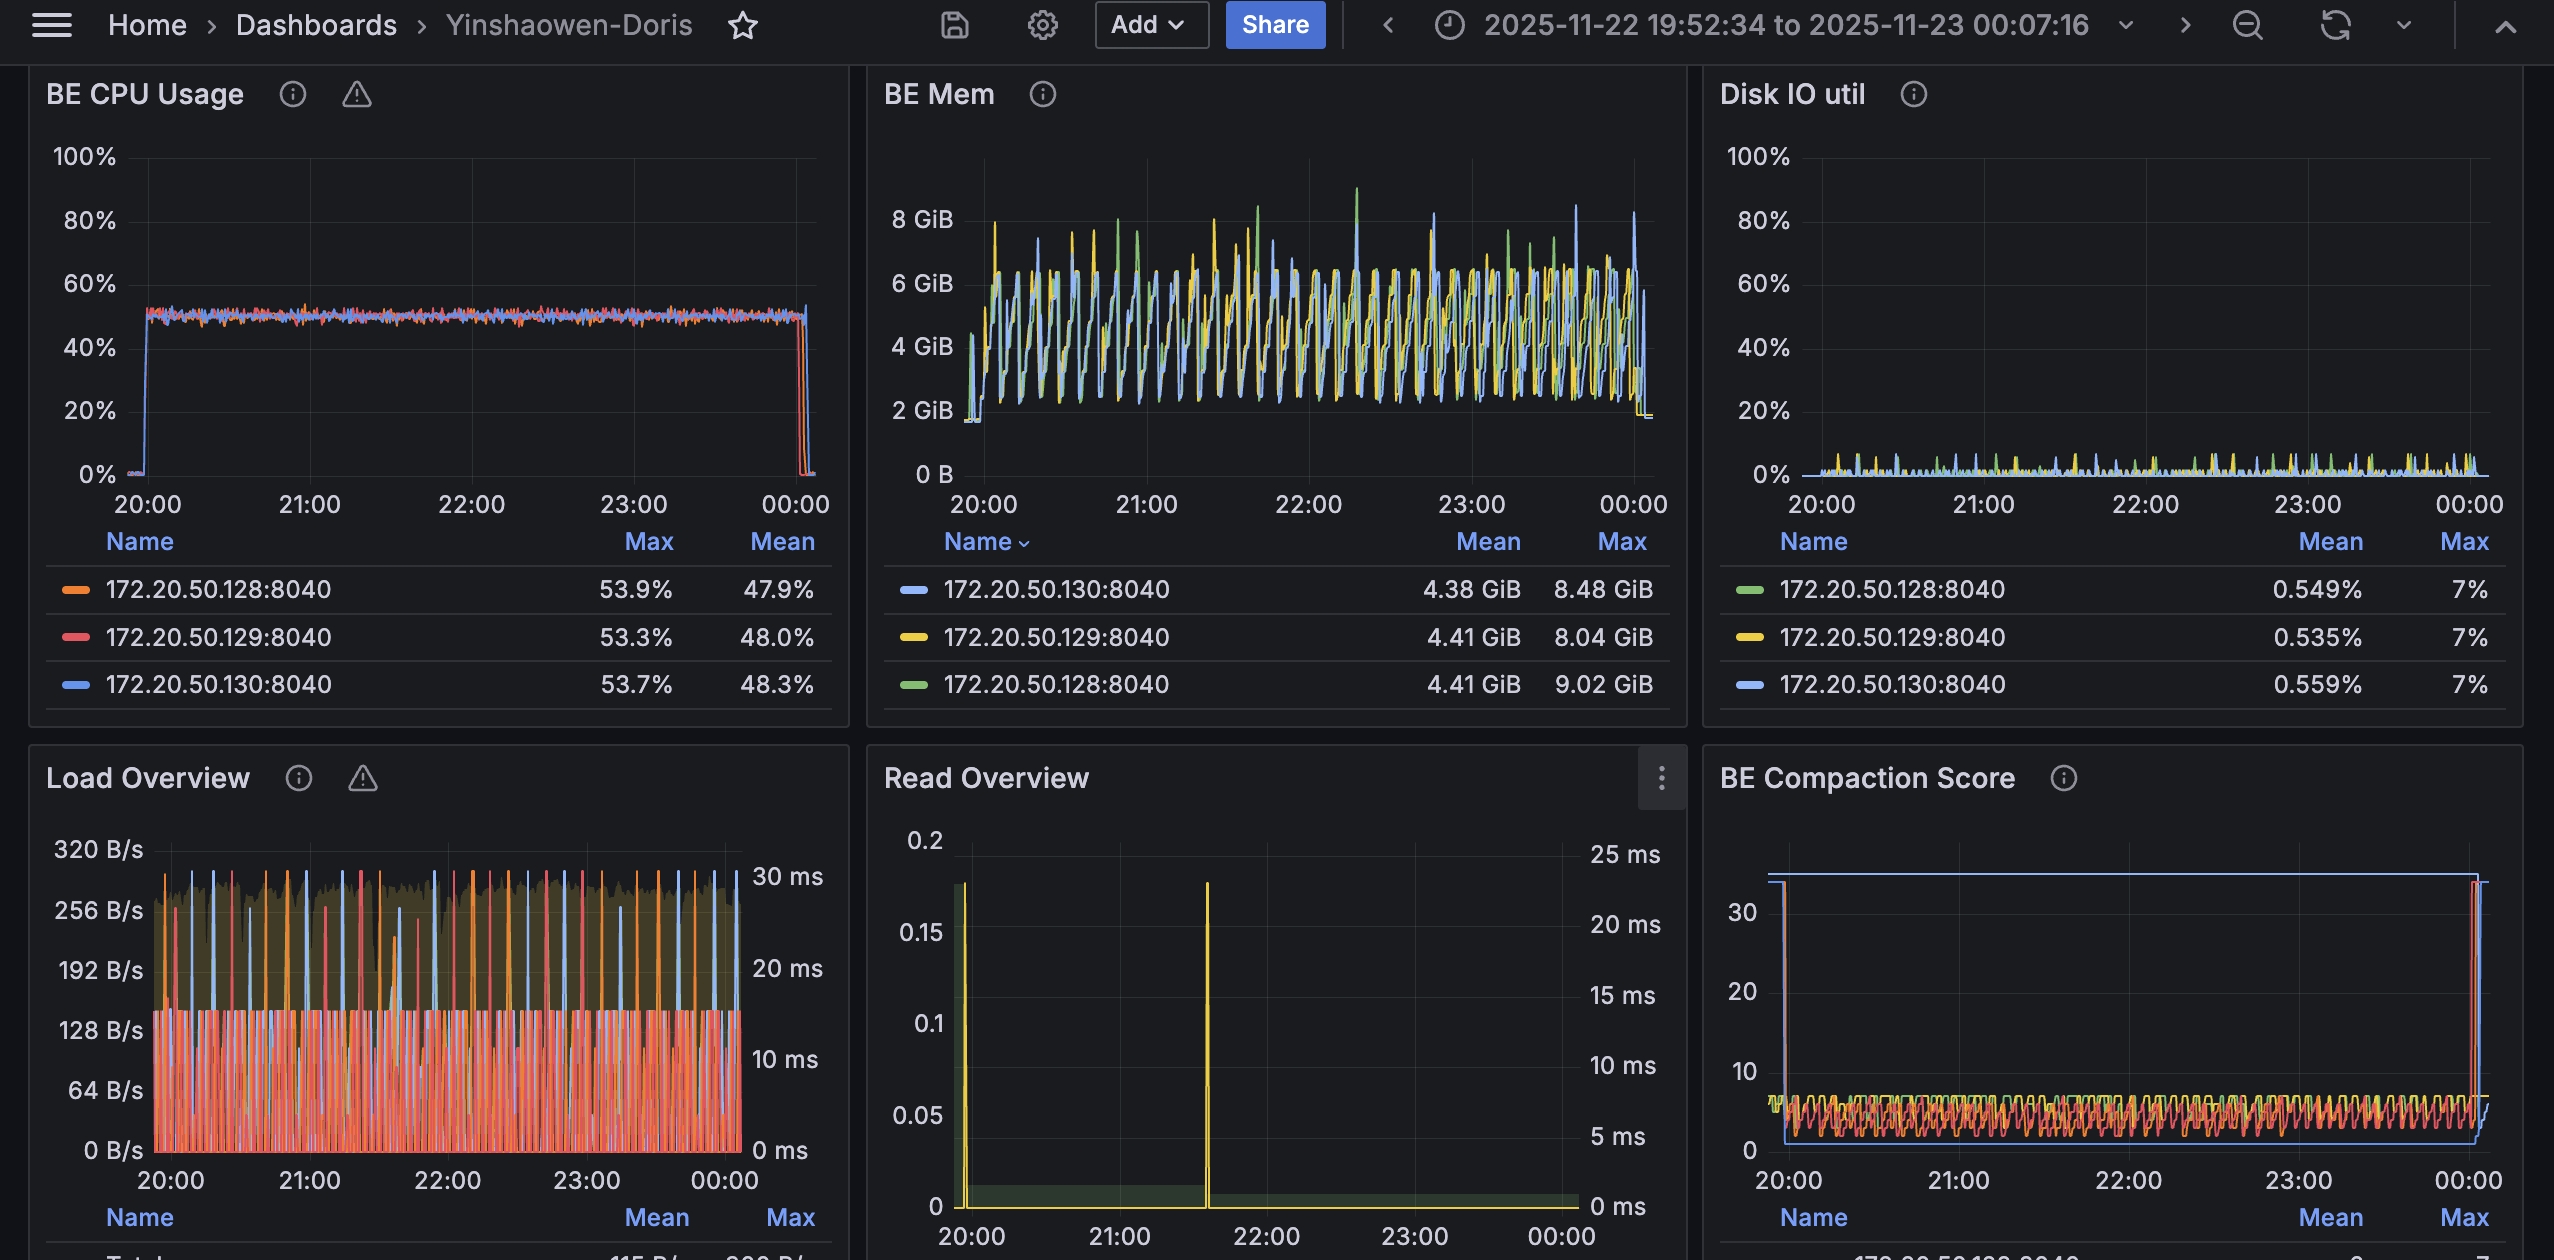
Использование CPU: Во время построения индекса использование CPU в целом оставалось стабильным на уровне около 50%. Длительных периодов максимальной загрузки CPU не наблюдалось, поэтому сохранялся некоторый запас ресурсов.
Производительность запросов
Сводные показатели
| Показатель | Значение |
|---|---|
| BestQPS | 77.6247 |
| Recall@100 | 0.9294 |
Подробные результаты (l2_distance, 100M строк)
| Число одновременных запросов | QPS | Задержка P95 | Задержка P99 | Средняя задержка |
|---|---|---|---|---|
| 10 | 46.5836 | 0.2628 | 0.2791 | 0.2145 |
| 20 | 75.3579 | 0.3251 | 0.3541 | 0.2651 |
| 30 | 77.6247 | 0.5222 | 0.5766 | 0.3860 |
| 40 | 76.6313 | 0.7089 | 0.7854 | 0.5212 |
Мониторинг CPU
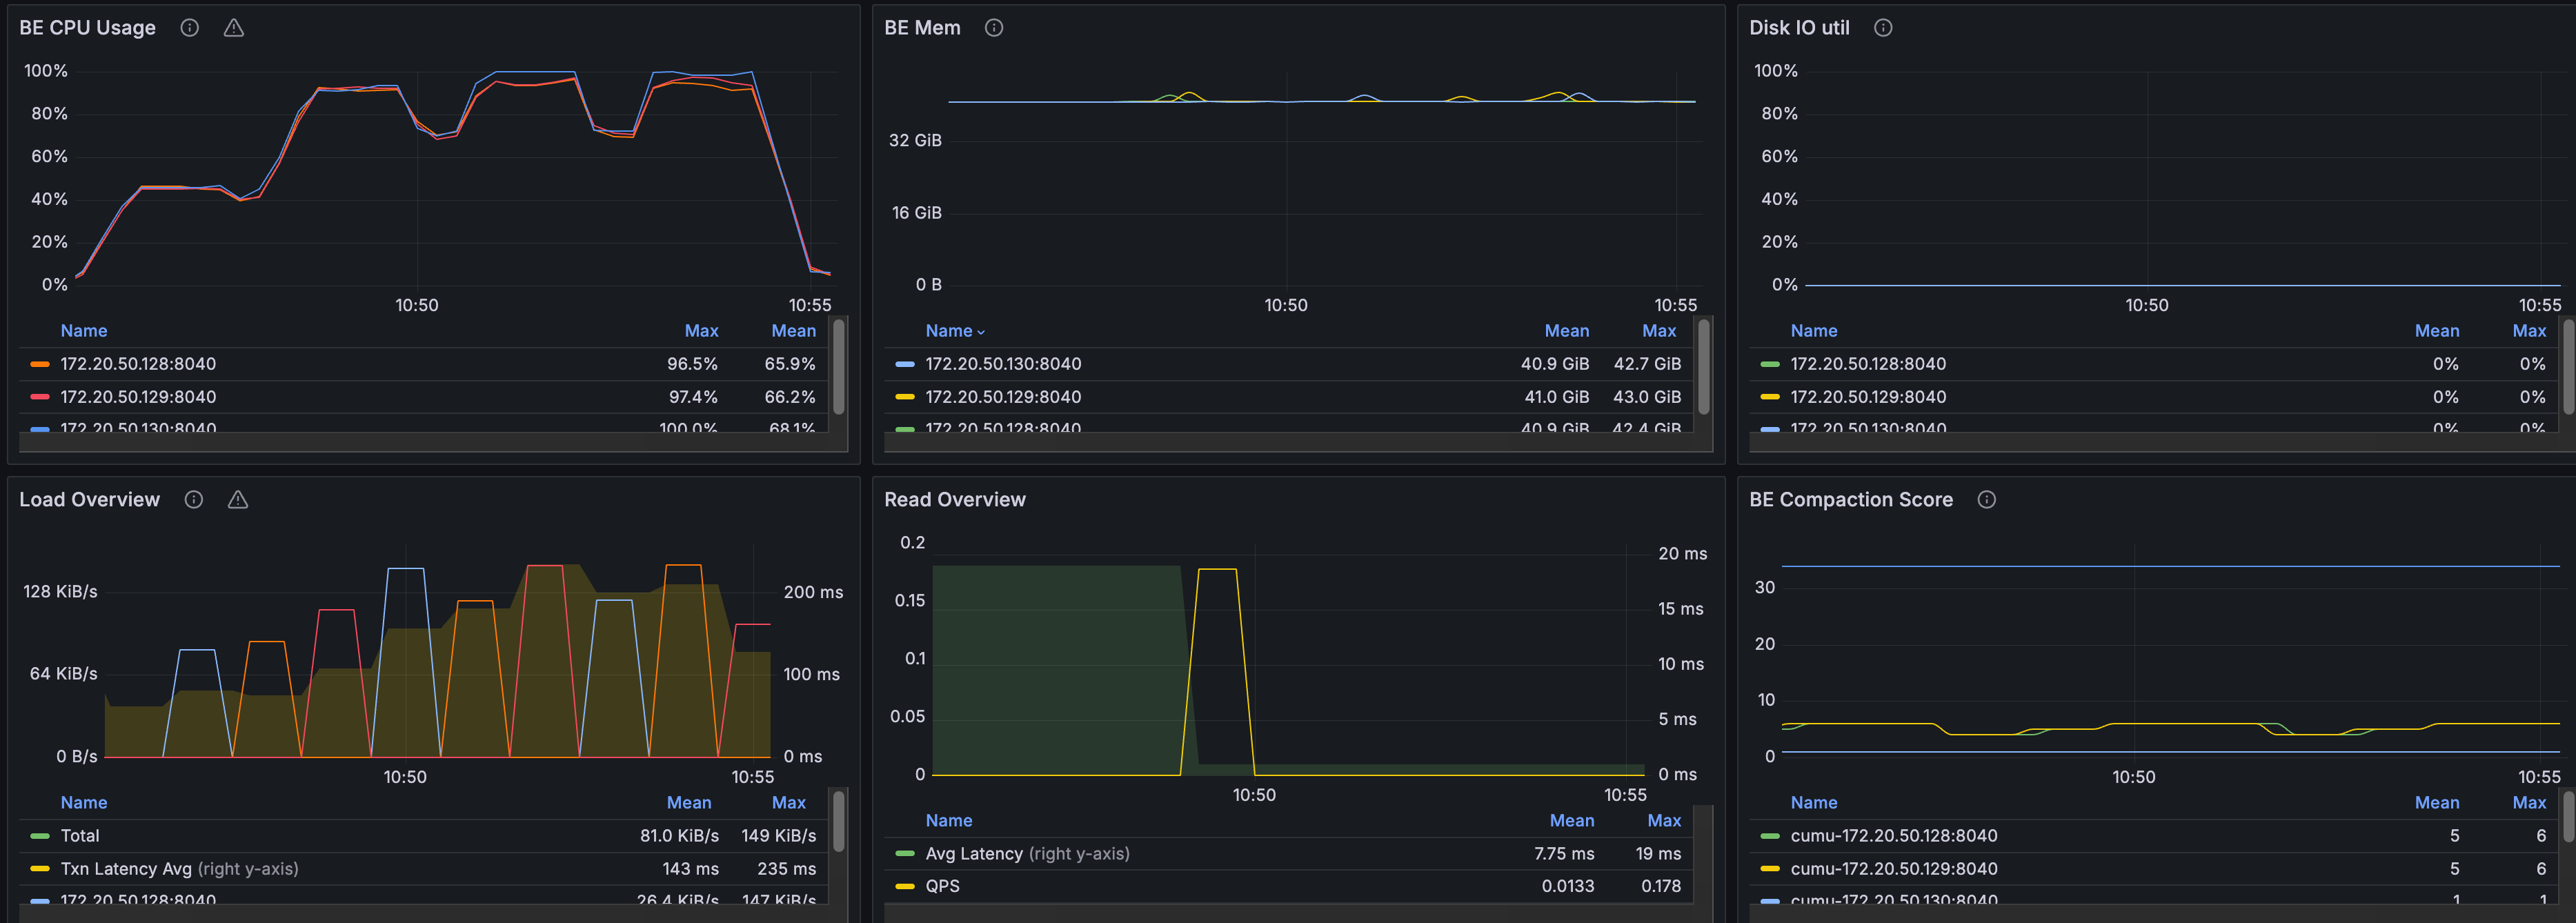
Во время выполнения запросов использование CPU на каждом узле остаётся высоким. Это указывает на то, что запросы эффективно используют распределённые вычислительные ресурсы.
Основные выводы
- Десятки миллионов на одном узле: При объёме векторных данных в десятки миллионов одноузловое развёртывание Doris обеспечивает сотни QPS для ANN-запросов при высокой полноте поиска (>=0.92).
- Сотни миллионов в распределённом развёртывании: На наборе данных из 100M векторов развёртывание с несколькими узлами BE в сочетании со сжатием с помощью векторного квантования позволяет продолжать выполнять векторные запросы в реальном времени (BestQPS около 77, Recall@100 около 0.93).
- Горизонтальная масштабируемость: Когда объём данных превышает ёмкость памяти одного узла, распределённое развёртывание позволяет сохранить возможность поиска в реальном времени.
Примечания к тестам
При интерпретации результатов учитывайте следующее:
- Разные метрики расстояния: В одноузловых тестах используется
inner_product, а в распределённом тесте используетсяl2_distance. Прямое сравнение абсолютных значений не рекомендуется. - Разные объёмы данных и параметры индекса: Объёмы данных и параметры индекса, например использование квантования, различаются между группами тестов. Результаты лучше подходят для оценки того, как меняется производительность с ростом объёма данных.
- Корректировка с учётом холодных запросов: В одноузловом тесте
Performance768D10Mрезультат для 10 одновременных запросов был скорректирован после исключения влияния холодных запросов.
Как воспроизвести результаты
Тесты выполняются с помощью инструмента VectorDBBench.
Воспроизведение одноузловых тестов
# Performance768D10M
export NUM_PER_BATCH=500000
vectordbbench doris ... --case-type Performance768D10M --stream-load-rows-per-batch 500000

# Performance1536D5M
export NUM_PER_BATCH=250000
vectordbbench doris ... --case-type Performance1536D5M --stream-load-rows-per-batch 250000
Воспроизведение распределённого теста с 3BE
export NUM_PER_BATCH=500000
vectordbbench doris ... --case-type Performance768D100M --stream-load-rows-per-batch 500000
Часто задаваемые вопросы
Вопрос 1: Какое максимальное количество векторов может вместить один узел с конфигурацией 16C64GB?
Это зависит от размерности векторов, использования квантования и параметров индекса. В приведённом тесте 10M строк с 768-мерными векторами (около 56 GB) стабильно обрабатываются на одном узле с конфигурацией 16C64GB. При дальнейшем росте объёма данных или увеличении размерности включите векторное квантование либо используйте распределённое развёртывание с несколькими узлами BE.
Вопрос 2: Почему QPS в распределённом тесте ниже, чем в одноузловых тестах?
Эти группы тестов различаются метрикой расстояния, объёмом данных и параметрами индекса (в распределённом тесте включено квантование PQ), поэтому напрямую сравнивать абсолютные значения нельзя. Цель распределённого теста состоит в проверке масштабируемости на больших объёмах данных, а не в достижении максимального QPS.
Вопрос 3: Почему для набора данных объёмом 100M требуется квантование?
Объём памяти каждого узла ограничен 64GB, а исходный размер 100M векторов размерности 768 уже превышает эту ёмкость. Квантование PQ (pq_m=384, pq_nbits=8) значительно снижает потребление памяти и позволяет выполнять поиск в реальном времени на больших объёмах данных.
Вопрос 4: Включает ли время загрузки время построения индекса?
В одноузловых тестах «время загрузки» означает общее время записи. Индекс строится либо во время записи, либо на этапе фоновой компактации. В распределённом тесте build index time указан отдельно, чтобы можно было оценить затраты на построение индекса при больших объёмах данных.