Тестирование и анализ производительности
В этом документе представлены результаты тестирования производительности запросов и загрузки данных для векторного индекса Apache Doris (ANN Index). Все тесты выполнены с помощью VectorDBBench, а их результаты помогут вам:
- Оценить, соответствует ли векторный поиск Doris требованиям вашего бизнеса.
- Понять компромиссы между полнотой, производительностью запросов и скоростью загрузки данных.
- Воспроизвести результаты тестов локально и проверить поведение в промышленной среде.
Результаты тестирования на более крупных наборах данных (масштаба 10M / 100M) при развёртывании на одном узле и в распределённой конфигурации приведены в документе Тестирование производительности на больших объёмах данных.
Тестовая среда
| Параметр | Конфигурация |
|---|---|
| Характеристики машины | 16C 64GB |
| Модель CPU | Intel(R) Xeon(R) Platinum 8369B CPU @ 2.70GHz |
| Развёртывание | FE и BE размещены на одной машине |
| Версия Doris | Apache Doris 4.0.2 |
| Тестовый набор данных | VectorDBBench Performance768D1M (векторы размерности 768, 1 миллион строк) |
Размещение FE и BE на одной машине не рекомендуется для промышленной эксплуатации. В промышленной среде размещайте FE и BE на отдельных машинах.
Результаты тестирования
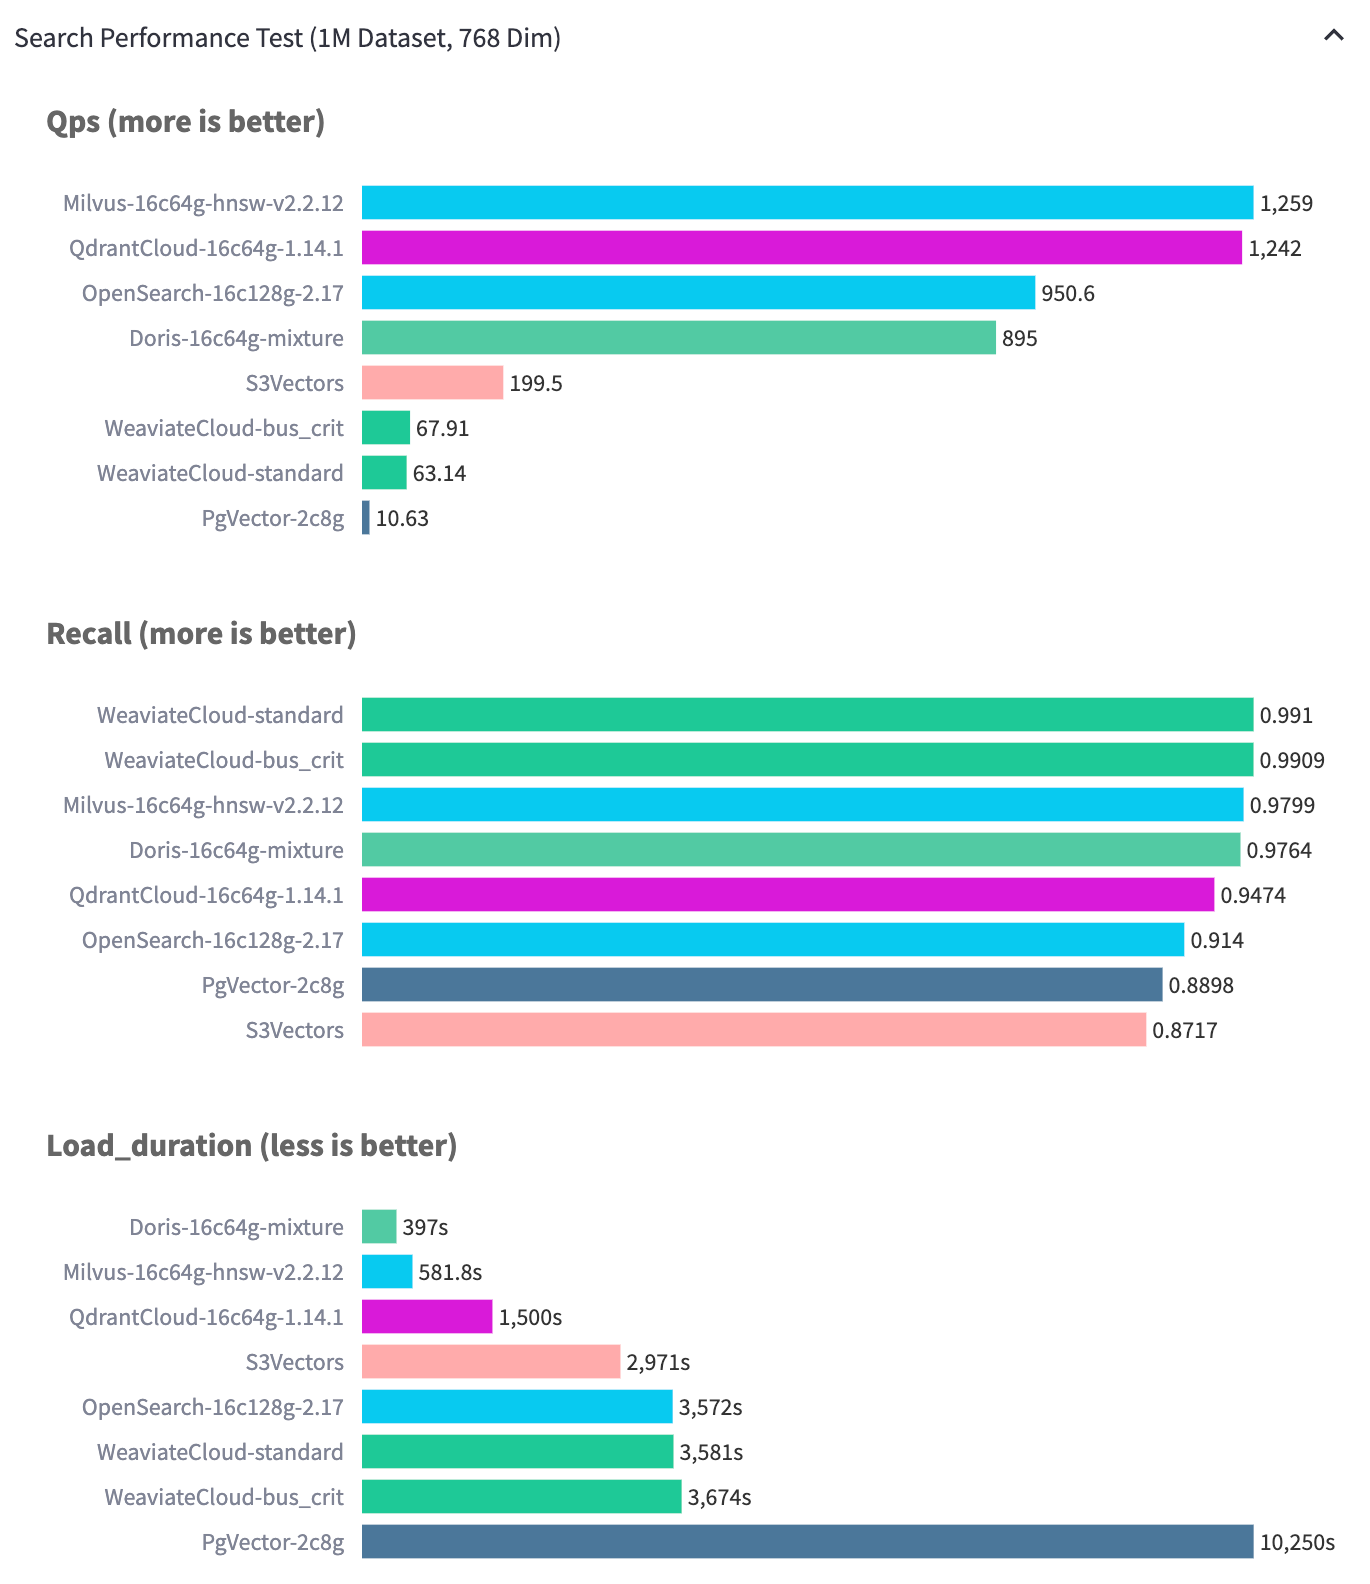
На наборе данных Performance768D1M Apache Doris достигает 989.1 QPS, сохраняя полноту выше 97%, а производительность загрузки данных значительно превосходит показатели сопоставимых систем.
Анализ результатов
«Треугольник производительности» векторных баз данных
В сценариях векторного поиска зрелой векторной базе данных, стабильно работающей в промышленной среде, обычно приходится искать компромисс между следующими тремя показателями:
                    ┌──────────────────────┐
                    │      Recall          │
                    │  (Higher is Better)  │
                    └──────────▲───────────┘
                               / \
                              /   \
                             /     \
                            /       \
                           /         \
                          /           \
             ┌───────────┘             └───────────┐
             │                                     │
             │                                     │
             ▼                                     ▼
 ┌──────────────────────┐                 ┌────────────────────────┐
 │      Query QPS       │                 │     Indexing           │
 │   (Latency / QPS)    │                 │     Throughput         │
 │  (Lower Latency Better)│               │  (Higher is Better)    │
 └──────────────────────┘                 └────────────────────────┘
| Показатель | Метрика | Желаемое направление изменения |
|---|---|---|
| Полнота | Доля попаданий в Top-K | Чем выше, тем лучше |
| QPS запросов / Задержка | Число запросов в секунду / задержка одного запроса | Выше QPS, ниже задержка |
| Пропускная способность построения индекса | Скорость построения индекса | Чем выше, тем лучше |
Все три показателя обычно трудно максимизировать одновременно, поэтому при проектировании векторных баз данных приходится искать баланс между ними.
Основные параметры HNSW и компромиссы при настройке
Рассмотрим HNSW (Hierarchical Navigable Small World), наиболее распространённый в отрасли векторный индекс. Для оптимизации поиска он использует структуру графа и имеет три основных настраиваемых гиперпараметра:
| Параметр | Назначение | Влияние |
|---|---|---|
max_degree | Максимальная исходящая степень каждой вершины графа | Определяет плотность графа и его общую связность |
ef_construction | Размер набора кандидатов при построении индекса | Большее значение позволяет построить более качественный граф |
hnsw_ef_search | Размер окна поиска при выполнении запросов | Напрямую влияет на полноту и задержку запросов |
Типичные компромиссы при настройке:
- Увеличение
max_degreeиef_constructionзначительно улучшает связность графа и эффективность навигации, что повышает полноту. - Более качественный граф позволяет уменьшить
hnsw_ef_searchпри выполнении запросов, что сокращает затраты на поиск и повышает производительность запросов. - Обратная сторона заключается в том, что построение индекса требует больше вычислительных ресурсов и памяти, что снижает производительность загрузки данных.
Это типичная «трилемма», с которой приходится сталкиваться при проектировании векторных баз данных.
Подход Apache Doris к оптимизации
При разработке возможностей векторного поиска Apache Doris стремится создать более сбалансированный треугольник производительности за счёт:
- Оптимизации базового движка выполнения.
- Улучшения формата хранения.
- Распараллеливания конвейера построения HNSW на уровне реализации.
В результате Doris значительно повышает общую скорость загрузки данных с построением индекса, сохраняя качество индекса и высокую полноту.
Результаты тестирования на наборе данных Performance768D1M подтверждают достижение этой цели:
- При одинаковом качестве индекса производительность загрузки данных в Doris значительно выше, чем в сопоставимых системах.
- Повышение скорости загрузки данных достигается без снижения качества графа.
- QPS достигает 989.1, полнота остаётся выше 97%, при этом достигается баланс всех трёх показателей.
Шаги для воспроизведения
Чтобы воспроизвести тест локально, выполните следующую команду:
NUM_PER_BATCH=500000 vectordbbench doris \
    --host 127.0.0.1 \
    --port 9030 \
    --http-port 8030 \
    --case-type Performance768D1M \
    --db-name vdb \
    --num-concurrency 80 \
    --stream-load-rows-per-batch 500000 \
    --index-prop max_degree=128,ef_construction=256 \
    --session-var hnsw_ef_search=100
Основные параметры:
| Параметр | Значение |
|---|---|
--case-type | Выбирает тестовый сценарий (здесь — набор данных 768D1M) |
--num-concurrency | Число одновременно выполняемых запросов |
--stream-load-rows-per-batch | Число строк в пакете для Stream Load |
--index-prop | Параметры построения индекса (max_degree, ef_construction) |
--session-var | Переменные сеанса при выполнении запросов (hnsw_ef_search) |
Связанные документы
- Тестирование производительности на больших объёмах данных: результаты тестирования на наборах данных масштаба 10M / 100M при развёртывании на одном узле и в распределённой конфигурации.
- Внутреннее устройство индекса HNSW
- Обзор векторного индекса
- Практическое руководство по векторному индексу