Pipeline 执行引擎
Doris 的并行执行模型是一种 Pipeline 执行模型,主要参考了Hyper论文中 Pipeline 的实现方式,Pipeline 执行模型能够充分释放多核 CPU 的计算能力,并对 Doris 的查询线程的数目进行限制,从而解决 Doris 的执行线程膨胀的问题。它的具体设计、实现和效果可以参阅 [DSIP-027](DSIP-027: Support Pipeline Exec Engine - DORIS - Apache Software Foundation) 以及 [DSIP-035](DSIP-035: PipelineX Execution Engine - DORIS - Apache Software Foundation)。 Doris 3.0 之后,Pipeline 执行模型彻底替换了原有的火山模型,基于 Pipeline 执行模型,Doris 实现了 Query、DDL、DML 语句的并行处理。
物理计划
为了更好的理解 Pipeline 执行模型,首先需要介绍一下物理查询计划中两个重要的概念:PlanFragment 和 PlanNode。我们使用下面这条 SQL 作为例子:
SELECT k1, SUM(v1) FROM A,B WHERE A.k2 = B.k2 GROUP BY k1 ORDER BY SUM(v1);
FE 首先会把它翻译成下面这种逻辑计划,计划中每个节点就是一个 PlanNode,每种 Node 的具体含义,可以参考查看物理计划的介绍。
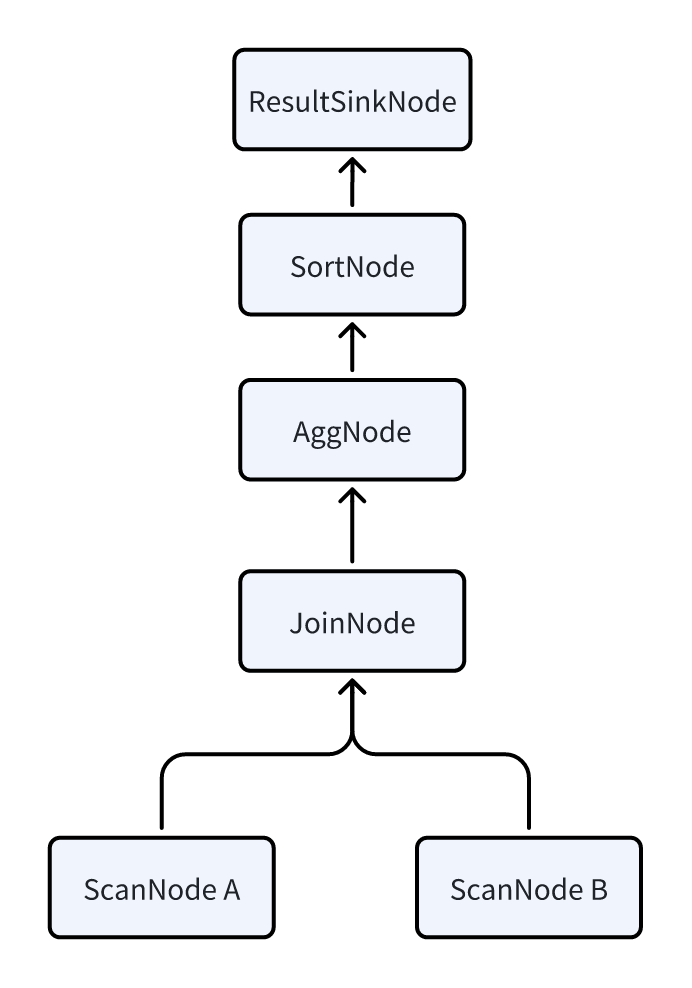
由于 Doris 是一个 MPP 的架构,每个查询都会尽可能的让所有的 BE 都参与进来并行执行,来降低查询的延时。所以还需要将上述逻辑计划拆分为一个物理计划,拆分物理计划基本上就是在逻辑计划中插入了 DataSink 和 ExchangeNode,通过这两个 Node 完成了数据在多个 BE 之间的 Shuffle。拆分完成后,每个 PlanFragment 相当于包含了一部分 PlanNode,可以作为一个独立的任务发送给 BE,每个 BE 完成了 PlanFragment 内包含的 PlanNode 的计算后,通过 DataSink 和 ExchangeNode 这两个算子把数据 shuffle 到其他 BE 上来进行接下来的计算。
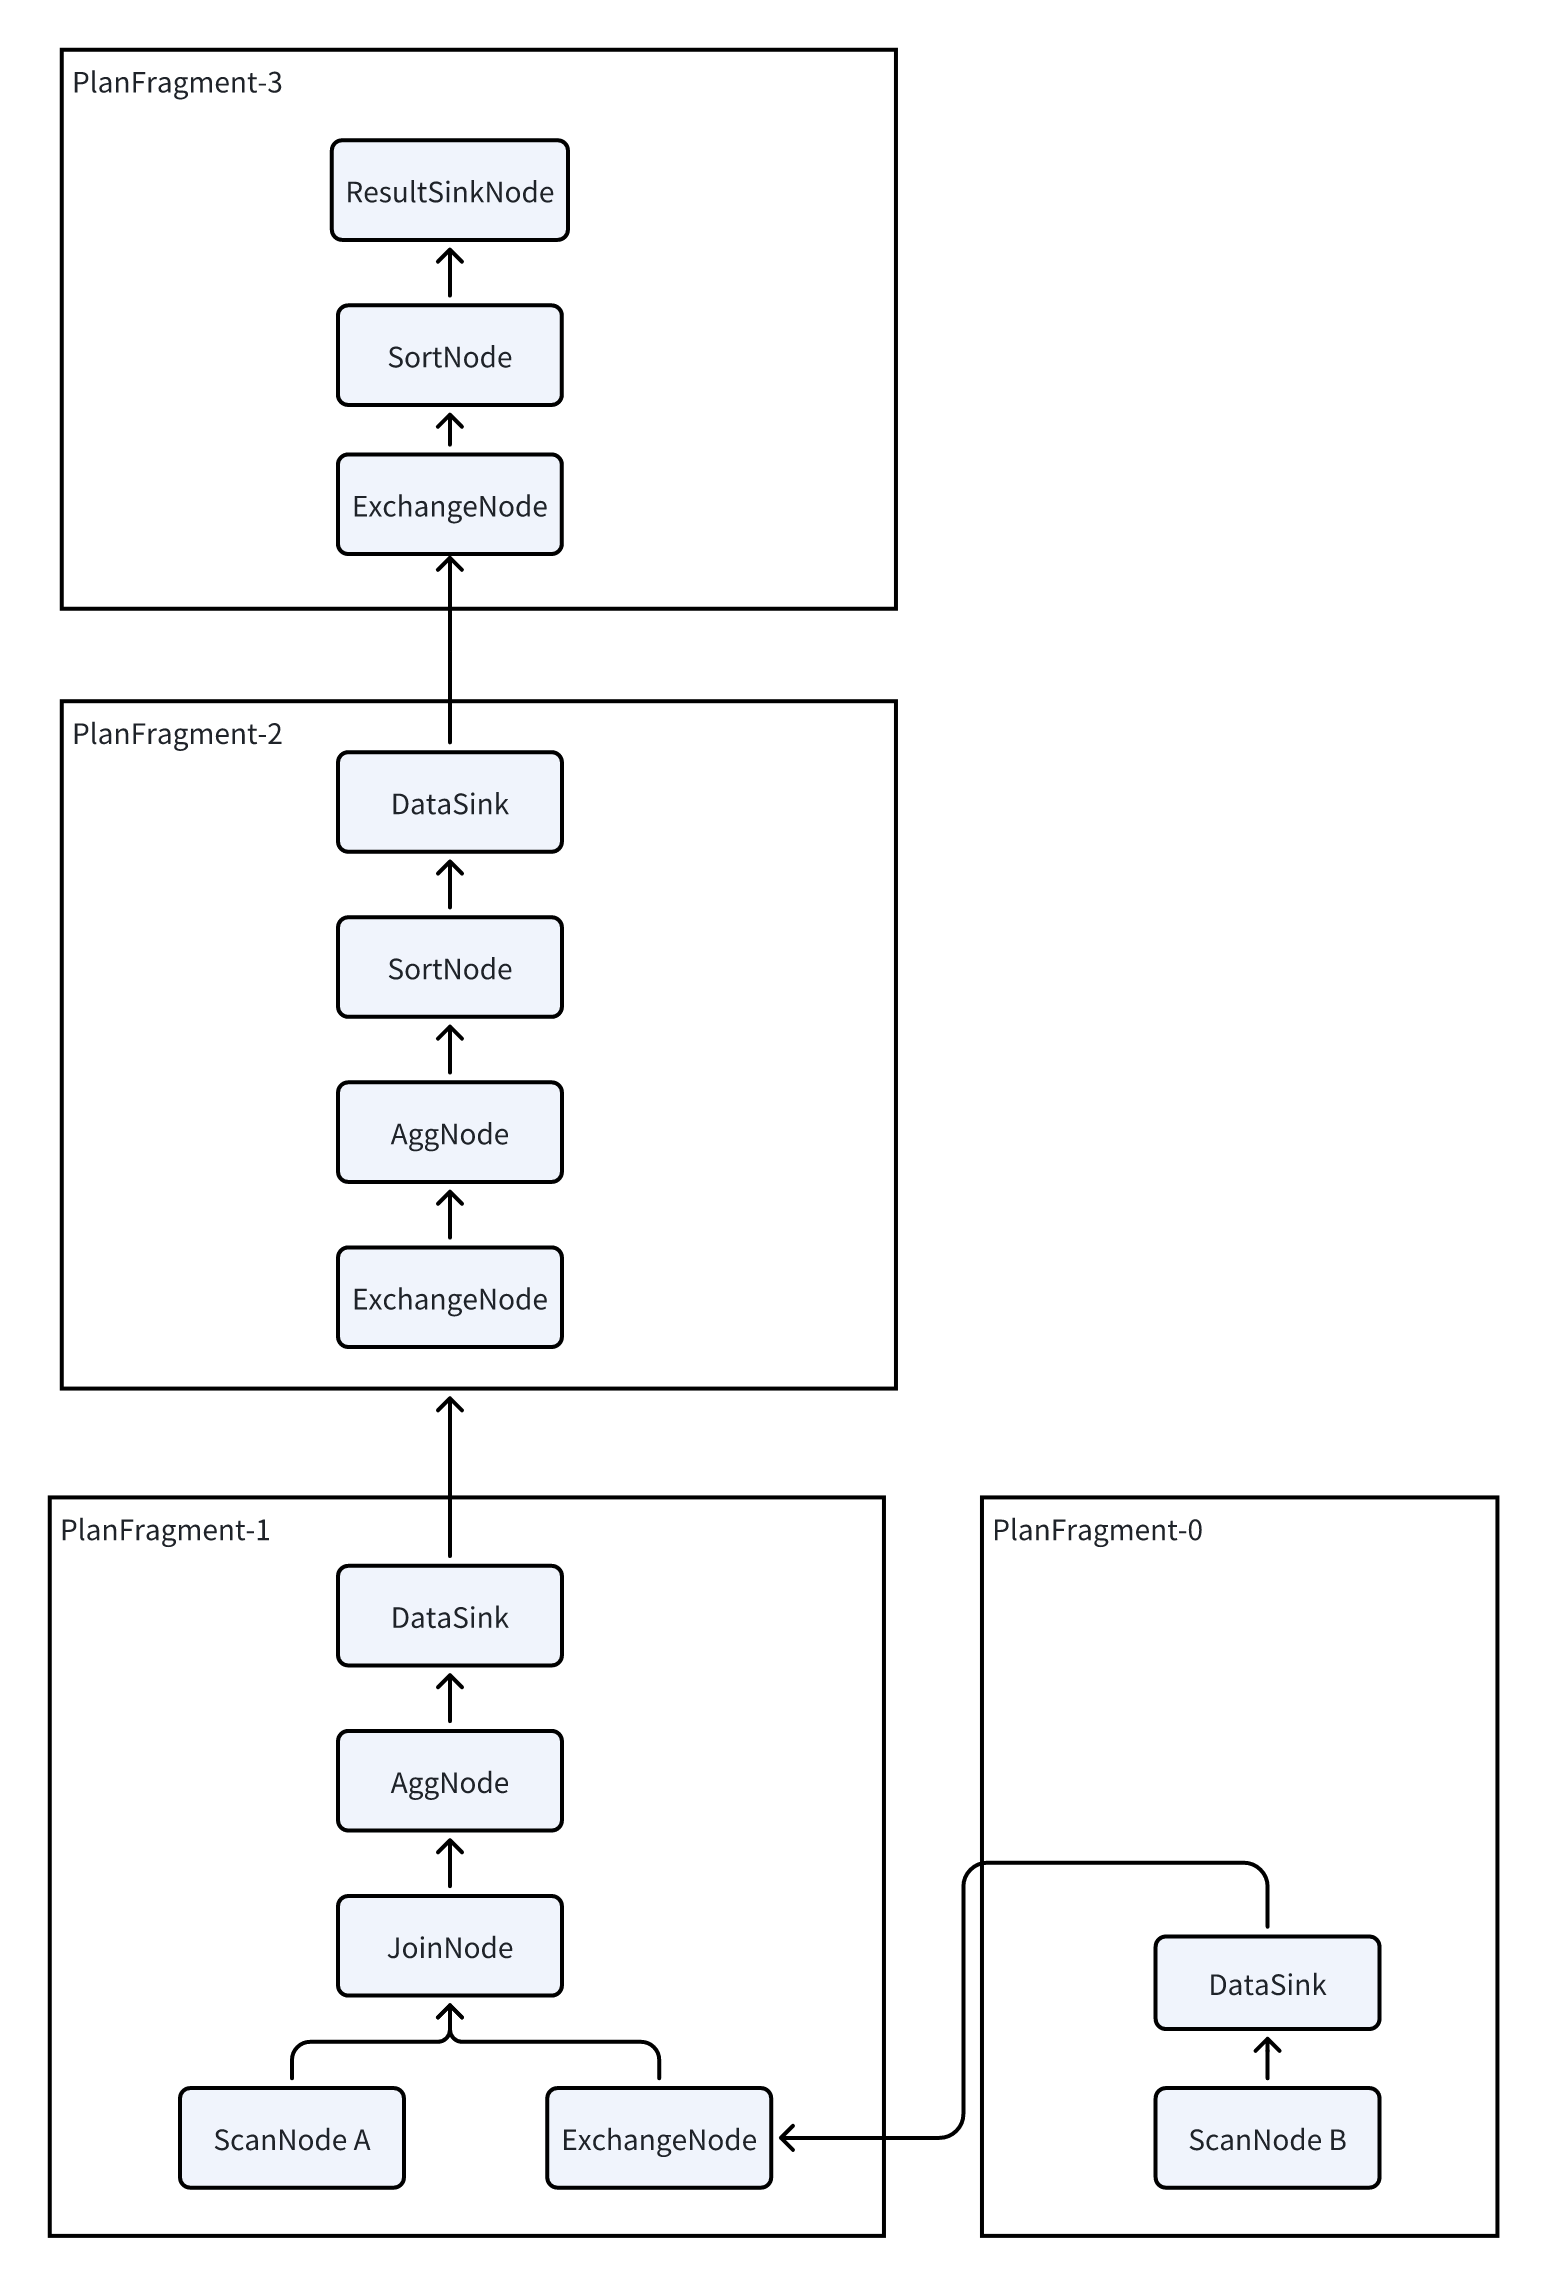
所以 Doris 的规划分为 3 层: PLAN:执行计划,一个 SQL 会被执行规划器翻译成一个执行计划,之后执行计划会提供给执行引擎执行。
FRAGMENT:由于 DORIS 是一个分布式执行引擎。一个完整的执行计划会被切分为多个单机的执行片段。一个 FRAGMENT 代表一个完整的单机执行片段。多个 FRAGMENT 组合在一起,构成一个完整的 PLAN。
PLAN NODE:算子,是执行计划的最小单位。一个 FRAGMENT 由多个算子构成。每一个算子负责一个实际的执行逻辑,比如聚合,连接等
Pipeline 执行
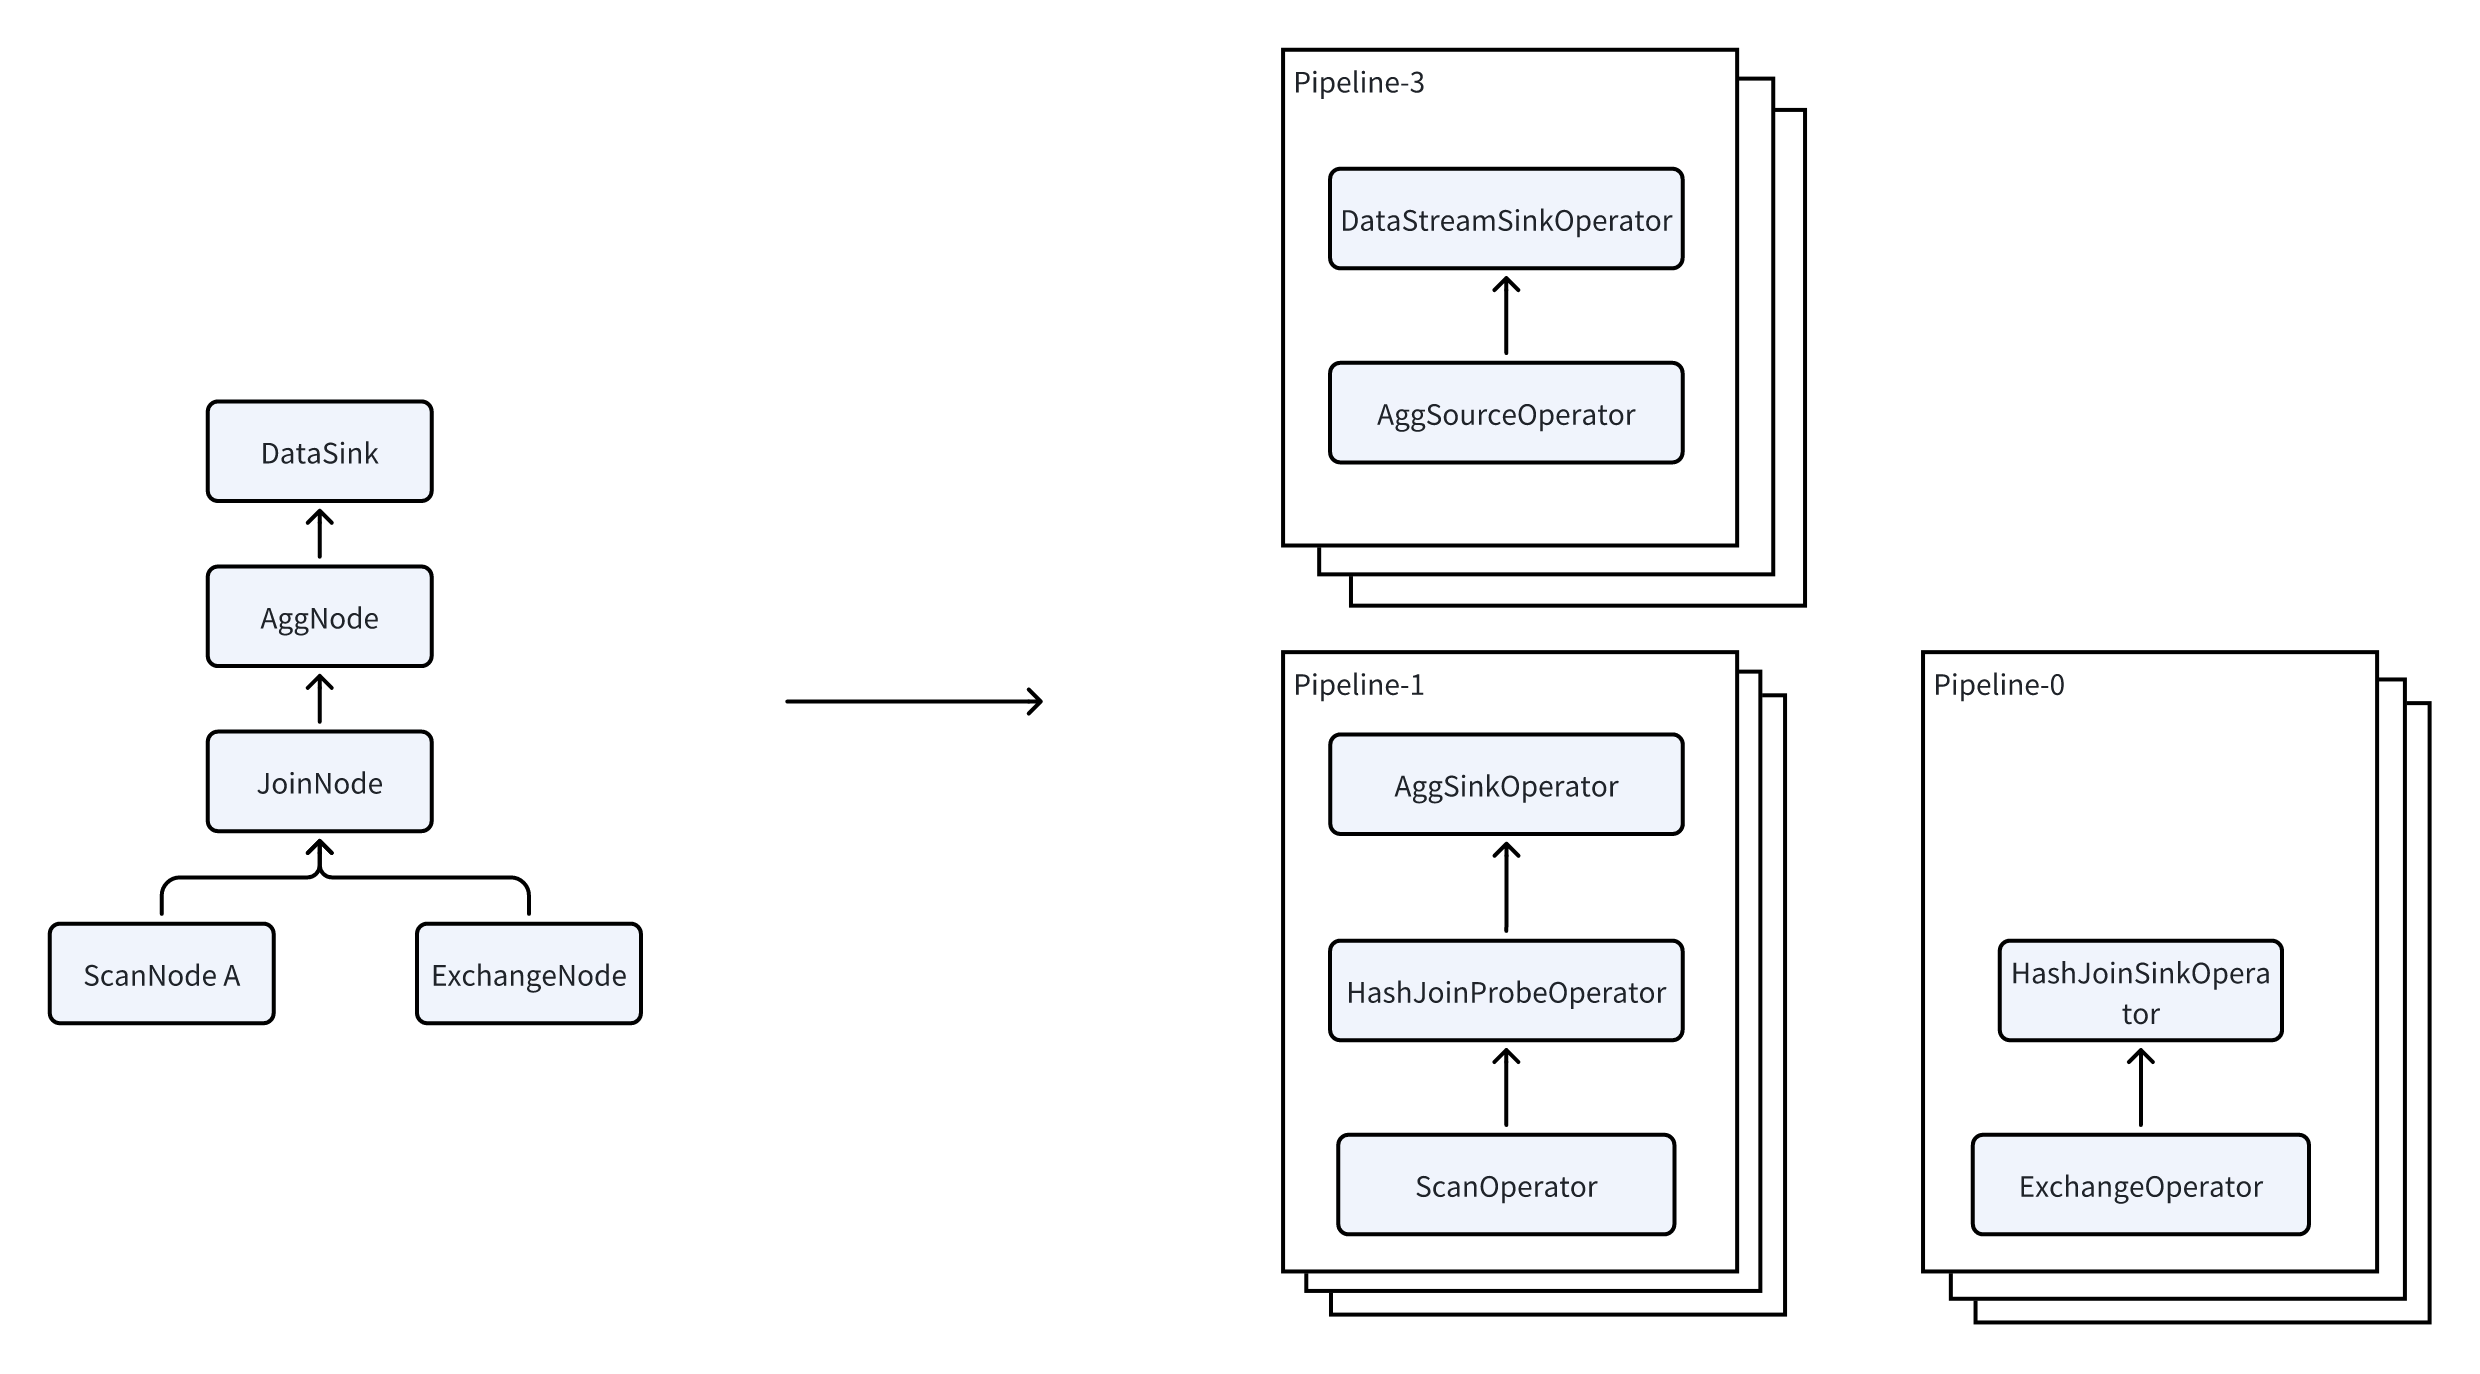
PlanFragment 是 FE 发往 BE 执行任务的最小单位。BE 可能会收到同一个 Query 的多个不同的 PlanFragment,每个 PlanFragment 都会被单独的处理。在收到 PlanFragment 之后,BE 会把 PlanFragment 拆分为多个 Pipeline,进而启动多个 PipelineTask 来实现并行执行,提升查询效率。
Pipeline
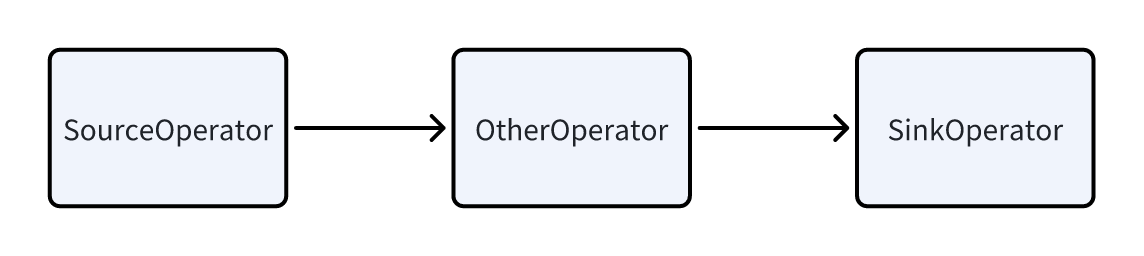
一个 Pipeline 有一个 SourceOperator 和 一个 SinkOperator 以及中间的多个其他 Operator 组成。SourceOperator 代表从外部读取数据,可以是一个表(OlapTable),也可以是一个 Buffer(Exchange)。SinkOperator 表示数据的输出,输出可以是通过网络 shuffle 到别的节点,比如 DataStreamSinkOperator,也可以是输出到 HashTable,比如 Agg 算子,JoinBuildHashTable 等。
多个 Pipeline 之间实际是有依赖关系的,以 JoinNode 为例,实际被拆分到了 2 个 Pipeline 里。其中 Pipeline-0 是读取 Exchange 的数据,来构建 HashTable;Pipeline-1 是从表里读取数据,来进行 Probe。这 2 个 Pipeline 之间是有关联关系的,只有 Pipeline-0 运行完毕之后才能执行 Pipeline-1。这两者之间的依赖关系,称为 Dependency。当 Pipeline-0 运行完毕后,会调用 Dependency 的 set_ready 方法通知 Pipeline-1 可执行。
PipelineTask
Pipeline 实际还是一个逻辑概念,他并不是一个可执行的实体。在有了 Pipeline 之后,需要进一步的把 Pipeline 实例化为多个 PipelineTask。将需要读取的数据分配给不同的 PipelineTask 最终实现并行处理。同一个 Pipeline 的多个 PipelineTask 之间的 Operator 完全相同,他们的区别在于 Operator 的状态不一样,比如读取的数据不一样,构建出的 HashTable 不一样,这些不一样的状态,我们称之为 LocalState。 每个 PipelineTask 最终都会被提交到一个线程池中作为独立的任务执行。在 Dependency 这种触发机制下,可以更好的利用多核 CPU,实现充分的并行。
Operator
在大多数时候,Pipeline 中的每个 Operator 都对应了一个 PlanNode,但是有一些特殊的算子除外:
- JoinNode,被拆分为 JoinBuildOperator 和 JoinProbeOperator
- AggNode 被拆分为 AggSinkOperator 和 AggSourceOperator
- SortNode 被拆分为 SortSinkOperator 和 SortSourceOperator 基本原理是,对于一些 breaking 算子(指需要把所有的数据都收集齐之后才能运算的算子),把灌入数据的部分拆分为 Sink,然后把从这个算子里获取数据的部分称为 Source。
Scan 并行化
扫描数据是一个非常重的 IO 操作,它需要从本地磁盘读取大量的数据(如果是数据湖的场景,就需要从 HDFS 或者 S3 中读取,延时更长),需要比较多的时间。所以我们在 ScanOperator 中引入了并行扫描的技术,ScanOperator 会动态的生成多个 Scanner,每个 Scanner 扫描 100 万 -200 万 行左右的数据,每个 Scanner 在做数据扫描时,完成相应的数据解压、过滤等计算任务,然后把数据发送给一个 DataQueue,供 ScanOperator 读取。
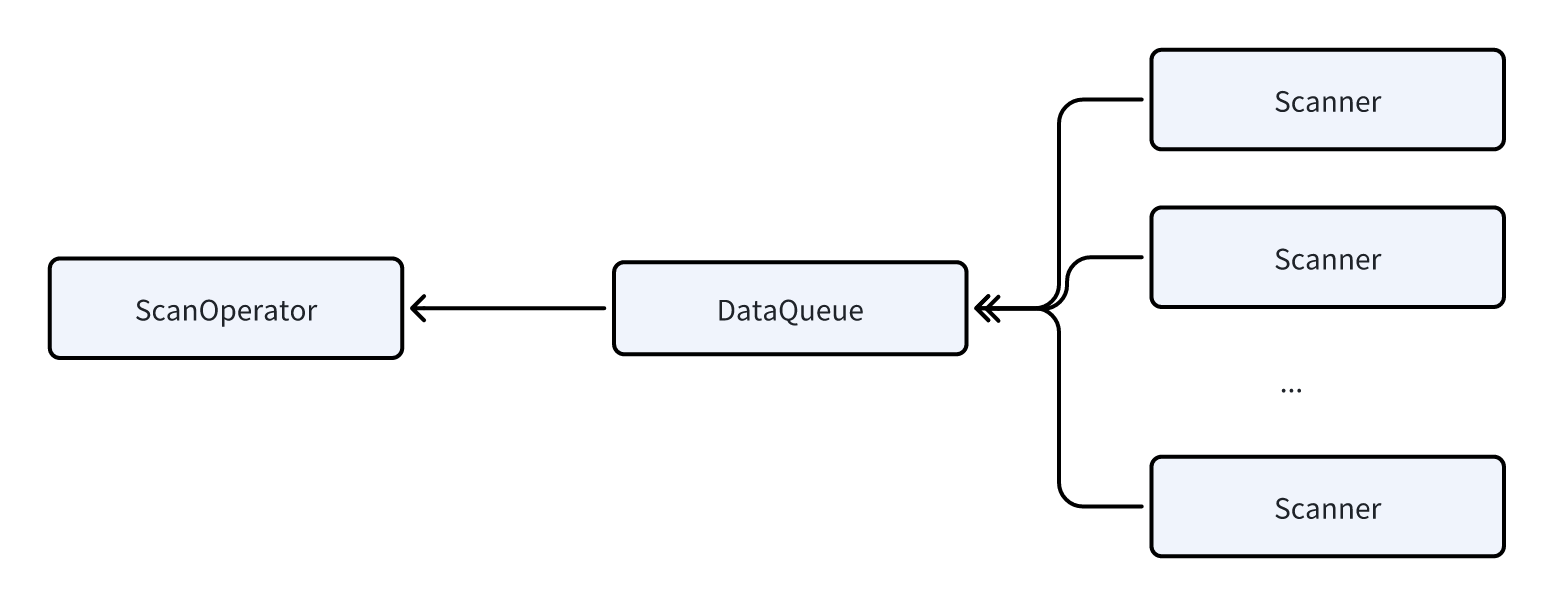
通过并行扫描的技术可以有效的避免由于分桶不合理或者数据倾斜导致某些 ScanOperator 执行时间特别久,把整个查询的延时都拖慢的问题。
Local Shuffle
在 Pipeline 执行模型中,Local Exchange 作为一个 Pipeline Breaker 出现,是在本地将数据重新分发至各个执行任务的技术。它把上游 Pipeline 输出的全部数据以某种方式(HASH / Round Robin)均匀分发到下游 Pipeline 的全部 Task 中。解决执行过程中的数据倾斜的问题,使执行模型不再受数据存储以及 plan 的限制。接下来我们举例来说明 Local Exchange 的工作逻辑。 我们用上述例子中的 Pipeline-1 为例子进一步阐述 Local Exchange 如何可以避免数据倾斜。
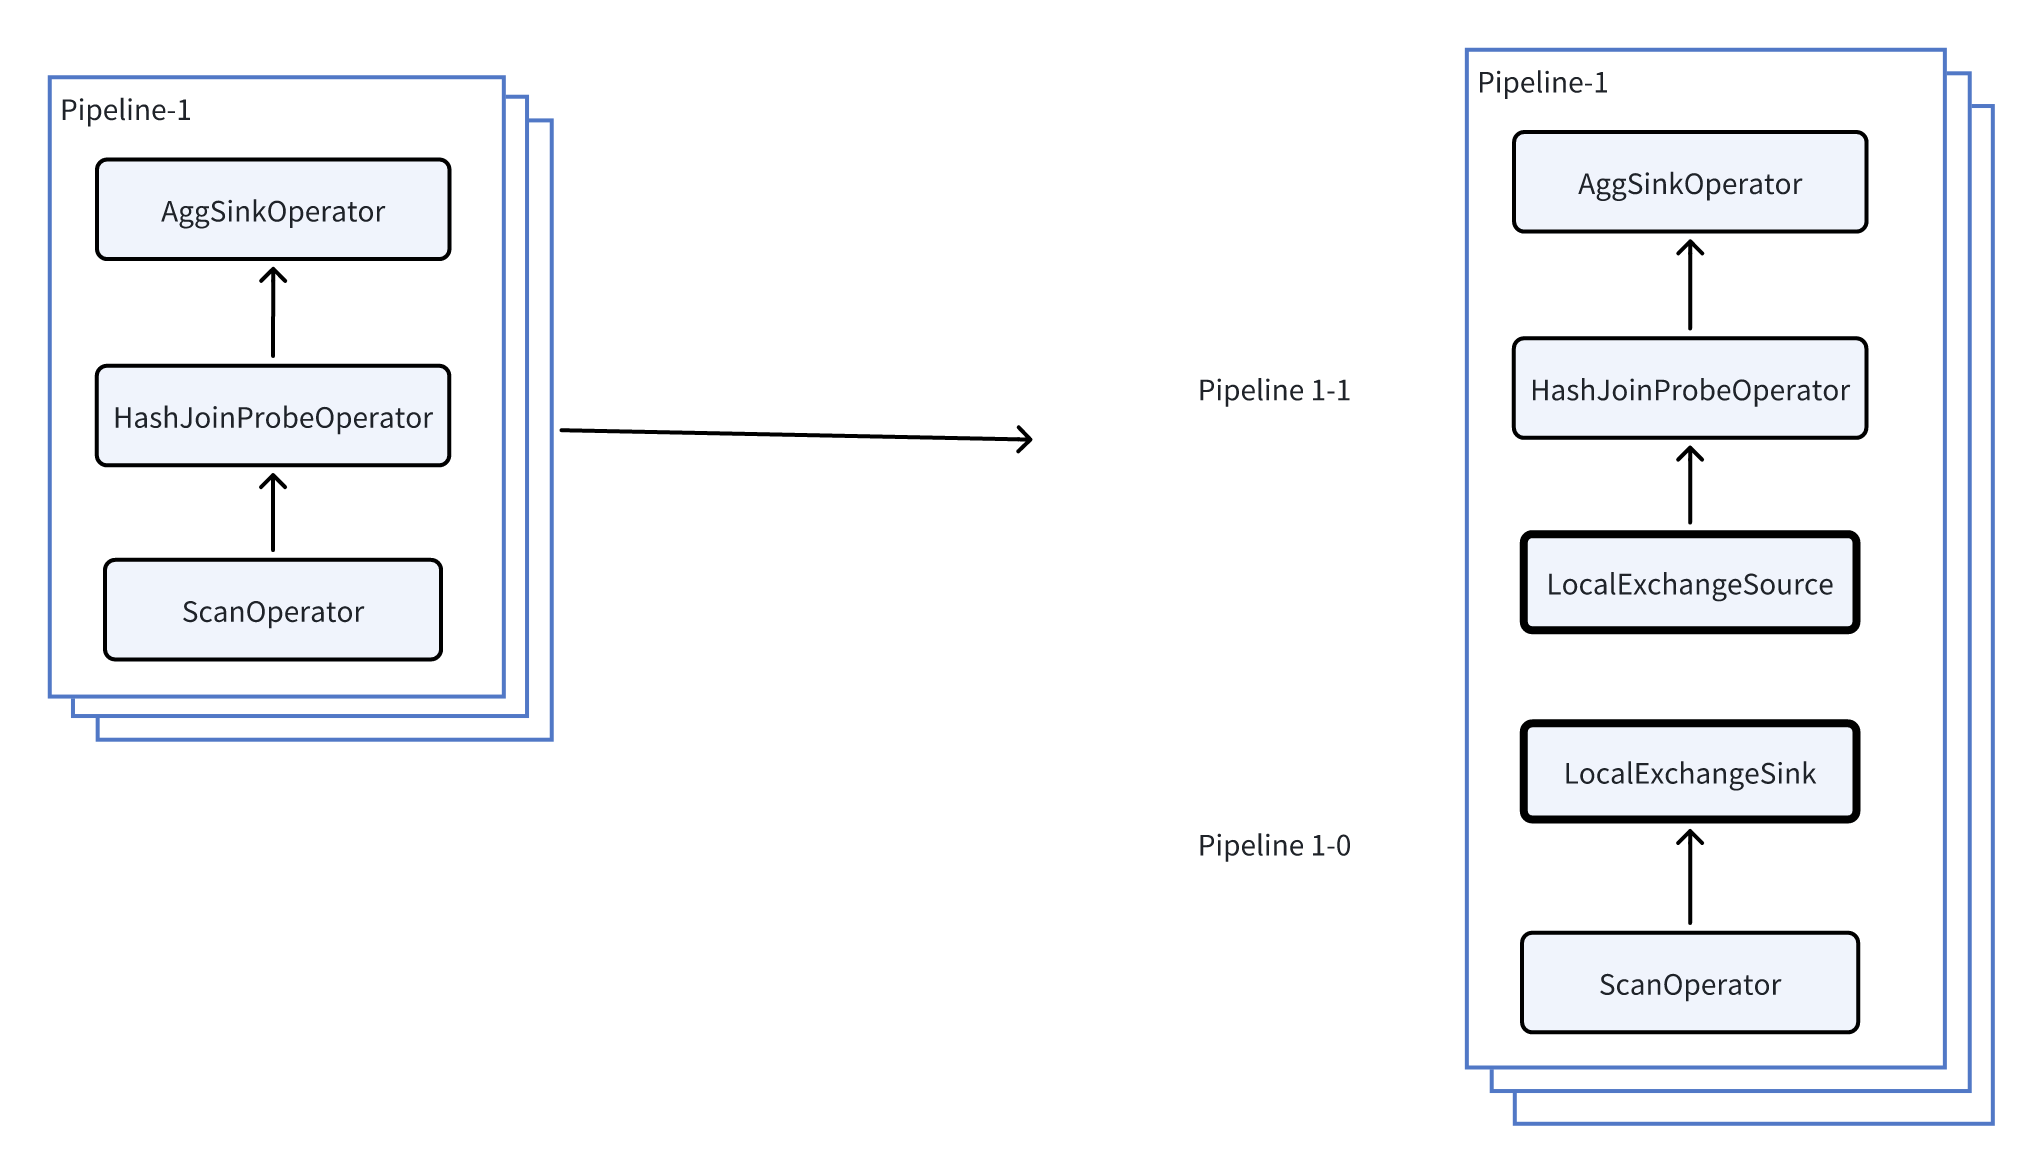
如上图所示,首先,通过在 Pipeline 1 中插入 Local Exchange,我们把 Pipeline 1 进一步拆分成 Pipeline 1-0 和 Pipeline 1-1。 此时,我们不妨假设当前并发等于 3(每个 Pipeline 有 3 个 task),每个 task 读取存储层的一个 bucket,而 3 个 bucket 中数据行数分别是 1,1,7。则插入 Local Exchange 前后的执行变化如下:
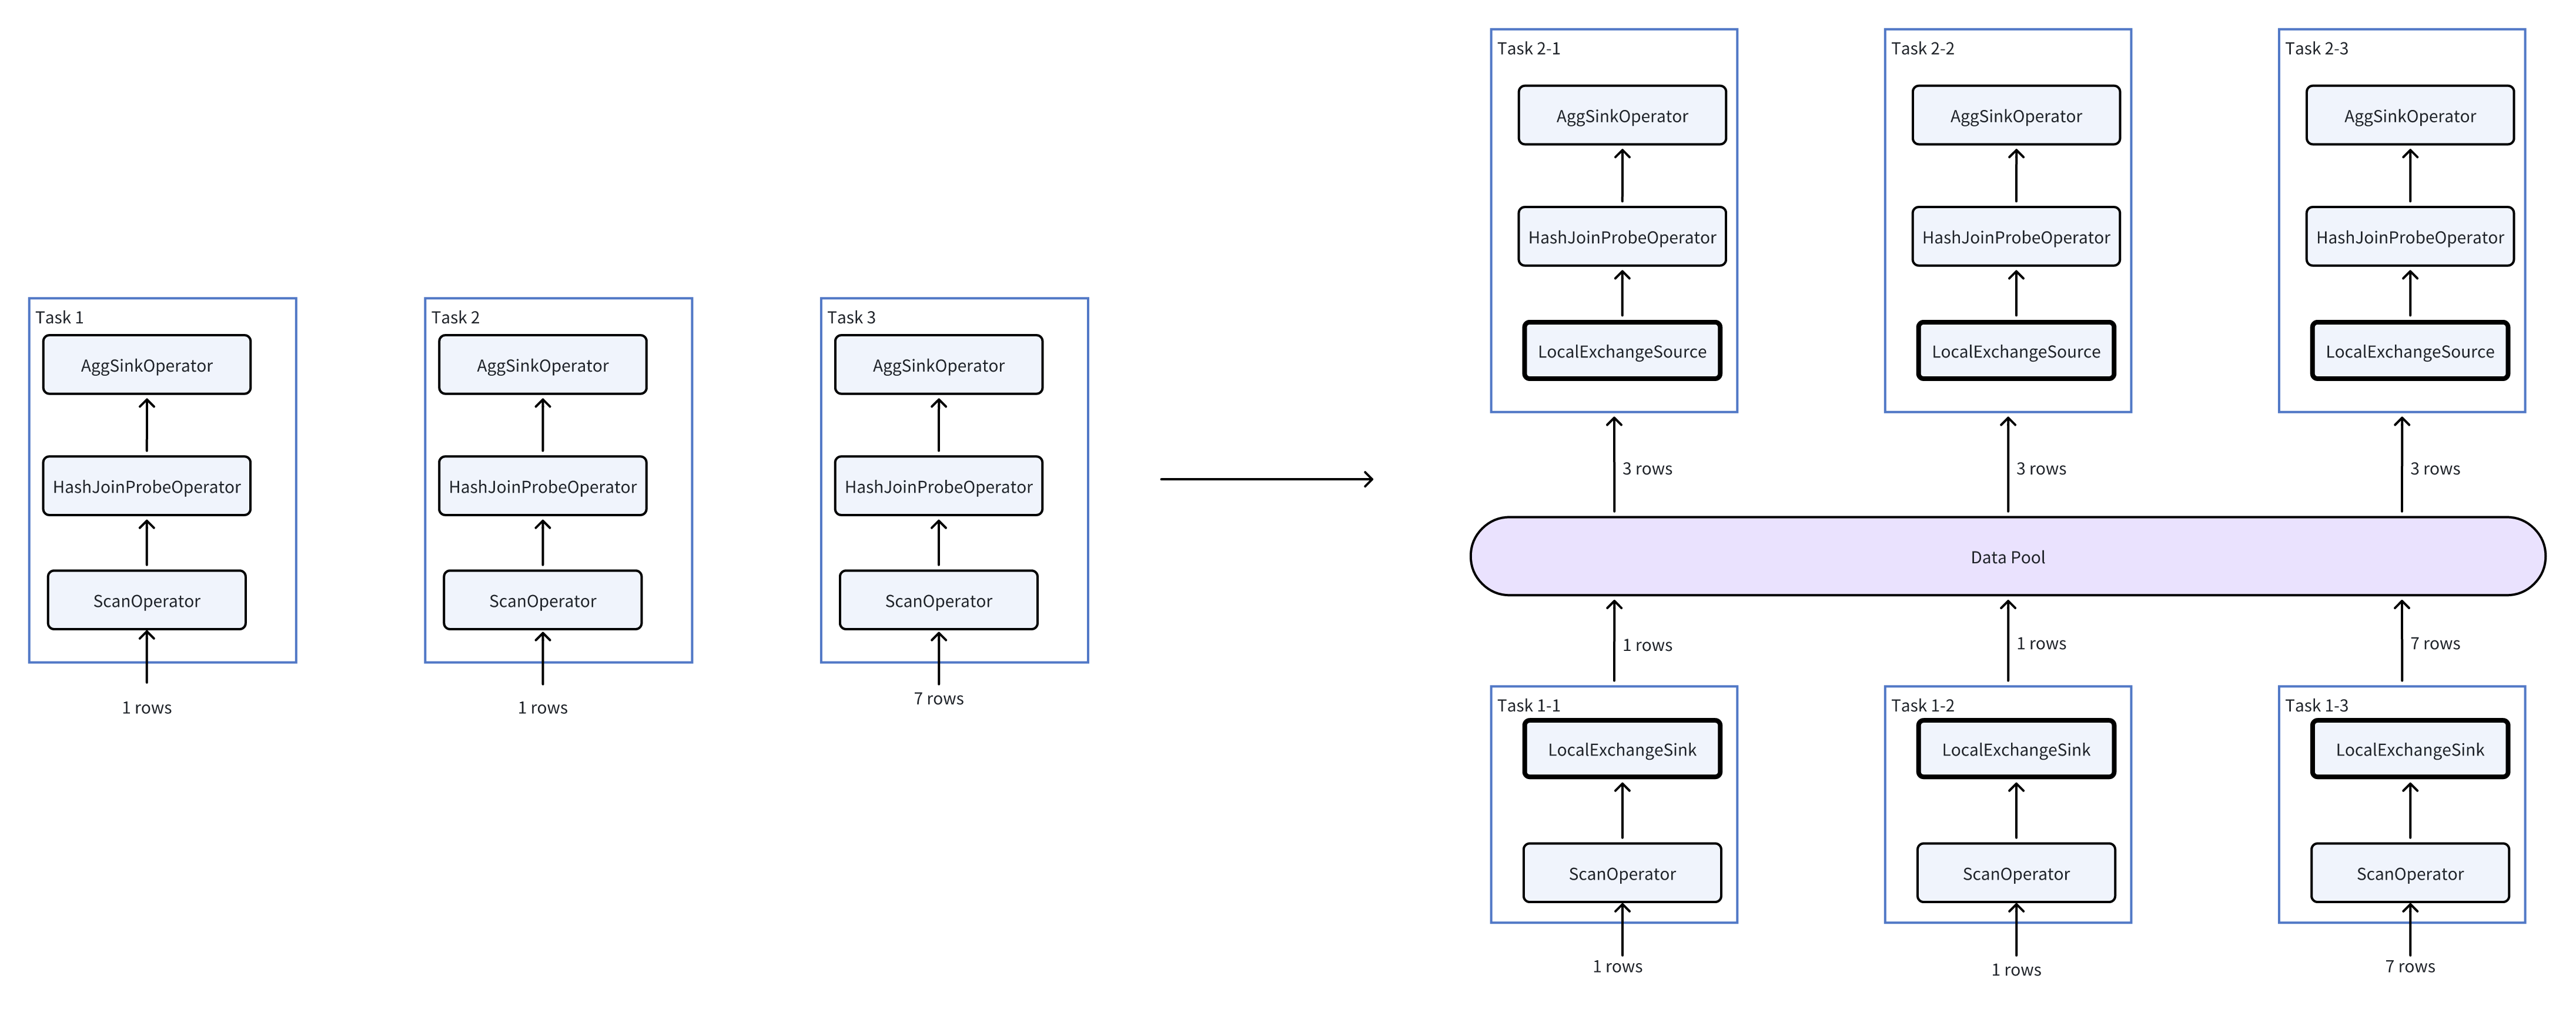
从图右可以看出,HashJoin 和 Agg 算子需要处理的数据量从 (1, 1, 7) 变成了 (3, 3, 3),从而避免了数据倾斜。 在 Doris 中,Local Exchange 根据一系列规则来决定是否被规划,例如当查询耗时比较大的 Join、聚合、窗口函数等算子需要被执行时,我们就需要使用 Local Exchange 来尽可能避免数据倾斜。
