Apache Doris 简介
Apache Doris 简介
Apache Doris 是一款基于 MPP 架构的高性能、实时分析型数据库。它以高效、简单和统一的特性著称,能够在亚秒级的时间内返回海量数据的查询结果。Doris 既能支持高并发的点查询场景,也能支持高吞吐的复杂分析场景。
基于这些优势,Apache Doris 非常适合用于报表分析、即席查询、统一数仓构建、数据湖联邦查询加速等场景。用户可以基于 Doris 构建大屏看板、用户行为分析、AB 实验平台、日志检索分析、用户画像分析、订单分析等应用。
发展历程
Apache Doris 最初是百度广告报表业务的 Palo 项目。2017 年正式对外开源,2018 年 7 月由百度捐赠给 Apache 基金会进行孵化。在 Apache 导师的指导下,由孵化器项目管理委员会成员进行孵化和运营。2022 年 6 月,Apache Doris 成功从 Apache 孵化器毕业,正式成为 Apache 顶级项目(Top-Level Project,TLP)。
目前,Apache Doris 社区已经聚集了来自不同行业数百家企业的 700 余位贡献者,并且每月活跃贡献者人数超过 120 位。
应用现状
Apache Doris 在中国乃至全球范围内拥有广泛的用户群体。截至目前,Apache Doris 已经在全球超过 5000 家中大型企业的生产环境中得到应用。在中国市值或估值排行前 50 的互联网公司中,有超过 80% 长期使用 Apache Doris,包括百度、美团、小米、京东、字节跳动、阿里巴巴、腾讯、网易、快手、微博等。同时,在金融、消费、电信、工业制造、能源、医疗、政务等传统行业也有着丰富的应用。
在中国,几乎所有的云厂商,如阿里云、华为云、天翼云、腾讯云、百度云、火山引擎等,都在提供托管的 Apache Doris 云服务。
使用场景
数据源经过各种数据集成和加工处理后,通常会进入实时数据仓库 Doris 和离线湖仓(如 Hive、Iceberg 和 Hudi),广泛应用于 OLAP 分析场景,如下图所示:

Apache Doris 主要应用于以下场景:
-
实时数据分析:
-
实时报表与实时决策: 为企业内外部提供实时更新的报表和仪表盘,支持自动化流程中的实时决策需求。
-
交互式探索分析: 提供多维数据分析能力,支持对数据进行快速的商业智能分析和即席查询(Ad Hoc),帮助用户在复杂数据中快速发现洞察。
-
用户行为与画像分析: 分析用户参与、留存、转化等行为,支持人群洞察和人群圈选等画像分析场景。
-
-
湖仓融合分析:
-
湖仓查询加速: 通过高效的查询引擎加速湖仓数据的查询。
-
多源联邦分析: 支持跨多个数据源的联邦查询,简化架构并消除数据孤岛。
-
实时数据处理: 结合实时数据流和批量数据的处理能力,满足高并发和低延迟的复杂业务需求。
-
-
半结构化数据分析:
- 日志与事件分析: 对分布式系统中的日志和事件数据进行实时或批量分析,帮助定位问题和优化性能。
整体架构
Apache Doris 采用 MySQL 协议,高度兼容 MySQL 语法,支持标准 SQL。用户可以通过各类客户端工具访问 Apache Doris,并支持与 BI 工具无缝集成。在部署 Apache Doris 时,可以根据硬件环境与业务需求选择存算一体架构或存算分离架构。
存算一体架构
Apache Doris 存算一体架构精简且易于维护。它包含以下两种类型的进程:
-
Frontend (FE): 主要负责接收用户请求、查询解析和规划、元数据管理以及节点管理。
-
Backend (BE): 主要负责数据存储和查询计划的执行。数据会被切分成数据分片(Shard),在 BE 中以多副本方式存储。
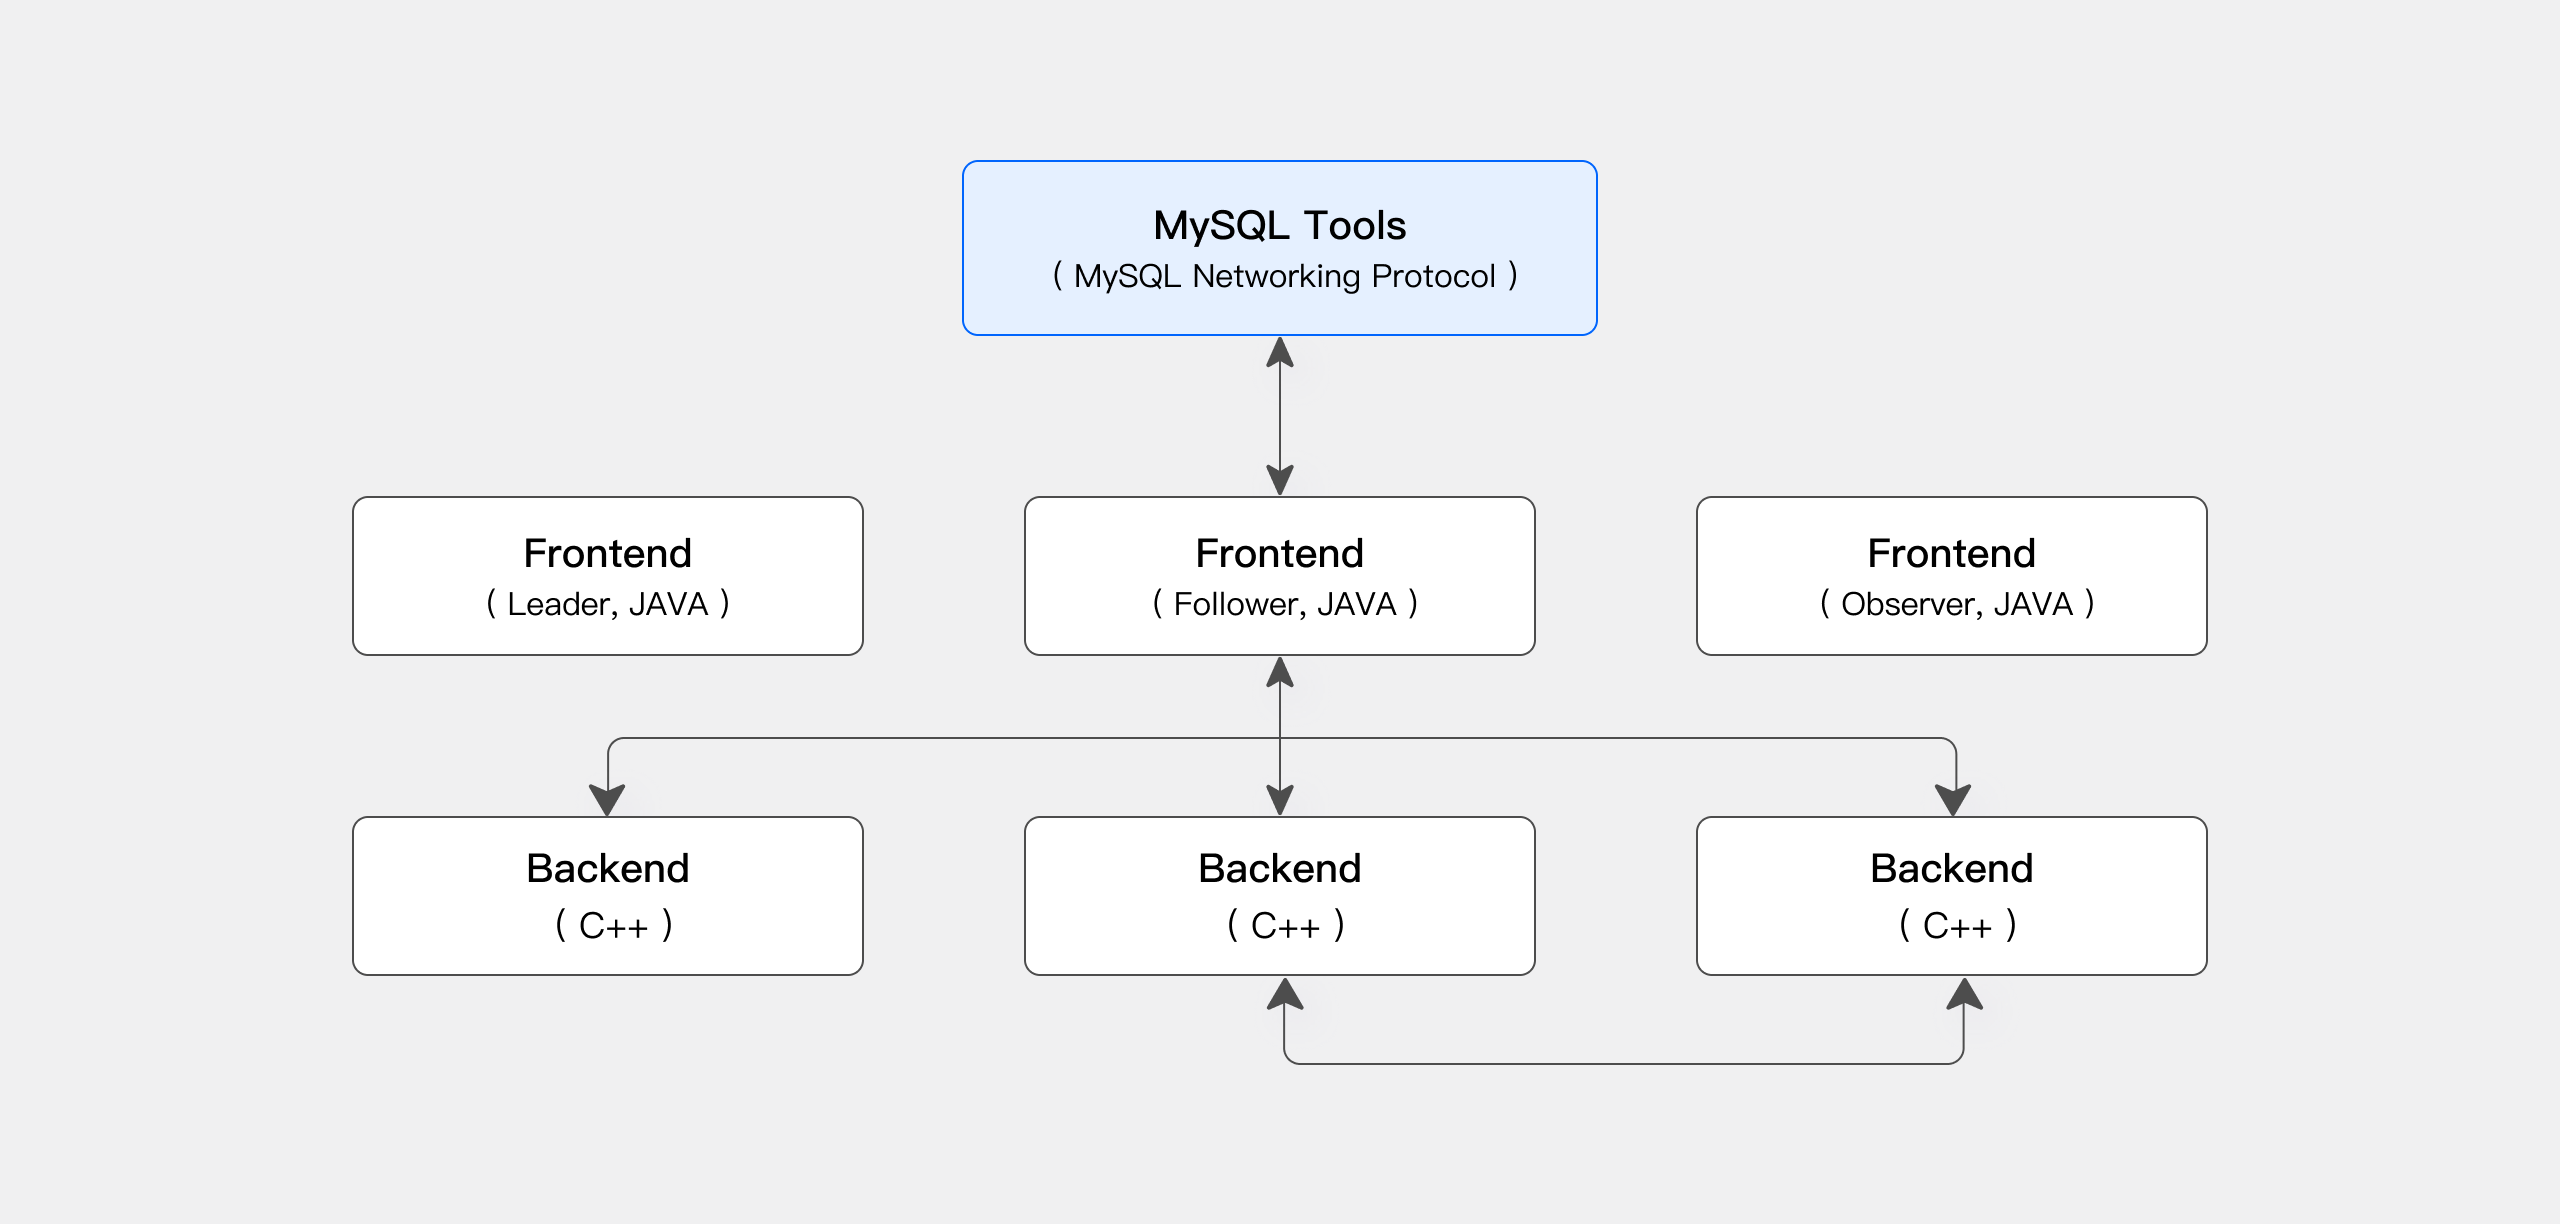
在生产环境中,可以部署多个 FE 节点以实现容灾备份。每个 FE 节点都会维护完整的元数据副本。FE 节点分为以下三种角色:
| 角色 | 功能 |
|---|---|
| Master | FE Master 节点负责元数据的读写。当 Master 节点的元数据发生变更后,会通过 BDB JE 协议同步给 Follower 或 Observer 节点。 |
| Follower | Follower 节点负责读取元数据。当 Master 节点发生故障时,可以选取一个 Follower 节点作为新的 Master 节点。 |
| Observer | Observer 节点负责读取元数据,主要目的是增加集群的查询并发能力。Observer 节点不参与集群的选主过程。 |
FE 和 BE 进程都可以横向扩展。单个集群可以支持数百台机器和数十 PB 的存储容量。FE 和 BE 进程通过一致性协议来保证服务的高可用性和数据的高可靠性。存算一体架构高度集成,大幅降低了分布式系统的运维成本。
存算分离架构
从 3.0 版本开始,可以选择存算分离部署架构。Apache Doris 存算分离版使用统一的共享存储层作为数据存储空间。存储和计算分离后,用户可以独立扩展存储容量和计算资源,从而实现最佳性能和成本效益。存算分离架构分为以下三层:
-
元数据层: 负责请求规划、查询解析以及元数据的存储和管理。
-
计算层: 由多个计算组组成。每个计算组可以作为一个独立的租户承担业务计算。每个计算组包含多个无状态的 BE 节点,可以随时弹性伸缩 BE 节点。
-
存储层: 可以使用 S3、HDFS、OSS、COS、OBS、Minio、Ceph 等共享存储来存放 Doris 的数据文件,包括 Segment 文件和反向索引文件等。

Apache Doris 的核心特性
-
高可用: Apache Doris 的元数据和数据均采用多副本存储,并通过 Quorum 协议同步数据日志。当大多数副本完成写入后,即认为数据写入成功,从而确保即使少数节点发生故障,集群仍能保持可用性。Apache Doris 支持同城和异地容灾,能够实现双集群主备模式。当部分节点发生异常时,集群可以自动隔离故障节点,避免影响整体集群的可用性。
-
高兼容: Apache Doris 高度兼容 MySQL 协议,支持标准 SQL 语法,涵盖绝大部分 MySQL 和 Hive 函数。通过这种高兼容性,用户可以无缝迁移和集成现有的应用和工具。Apache Doris 支持 MySQL 生态,用户可以通过 MySQL 客户端工具连接 Doris,使得操作和维护更加便捷。同时,可以使用 MySQL 协议对 BI 报表工具与数据传输工具进行兼容适配,确保数据分析和数据传输过程中的高效性和稳定性。
-
实时数仓: 基于 Apache Doris 可以构建实时数据仓库服务。Apache Doris 提供了秒级数据入库能力,上游在线联机事务库中的增量变更可以秒级捕获到 Doris 中。依靠向量化引擎、MPP 架构及 Pipeline 执行引擎等加速手段,可以提供亚秒级数据查询能力,从而构建高性能、低延迟的实时数仓平台。
-
湖仓一体: Apache Doris 可以基于外部数据源(如数据湖或关系型数据库)构建湖仓一体架构,从而解决数据在数据湖和数据仓库之间无缝集成和自由流动的问题,帮助用户直接利用数据仓库的能力来解决数据湖中的数据分析问题,同时充分利用数据湖的数据管理能力来提升数据的价值。
-
灵活建模: Apache Doris 提供多种建模方式,如宽表模型、预聚合模型、星型/雪花模型等。数据导入时,可以通过 Flink、Spark 等计算引擎将数据打平成宽表写入到 Doris 中,也可以将数据直接导入到 Doris 中,通过视图、物化视图或实时多表关联等方式进行数据的建模操作。
技术特点
Doris 提供了高效的 SQL 接口,并完全兼容 MySQL 协议。其查询引擎基于 MPP(大规模并行处理)架构,能够高效执行复杂的分析查询,并实现低延迟的实时查询。通过列式存储技术对数据进行编码与压缩,显著优化了查询性能和存储压缩比。
使用接口
Apache Doris 采用 MySQL 协议,高度兼容 MySQL 语法,支持标准 SQL。用户可以通过各类客户端工具访问 Apache Doris,并支持与 BI 工具无缝集成。Apache Doris 当前支持多种主流的 BI 产品,包括 Smartbi、DataEase、FineBI、Tableau、Power BI、Apache Superset 等。只要支持 MySQL 协议的 BI 工具,Apache Doris 就可以作为数据源提供查询支持。
存储引擎
在存储引擎方面,Apache Doris 采用列式存储,按列进行数据的编码、压缩和读取,能够实现极高的压缩比,同时减少大量非相关数据的扫描,从而更有效地利用 IO 和 CPU 资源。
Apache Doris 也支持多种索引结构,以减少数据的扫描:
-
Sorted Compound Key Index: 最多可以指定三个列组成复合排序键。通过该索引,能够有效进行数据裁剪,从而更好地支持高并发的报表场景。
-
Min/Max Index: 有效过滤数值类型的等值和范围查询。
-
BloomFilter Index: 对高基数列的等值过滤裁剪非常有效。
-
Inverted Index: 能够对任意字段实现快速检索。
在存储模型方面,Apache Doris 支持多种存储模型,针对不同的场景做了针对性的优化:
-
明细模型(Duplicate Key Model): 适用于事实表的明细数据存储。
-
主键模型(Unique Key Model): 保证 Key 的唯一性,相同 Key 的数据会被覆盖,从而实现行级别数据更新。
-
聚合模型(Aggregate Key Model): 相同 Key 的 Value 列会被合并,通过提前聚合大幅提升性能。
Apache Doris 也支持强一致的单表物化视图和异步刷新的多表物化视图。单表物化视图在系统中自动刷新和维护,无需用户手动选择。多表物化视图可以借助集群内的调度或集群外的调度工具定时刷新,从而降低数据建模的复杂性。
查询引擎
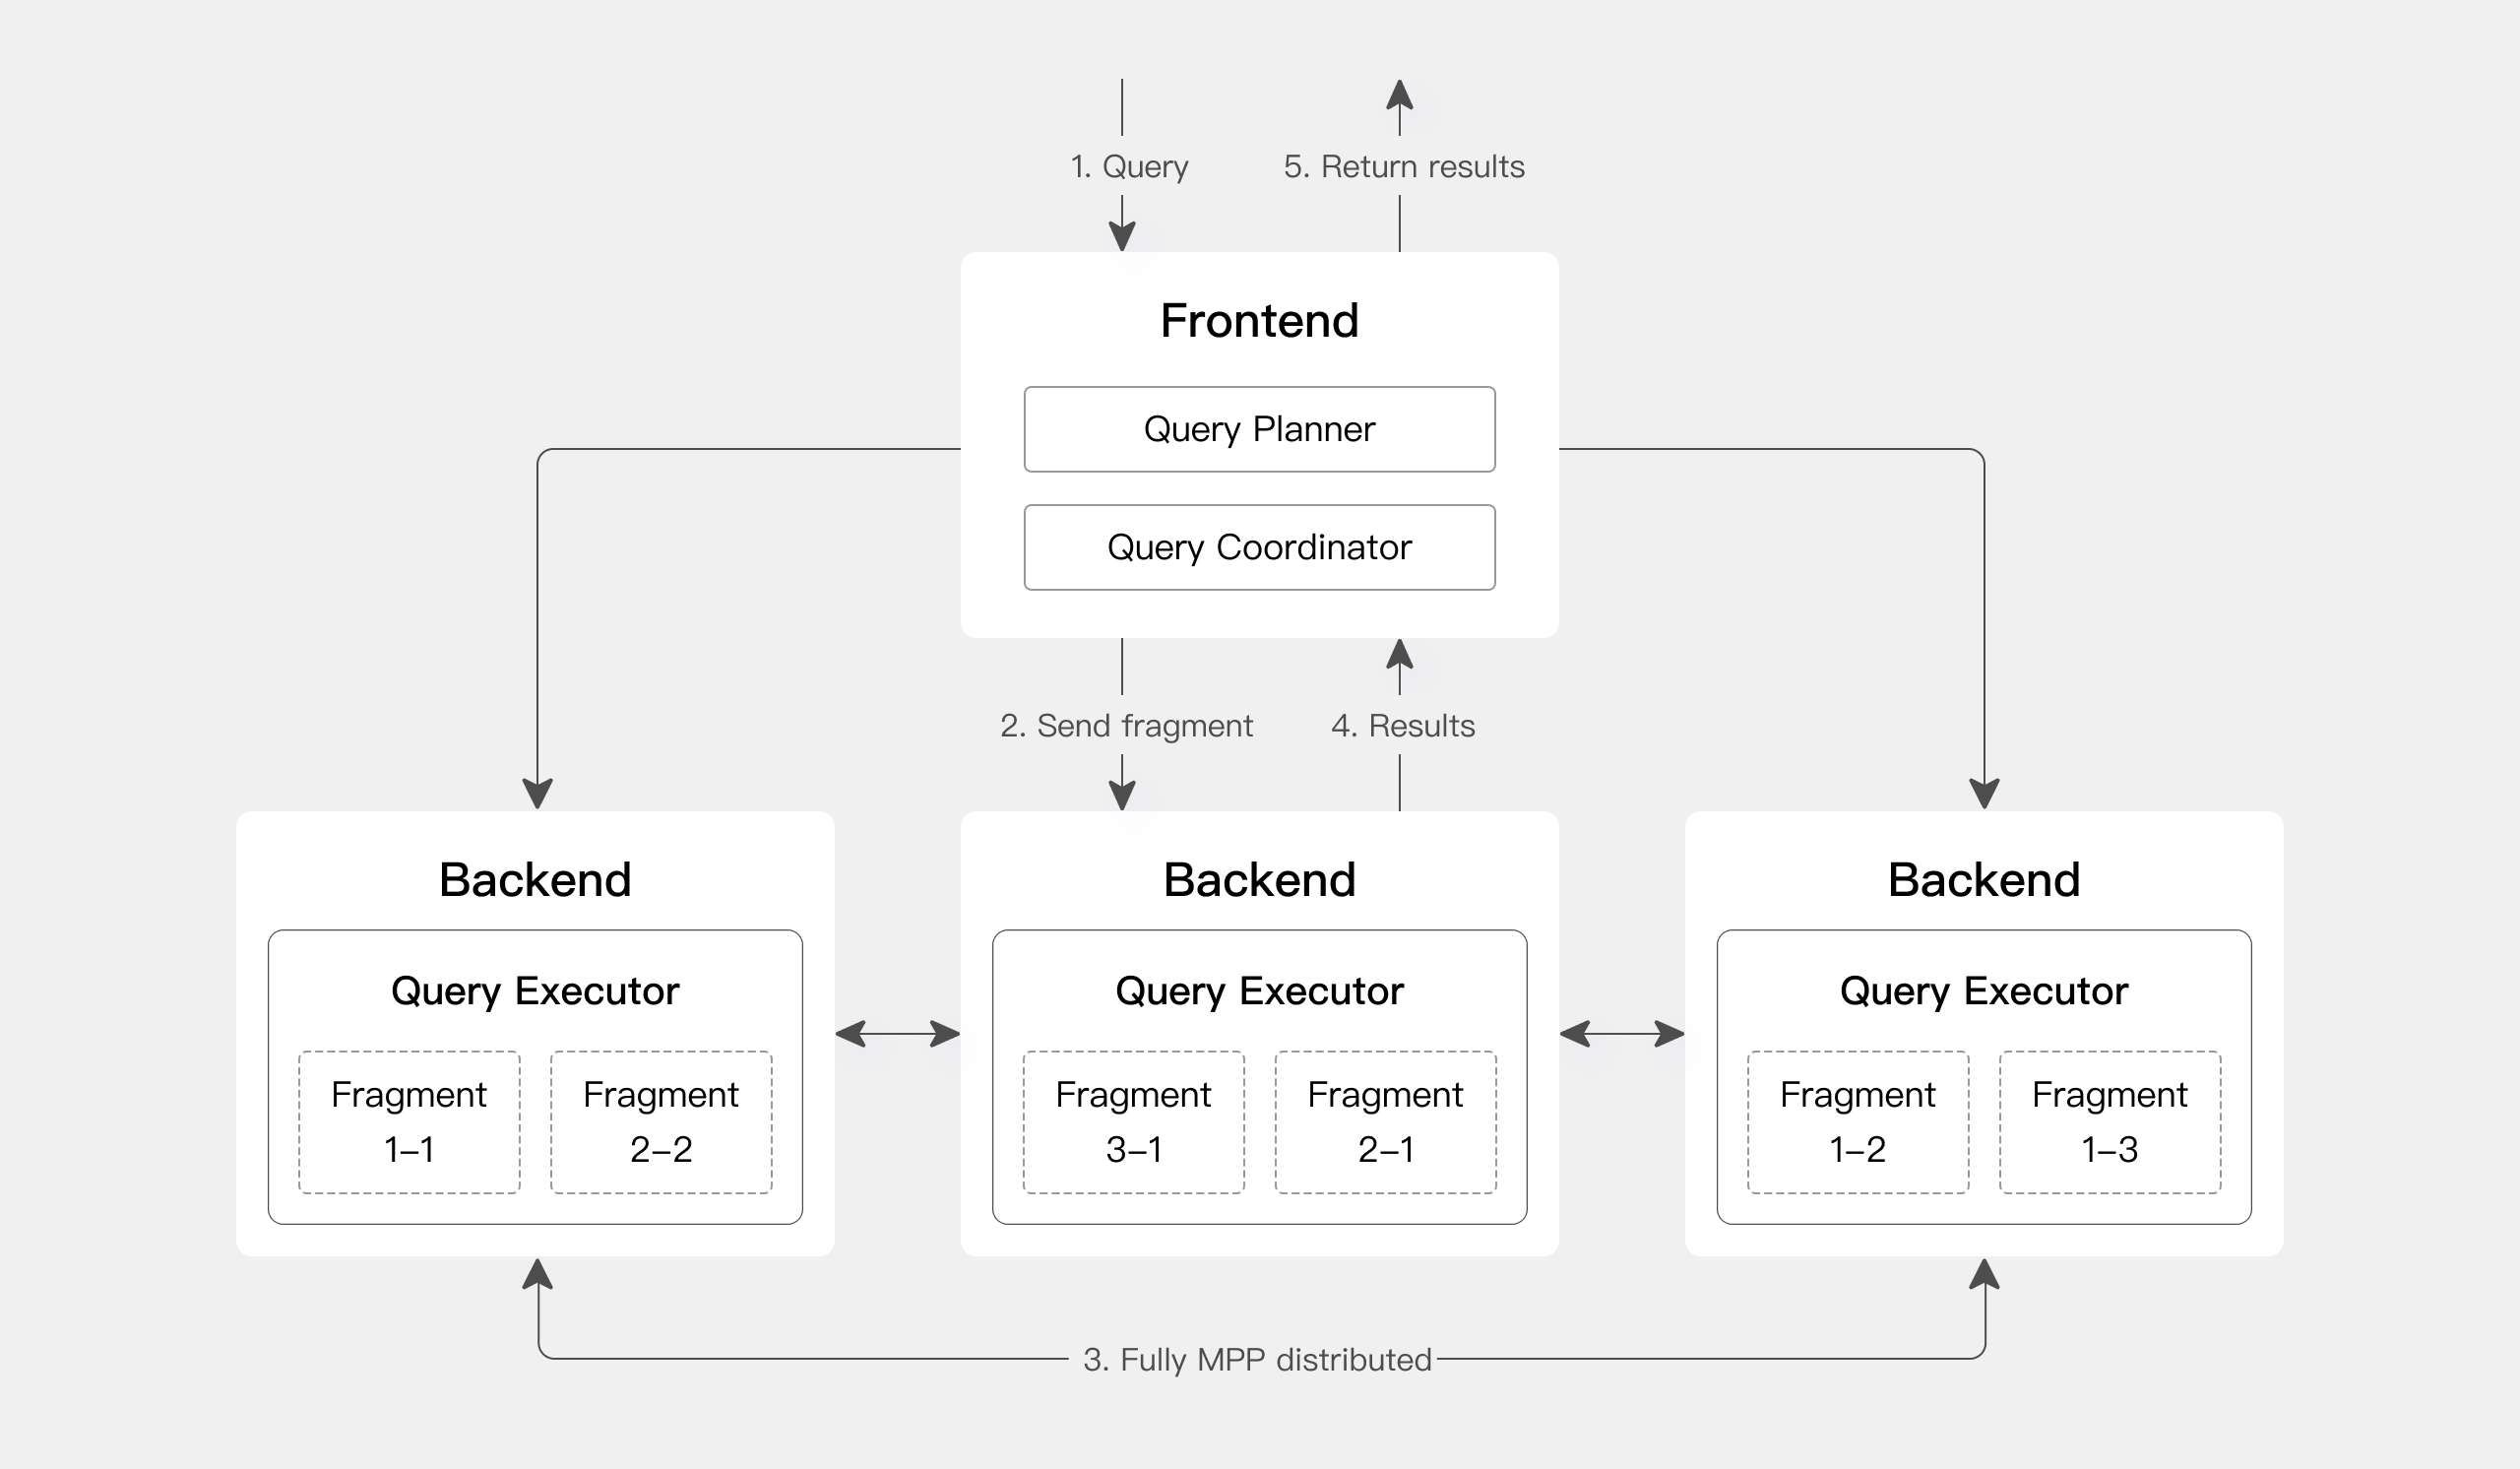
Apache Doris 采用大规模并行处理(MPP)架构,支持节点间和节点内并行执行,以及多个大型表的分布式 Shuffle Join,从而更好地应对复杂查询。
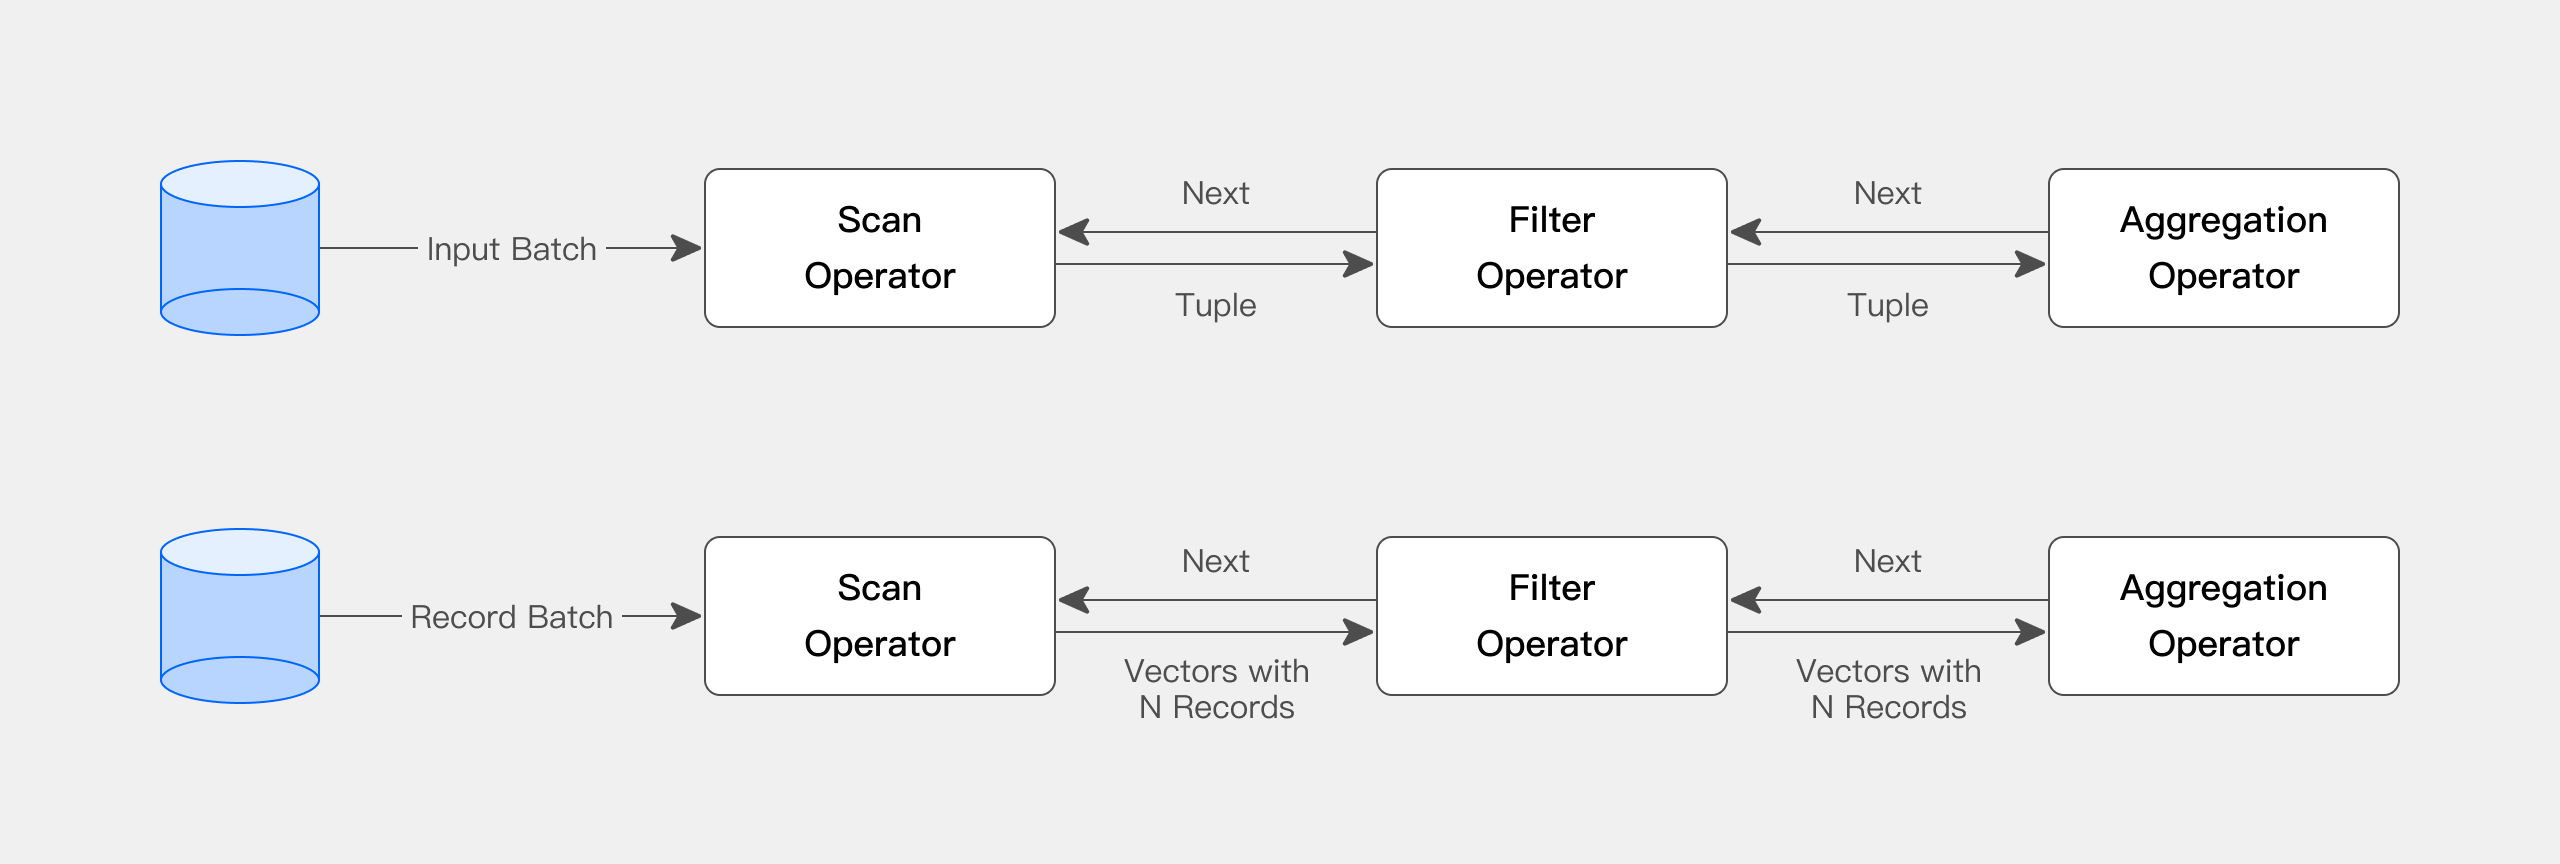
Doris 查询引擎是向量化引擎,所有内存结构均按列式布局,可显著减少虚函数调用,提高缓存命中率,并有效利用 SIMD 指令。在宽表聚合场景下,性能是非向量化引擎的 5-10 倍。
Doris 采用自适应查询执行(Adaptive Query Execution)技术,根据运行时统计信息动态调整执行计划。例如,通过运行时过滤(Runtime Filter)技术,可以在运行时生成过滤器并将其推送到 Probe 端,并自动将过滤器穿透到 Probe 端最底层的 Scan 节点,从而大幅减少 Probe 端的数据量,加速 Join 性能。Doris 的运行时过滤器支持 In/Min/Max/Bloom Filter。
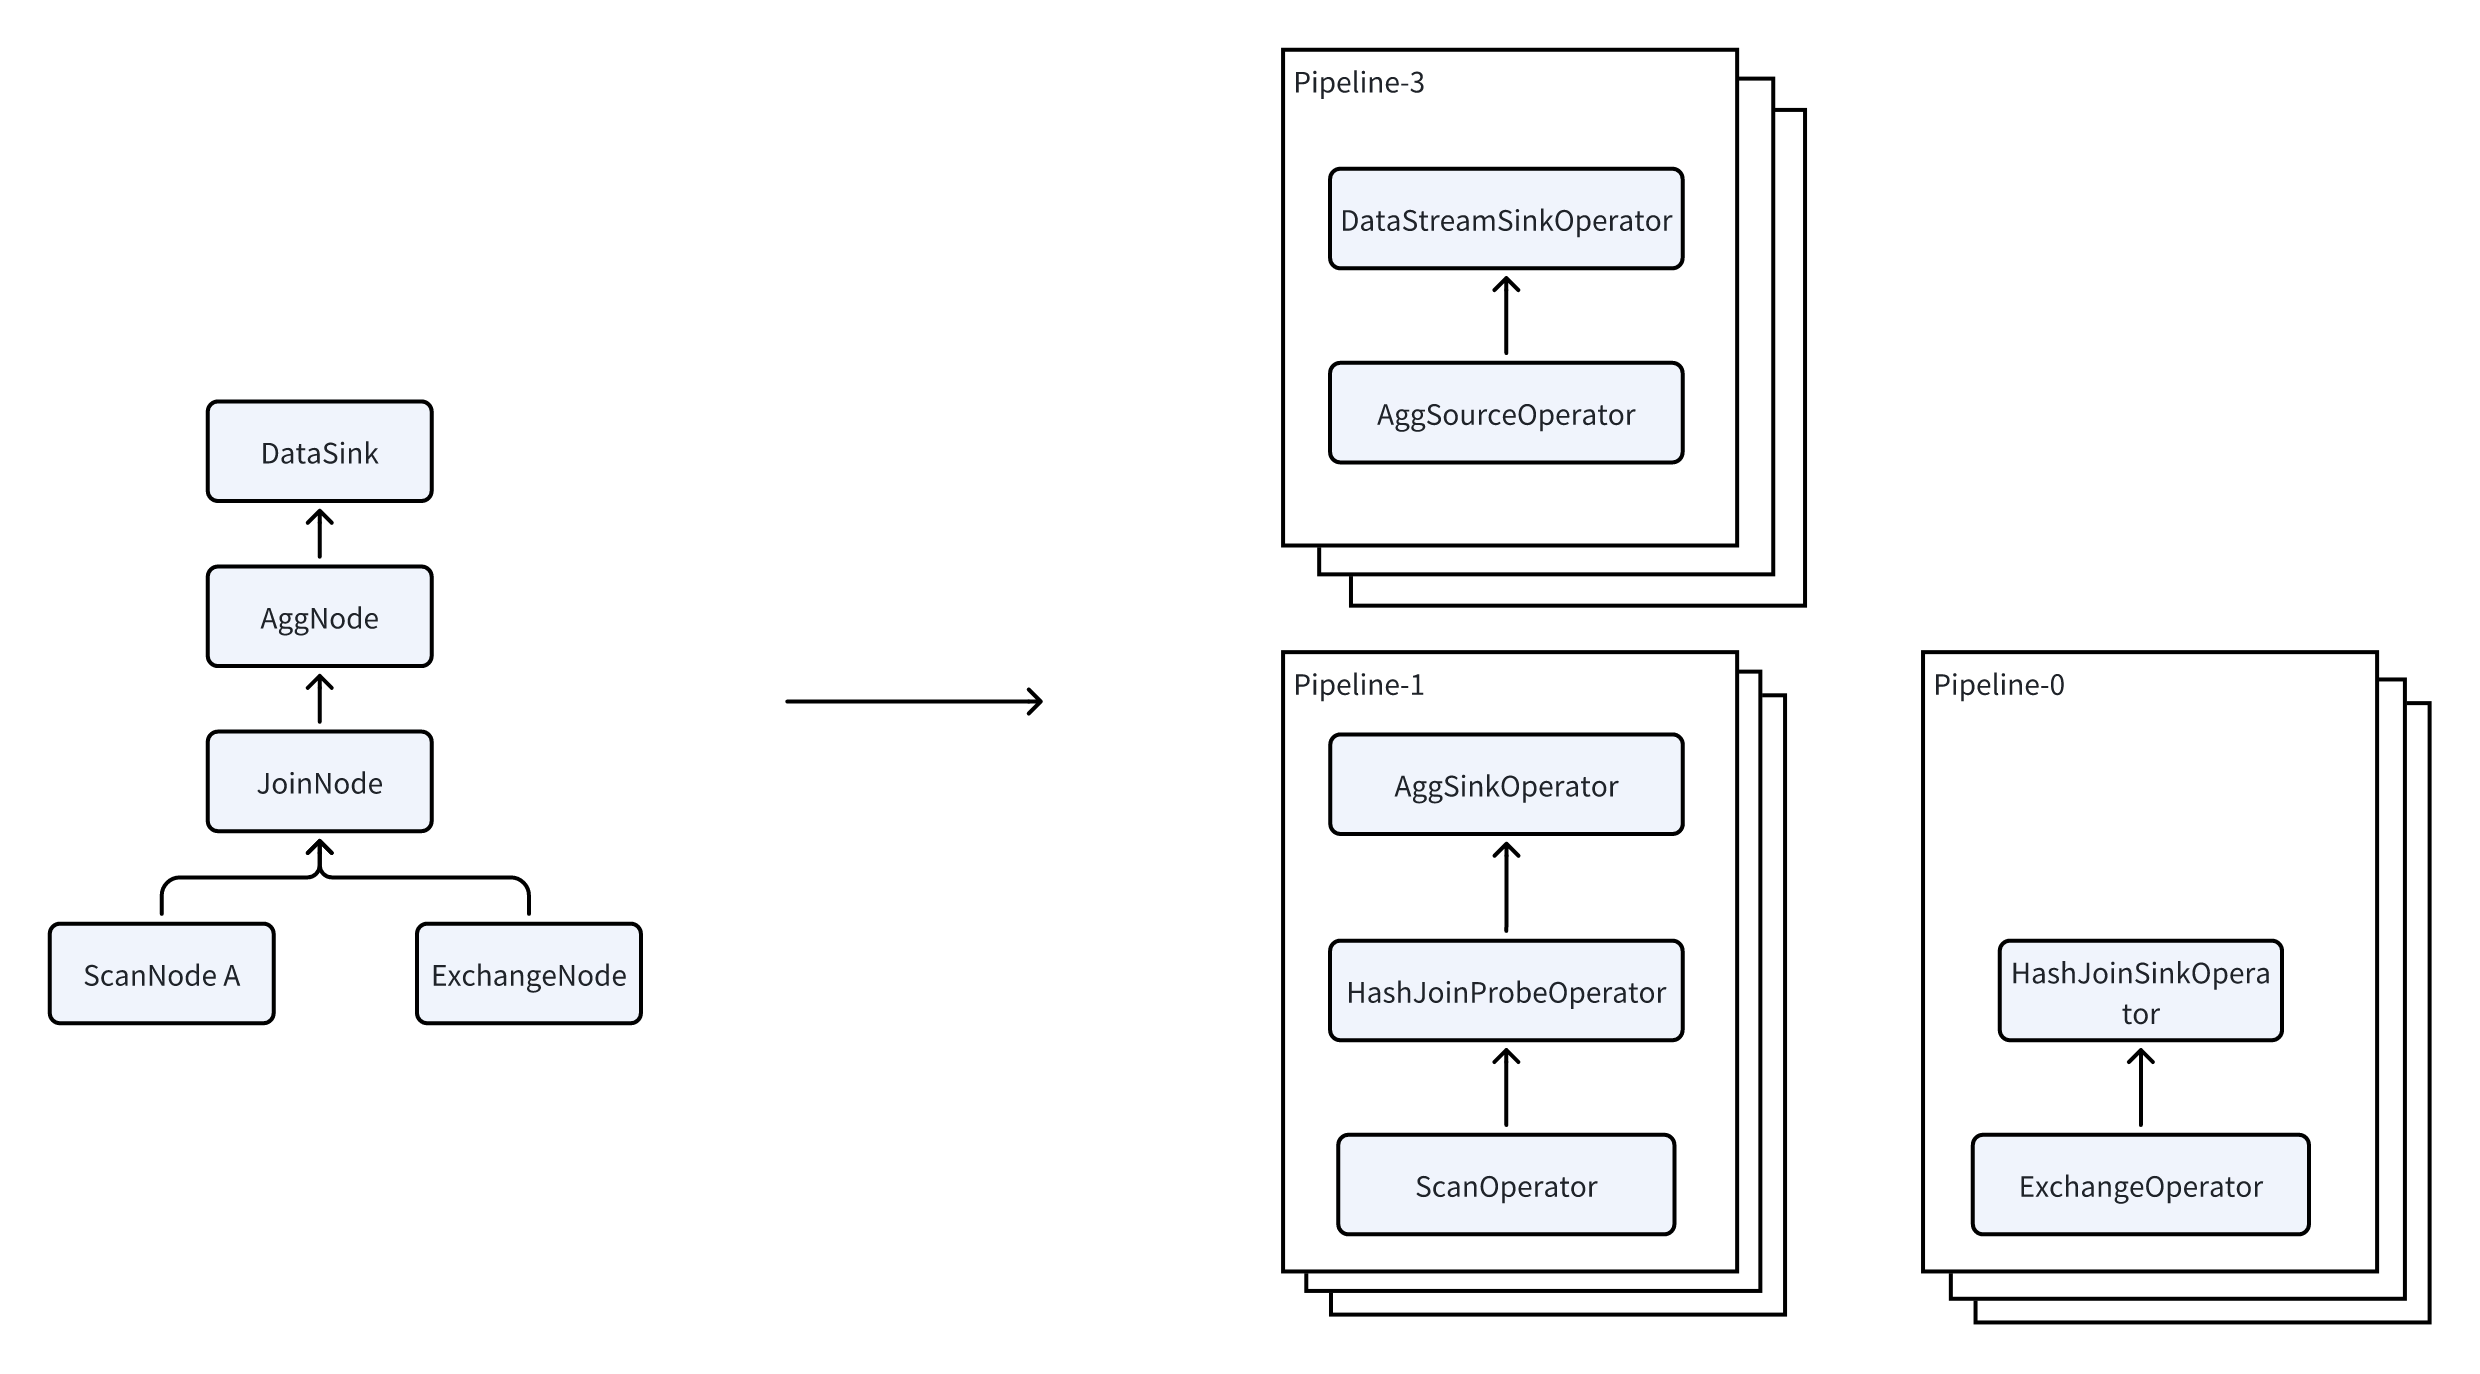
Doris 使用 Pipeline 执行引擎,将查询分解为多个子任务并行执行,充分利用多核 CPU 的能力,同时通过限制查询线程数来解决线程膨胀问题。Pipeline 执行引擎减少数据拷贝和共享,优化排序和聚合操作,从而显著提高查询效率和吞吐量。
在优化器方面,Doris 采用 CBO、RBO 和 HBO 相结合的优化策略。RBO 支持常量折叠、子查询重写和谓词下推等优化,CBO 支持 Join Reorder 等优化,HBO 能够基于历史查询信息推荐最优执行计划。多种优化措施确保 Doris 能够在各类查询中枚举出性能优异的查询计划。
