系统架构
本文档介绍 Apache Doris 的系统架构,包括两种部署模式的核心组件及其交互逻辑:
- 存算一体架构:FE + BE 经典架构,数据存储与计算融合
- 存算分离架构:元数据层、计算层、存储层三层分离
适用场景: 选型评估 · 架构学习 · 运维理解
存算一体架构
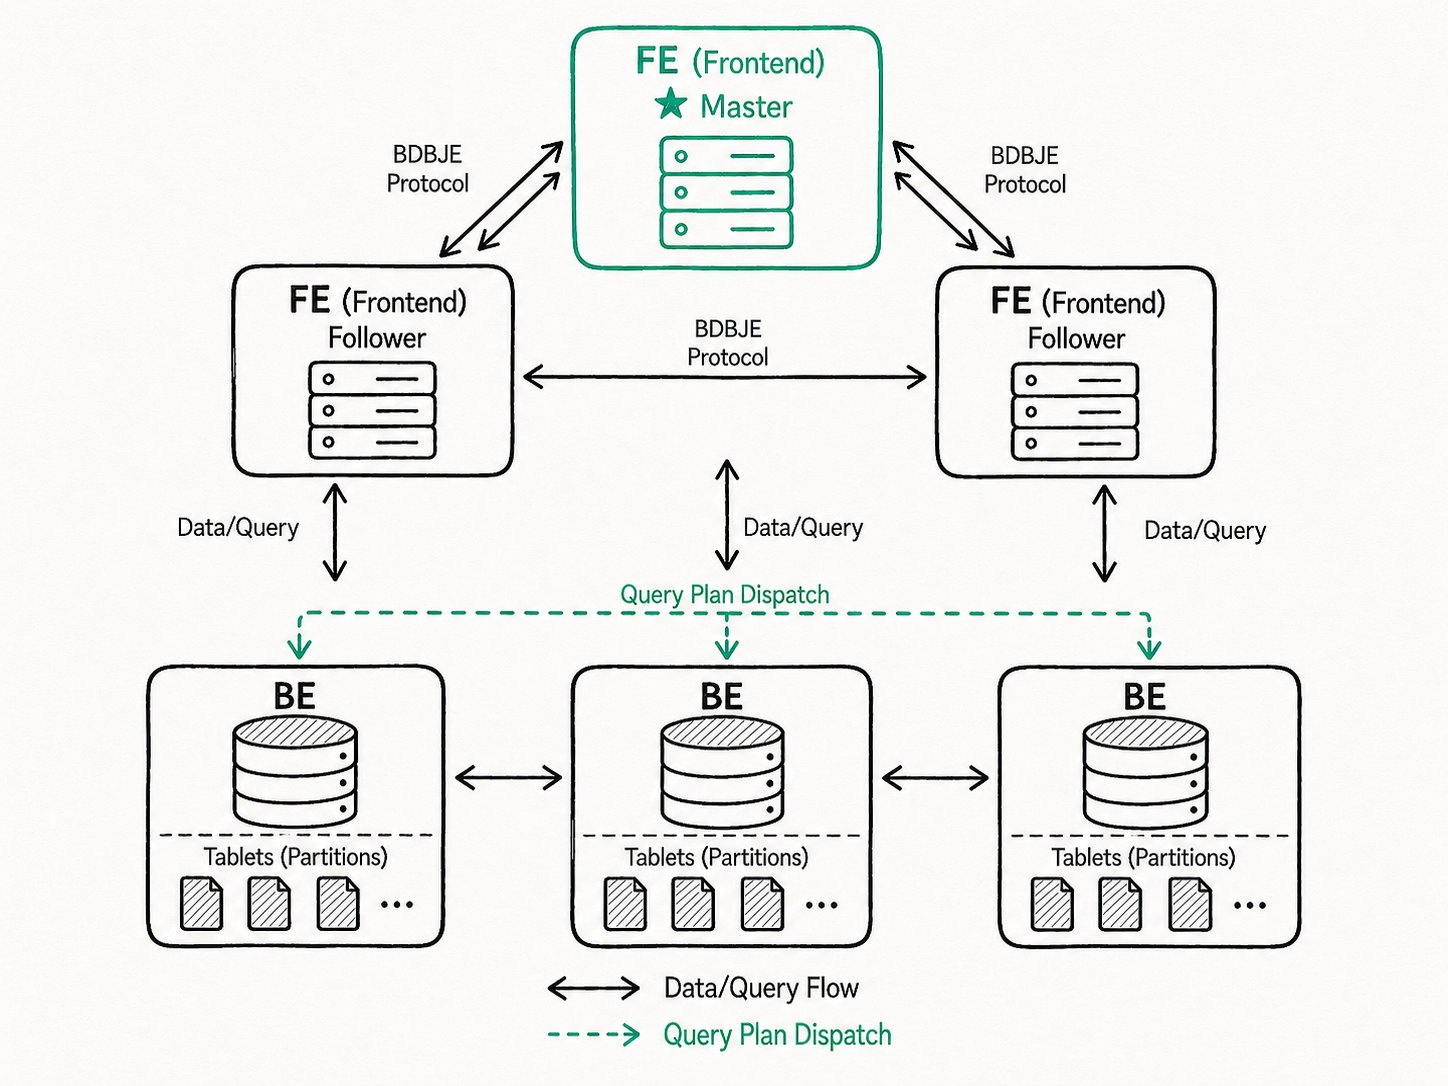
存算一体架构是 Apache Doris 的经典部署模式,由 Frontend(FE) 和 Backend(BE) 两类进程组成。
核心组件
Frontend(FE)节点
FE 是 Apache Doris 的入口节点,承担协调和控制职能:
| 职责 | 说明 |
|---|---|
| 用户请求接入 | 兼容 MySQL 协议,支持标准 SQL |
| 查询解析与规划 | 词法分析 → 语义分析 → 生成逻辑计划 → CBO 优化 → 下发执行 |
| 元数据管理 | 库表结构、副本分布、用户权限、集群拓扑、导入状态 |
| 节点管理 | 心跳检测、负载均衡、副本修复、扩缩容管理 |
FE 采用 BDB JE 作为元数据存储引擎,支持事务特性。不依赖 ZooKeeper 等外部组件,简化部署和维护。
Backend(BE)节点
BE 是计算和存储节点:
| 特性 | 说明 |
|---|---|
| 列式存储 | 数据按列组织,配合编码压缩提升 I/O 效率 |
| 数据分片(Tablet) | 数据水平切分,是副本调度的最小单位 |
| 多副本 | 每 Tablet 默认 3 副本,分布在不同 BE 节点 |
| 向量化执行 | 列式内存布局 + SIMD 加速,宽表聚合性能 5~10x |
| Pipeline 引擎 | 多核并行 + 线程数限制,避免爆炸 |
FE 高可用
生产环境部署多个 FE 节点,角色类型如下:
| 角色 | 职责 | 是否参与选举 |
|---|---|---|
| Master | 元数据读写操作,同步到 Follower/Observer | 是 |
| Follower | 读取元数据,Master 故障时参与选举 | 是 |
| Observer | 读取元数据,仅扩展查询并发能力 | 否 |
元数据变更需多数派节点确认,保证一致性。
架构特点
- 简洁易维护:仅 FE + BE 两类进程
- 高性能:计算节点直接访问本地存储,网络开销低
- 高可用:多副本 + 故障自动隔离
- 水平扩展:FE/BE 均支持在线扩容
存算分离架构
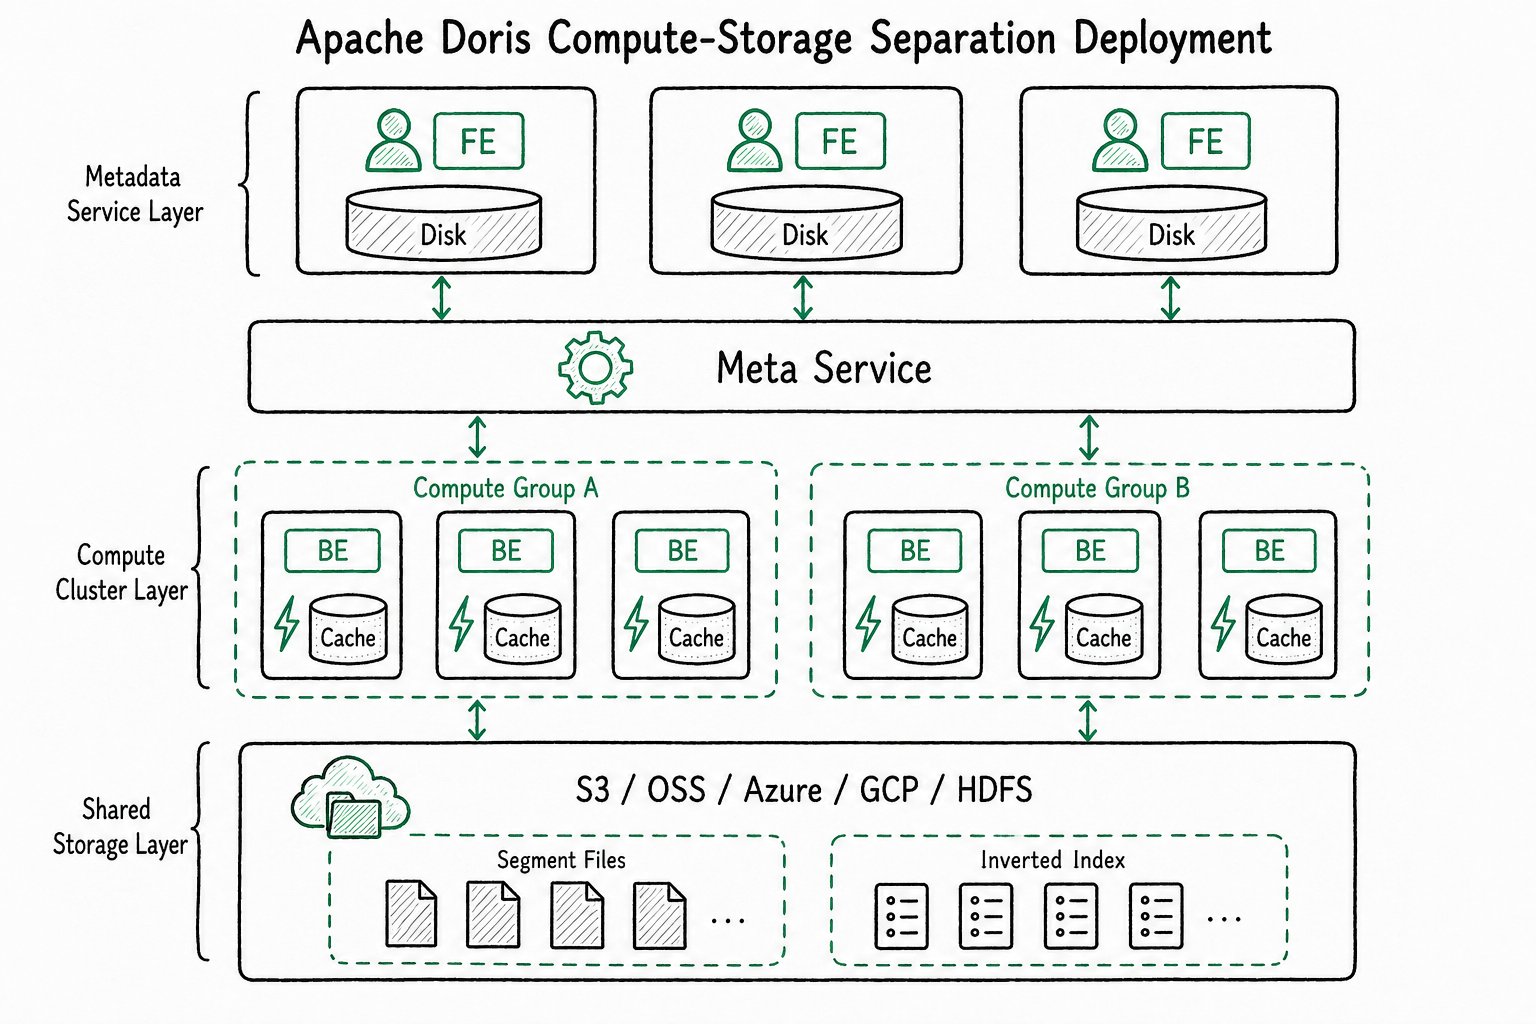
从 3.0 版本引入,计算层与存储层完全分离,支持独立弹性扩展。
核心组件
在存算分离架构中,FE 节点依然保留,承担用户请求接入和查询解析职责。同时新增了 Meta Service 专门负责数据层面的元数据管理。
FE 前端节点
FE 在存算分离架构中职责不变:
| 职责 | 说明 |
|---|---|
| 用户请求接入 | 兼容 MySQL 协议,支持标准 SQL,认证和权限验证 |
| 查询解析与规划 | 词法分析 → 语义分析 → 逻辑计划 → CBO 优化 → 下发执行 |
| SQL 层元数据 | 库表结构、用户权限、集群拓扑 |
元数据层(Meta Service)
无状态服务,可水平扩展。
| 职责 | 说明 |
|---|---|
| 数据导入事务 | 版本管理、冲突检测 |
| Tablet 元数据 | 数据版本、文件列表 |
| Rowset 元数据 | 增量数据信息,用于恢复和垃圾回收 |
| 集群资源 | 计算组资源分配和调度 |
计算层(Compute Layer)
由多个 计算组(Compute Cluster) 组成,每个计算组包含多个无状态 BE 节点。计算组之间共享同一份数据,但拥有独立的计算资源。
| 特性 | 说明 |
|---|---|
| 资源独立 | 各计算组独立服务不同业务 |
| 无状态 BE | 不持久存储,只缓存热点数据 |
| 弹性扩缩容 | 节点增减不影响其他计算组 |
| 本地缓存 | LRU 策略缓存热点数据,降低访问延迟 |
共享存储层(Storage Layer)
持久化所有数据文件,包括 Segment 文件和倒排索引文件。
| 支持类型 | 示例 |
|---|---|
| 对象存储 | S3、OSS、COS、OBS、MinIO |
| 分布式文件系统 | HDFS |
| Ceph | RGW、CephFS |
架构特点
- 弹性计算:资源按需扩展,适合波峰波谷业务
- 工作负载隔离:不同业务团队共享数据但计算资源独立
- 低存储成本:可使用对象存储等低成本方案
- 分钟级扩缩容:计算资源快速调整
选型对比
组件功能对比
两种架构在组件职责上存在以下差异:
| 对比项 | 存算一体 | 存算分离 |
|---|---|---|
| FE 节点 | 保留,存储所有元数据 | 保留,仅存储 SQL 层元数据 |
| BE 节点 | 有状态(存储数据) | 无状态(仅缓存热点数据) |
| 数据存储位置 | BE 本地磁盘 | 共享存储层,BE 本地磁盘做缓存 |
| 扩缩容重点 | 存储 + 计算同步扩缩 | 可独立扩缩计算或存储 |
| 存储成本 | 较高(SSD) | 较低(对象存储) |
| 运维复杂度 | 较低 | 较高(依赖外部存储) |
| 查询延迟 | 更低(本地 I/O) | 略高(未命中缓存时)。命中缓存情况下,延迟和存算分离一致。 |
选型建议
根据实际场景选择对应架构:
| 场景 | 存算一体 | 存算分离 |
|---|---|---|
| 开发测试环境,快速体验 | ✓ | |
| 缺乏共享存储条件(HDFS/Ceph/对象存储) | ✓ | |
| 无专职 DBA,多团队独立维护 | ✓ | |
| 无需弹性扩缩容、Kubernetes 容器化 | ✓ | |
| 已有公有云部署 | ✓ | |
| 有可靠共享存储系统 | ✓ | |
| 需要 Kubernetes 容器化或私有云弹性 | ✓ | |
| 多计算组共享数据场景 | ✓ | |
| 有专职平台团队维护 | ✓ |
核心技术模块
存储引擎
列式存储与压缩
数据按列组织,仅读取查询涉及的列,减少 I/O。配合字典编码、位图压缩、RLE 等算法,实现高压缩率。
索引结构
| 索引类型 | 适用场景 |
|---|---|
| 排序复合键(最多 3 列) | 高并发报表裁剪 |
| Min/Max | 数值类型等值/范围过滤 |
| BloomFilter | 高基数列等值过滤 |
| 倒排索引 | 任意字段快速搜索、全文检索 |
数据模型
| 模型 | 特性 | 适用场景 |
|---|---|---|
| 明细模型(Duplicate) | 保留明细数据 | 事实表明细存储 |
| 主键模型(Primary Key) | 主键唯一,相同主键覆盖 | 行级更新 |
| 聚合模型(Aggregate) | 相同主键自动聚合 | 预聚合加速 |
查询引擎
MPP 分布式查询
复杂查询分解为多阶段,在多个 BE 节点并行处理。支持分布式 Shuffle Join,高效处理大表关联。
向量化执行
列式内存布局 + SIMD 指令,宽表聚合性能 5~10x 提升。
Pipeline 执行引擎
多核并行 + 线程数限制,避免线程爆炸。减少算子间数据拷贝和内存分配开销。
查询优化器
| 优化器 | 策略 |
|---|---|
| RBO | 常量折叠、子查询改写、谓词下推 |
| CBO | 成本评估、Join 重排序 |
| HBO | 历史查询加速重复查询 |
Runtime Filter
运行时动态生成 Filter,下推到扫描节点,减少待处理数据量。支持 In/Min/Max/BloomFilter 类型。
高可用机制
多副本与 Quorum 协议
- 默认 3 副本存储
- 写入需多数派(如 2 副本)确认成功
- 部分节点故障不丢数据,集群仍可服务
故障自动隔离
- 检测节点心跳超时或副本损坏
- 标记节点不可用,停止分发任务
- 从健康副本自动补齐缺失副本
- 恢复后自动同步增量数据
FE 高可用
Paxos 类共识协议保证元数据一致性。Master 故障时 Follower 自动选举新 Master,对用户透明。
常见问题
Q: 存算一体和存算分离架构的核心区别是什么?
存算一体架构中,BE 节点同时负责数据存储和计算,数据存储在本地磁盘;存算分离架构中,数据存储在共享存储层(如 S3、HDFS),BE 节点仅作为无状态计算节点,通过本地缓存加速查询。存算分离支持计算资源和存储资源独立弹性扩缩。
Q: 什么时候应该选择存算分离架构?
存算分离适用于以下场景:已有公有云部署、需要 Kubernetes 容器化、有可靠共享存储系统(HDFS/Ceph/对象存储)、需要多计算组共享数据、有专职平台团队维护。对于简单使用或开发测试环境,存算一体更为合适。
Q: 存算分离架构中 BE 节点是否存储数据?
存算分离架构中,BE 节点是无状态的,不持久存储数据本身。但 BE 节点会使用本地 SSD 缓存热点数据(采用 LRU 淘汰策略),以克服对象存储随机读性能较差和网络传输开销带来的延迟问题。
Q: FE 在存算分离架构中的角色是什么?
FE 在存算分离架构中依然保留,主要负责用户请求接入、SQL 解析与规划、SQL 层元数据管理(库表结构、用户权限、集群拓扑)。数据层面的元数据管理(如 Tablet 元数据、Rowset 元数据)由新增的 Meta Service 承担。
Q: Doris 的高可用是如何实现的?
Doris 通过多副本 + Quorum 协议实现高可用:每个 Tablet 默认 3 副本,写入需多数派确认。部分节点故障时自动隔离并从健康副本补数据。FE 通过 Paxos 类共识协议保证元数据一致性,Master 故障时自动选举新 Master。
Q: 存算分离架构中 Meta Service 的作用是什么?
Meta Service 是存算分离架构中专门负责数据层面元数据管理的无状态服务,职责包括:数据导入事务处理(版本管理、冲突检测)、Tablet/Rowset 元数据管理、计算组资源分配和调度。由于是无状态服务,可水平扩展以提升元数据处理能力。
总结
Apache Doris 提供两种架构以适应不同需求:
| 架构 | 适用场景 |
|---|---|
| 存算一体 | 性能优先、运维资源有限、规模可控 |
| 存算分离 | 云原生、弹性伸缩、多团队共享数据 |
两种架构均提供完整高可用机制,确保数据可靠性和服务稳定性。
